
从“思考”到“行动”:自主 AI Agent 演进全景图 (2025 综述)
From LLM Reasoning to Autonomous AI Agents: A Comprehensive Review
2025-01-01
总结
问题
方法
结果
要点
摘要
本文是一篇关于大语言模型(LLM)推理能力向自主 AI Agent 演进的综述报告。文章系统梳理了 2019-2025 年间的 60 多个评估基准(Benchmarks)、核心开发框架(如 LangChain, CrewAI)、多智能体协作协议(MCP, A2A)以及在医疗、金融、科研等领域的广泛应用。
TL;DR
大语言模型(LLM)正经历从简单的“对话框”向“自主行动实体(Agents)”的质变。本文通过深入分析 2019 年至 2025 年的 60 多个 Benchmark 和数十个框架,揭示了 Agent 技术的逻辑心脏:推理(Reasoning)+ 工具调用(Tool Use)+ 协作协议(Protocols)。相比单纯的模型微调,Agentic Workflow(智能体工作流)已成为提升模型解决复杂现实问题上限的关键。
痛点深挖:为何 MMLU 高分不再等于“智能”?
学术界正面临一个尴尬的现状:现有的基准测试(如 MMLU)已经饱和,模型得分动辄 90+,但在实际处理医疗诊断或软件重构时依然频频“翻车”。
- 静态知识的局限:传统 LLM 依赖预训练权重,无法处理实时变动的外部信息。
- 逻辑链路的断裂:多步推理极易产生幻觉累积(Chain-of-Hallucination)。
- 评估真空:缺乏衡量 Agent 在数字环境中与 API 和 GUI 交互能力的统一尺度。
核心方法论:Agentic AI 的架构解析
作者提出,一个真正的自主 Agent 由以下核心模块驱动:
- 计划(Planning):将复杂目标分解为 Atomic Steps,并能进行自我反思(Self-reflection)。
- 记忆(Memory):包括短期上下文和基于 RAG 的长期知识存储。
- 执行(Execution):通过工具(Tools/APIs)或操作 GUI 直接改变物理或数字世界。
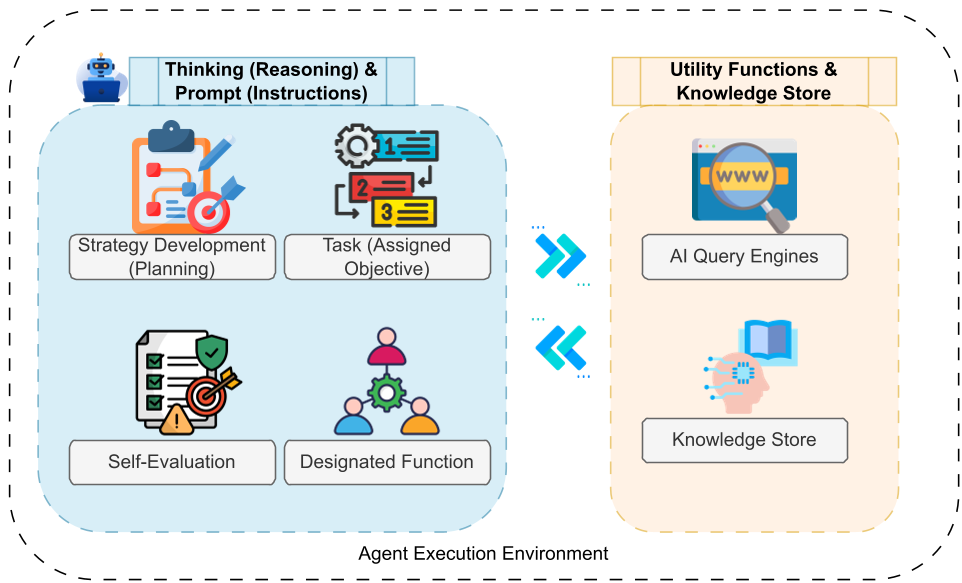
智能体工作流的范式转移
- Agentic RAG:不再是简单的“检索-回答”,而是引入了“多轮重写查询”、“评估检索相关性”和“迭代纠火”循环。
- 推理时缩放(Inference-time Scaling):如 DeepSeek-R1 或 OpenAI o1,通过在推理阶段分配更多算力(思维链),显著拉升逻辑任务性能。
基准测试的“军备竞赛”
为了测量 Agent 的真实实力,2024-2025 年涌现了一批“极难”基准:
- HLE (Humanity's Last Exam):涵盖 100 多个学科的专家级问题,SOTA 模型准确率竟不足 10%。
- SWE-Lancer:利用真实 Upwork 悬赏任务,评估 Agent 解决真实软件工程并“赚钱”的能力。
- ENIGMAEVAL:通过复杂的视觉-语义逻辑解谜,测试多模态深度推理。
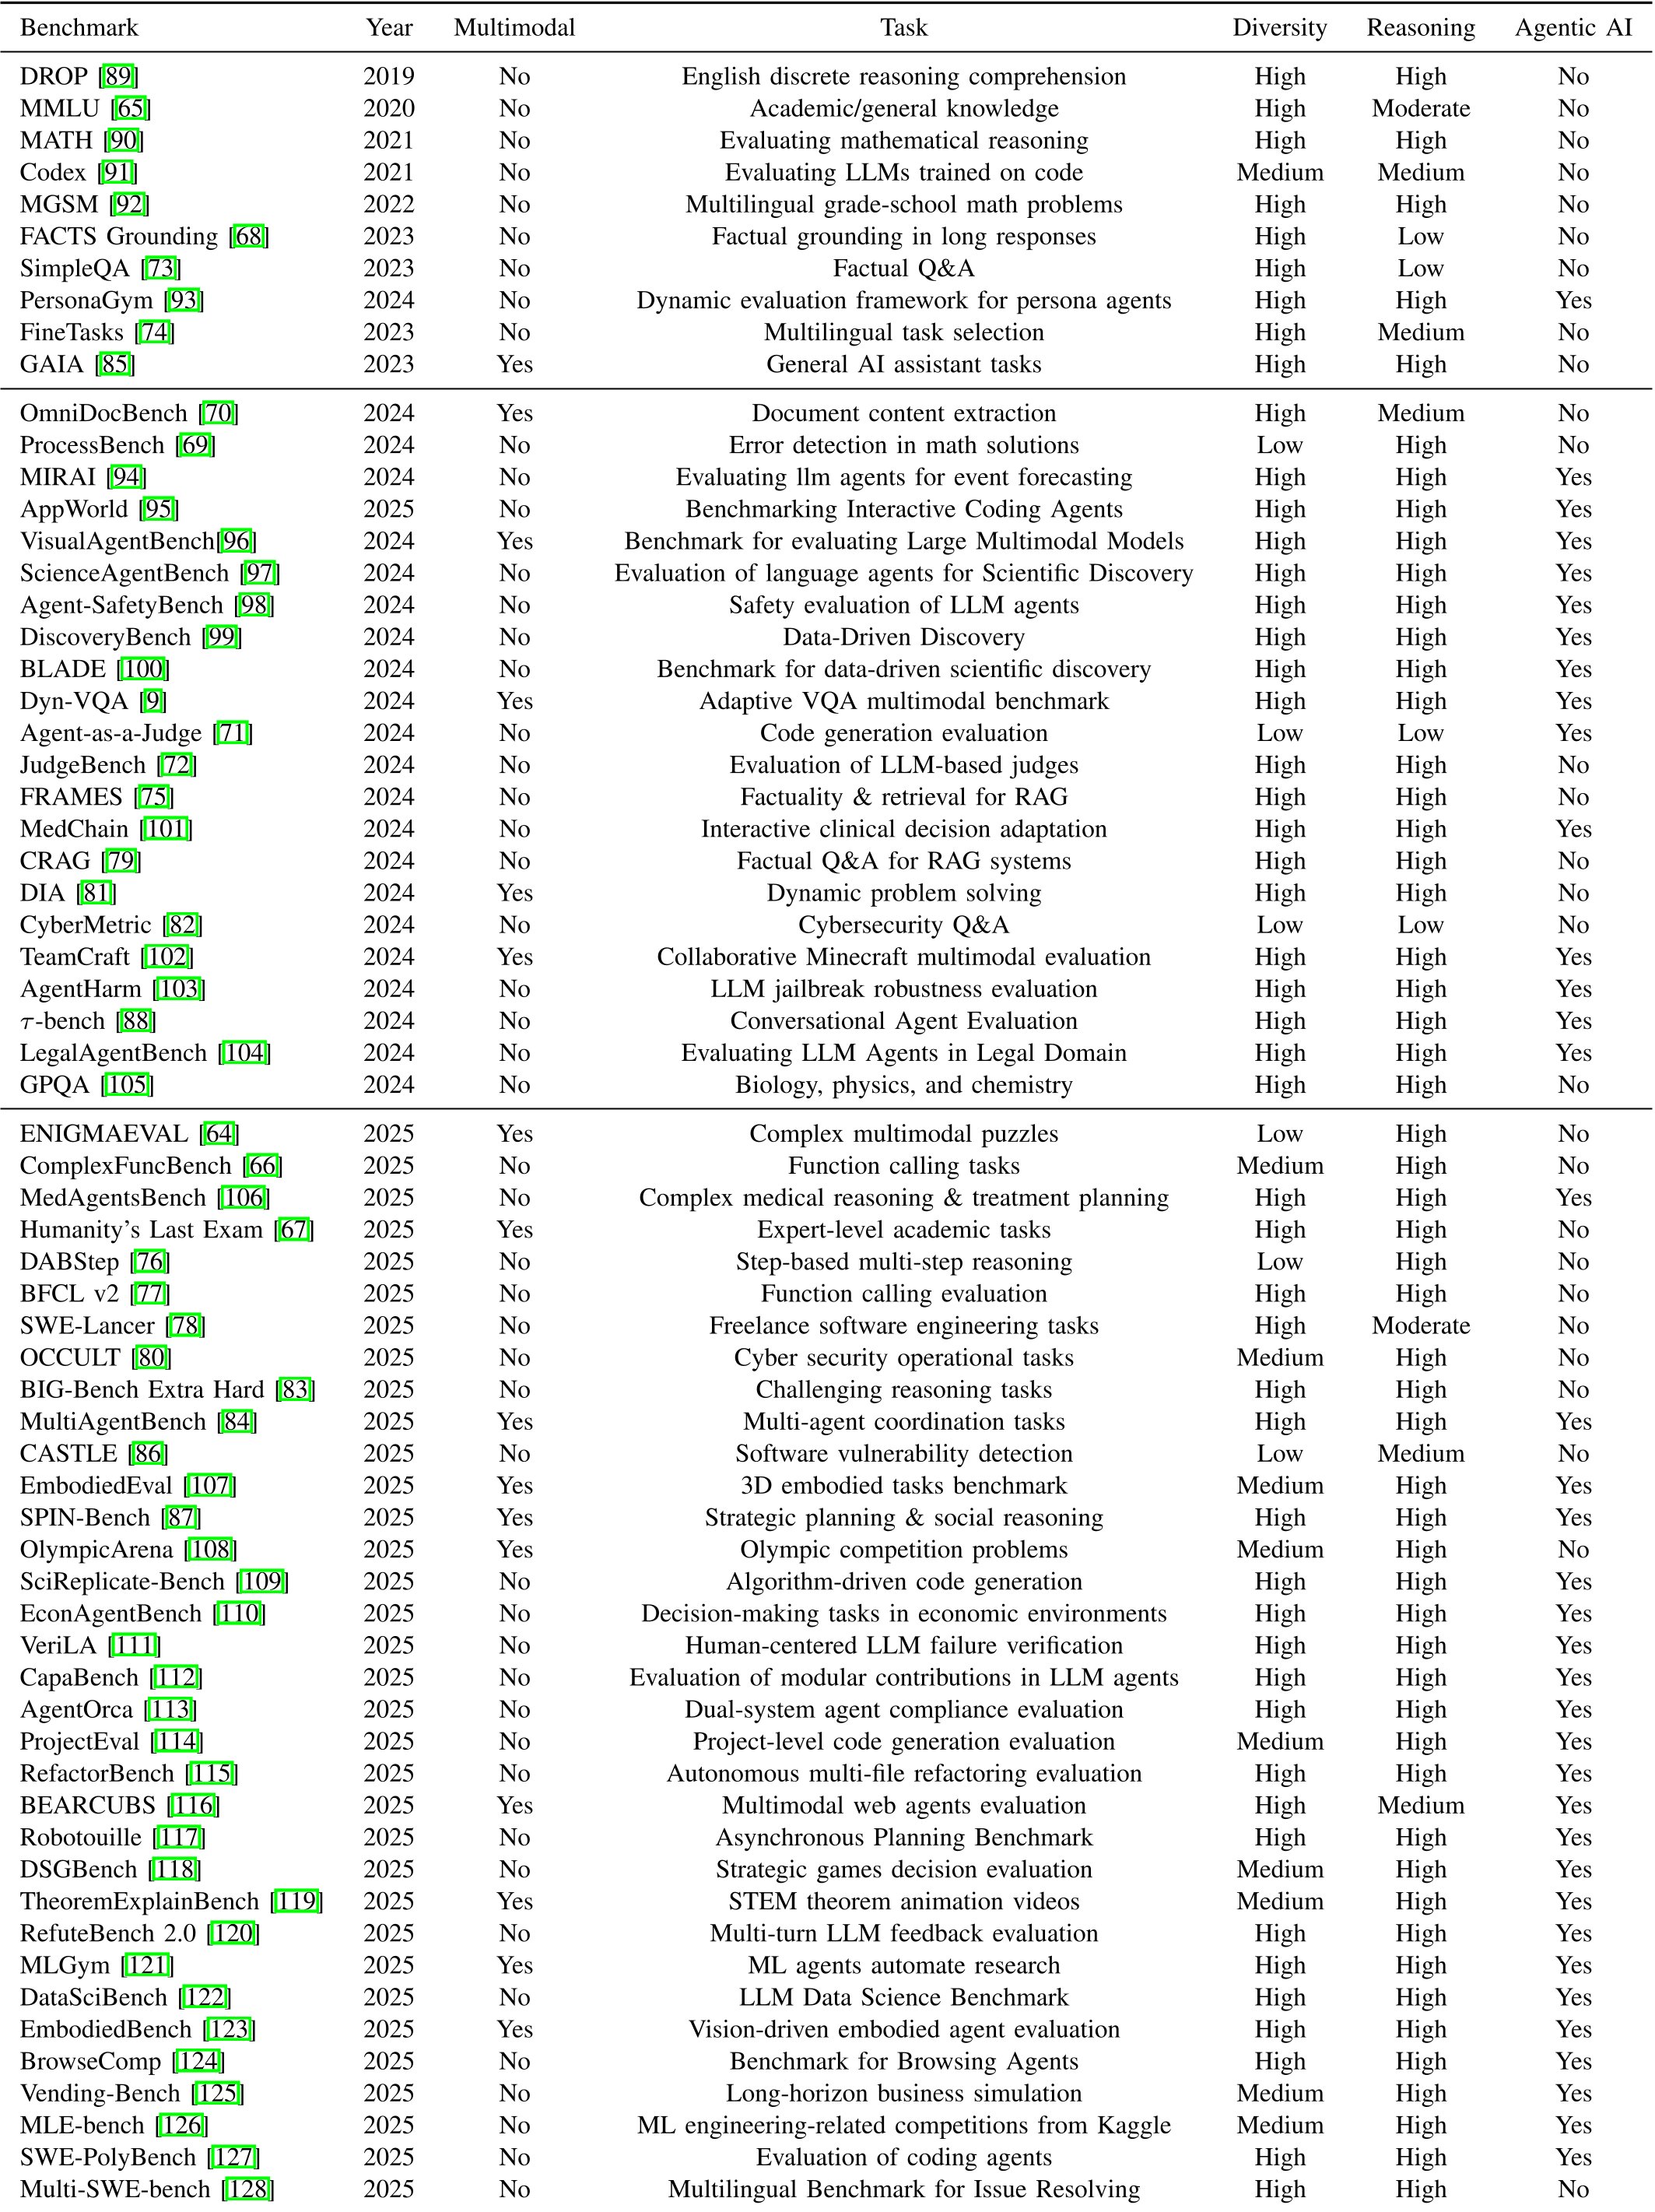
协作协议:AI 界的“USB-C”时代
Agent 的孤岛化是商业化的最大障碍。文中重点讨论了三个具有里程碑意义的协议:
- MCP (Model Context Protocol):由 Anthropic 推出,将数据源与模型解耦,实现即插即用的上下文集成。
- A2A (Agent-to-Agent):Google 推出的跨框架协作协议,允许 CrewAI、LangChain 等不同平台的 Agent 进行任务握手和资源交换。
- ACP (Agent Communication Protocol):IBM 针对本地多智能体环境提出的标准消息格式。
深度洞察与总结
价值评估 (Takeaways)
- 推理的系统化:未来的 SOTA 不仅仅是参数量,而是如何通过强化学习逻辑(RL for Reasoning)让模型学会“思考”和“纠错”。
- 领域垂直化:如 BioKGBench 或 FinSphere 所示,通用模型正在向医疗、金融等具备高语义密度的领域 Agent 进化。
- 协作即服务:Agent-to-Agent 的互操作系统将成为下一代互联网的底层架构,Agent 将取代 API 成为服务调用的首选接口。
局限性与展望
尽管前景光明,但多智能体系统的**失败模式(Failure Modes)**依然难以预测,特别是“过度对齐导致的重复循环”和“工具调用的安全漏洞”。未来的研究不仅要让 Agent “更聪明”,更要让其“在复杂的博弈环境中保持可信(Trustworthy)”。
总结一句话:AI 的下半场,不在于它能说多少话,而在于它能办成多少事。