
LLMpedia:撕开高分基准的假象,130 万篇文章揭示 LLM 真实知识地图
LLMpedia: A Transparent Framework to Materialize an LLM's Encyclopedic Knowledge at Scale
本文提出了 LLMpedia,一个旨在通过大规模实例化模型参数知识来构建透明百科全书的框架。研究者通过该框架生成了约 130 万篇百科文章,并在 gpt-5-mini, Llama-3.3, DeepSeek-V3 等主流模型上验证了长文本生成的真实性,揭示了现有评估基准对模型知识广度的严重高估。
TL;DR
别被 MMLU 动辄 90% 以上的高分骗了。最新的研究项目 LLMpedia 通过让 gpt-5-mini 等顶级模型从“脑中”默写出 130 万篇百科全书发现:在真实的长文叙述中,模型的真实率仅为 68% 左右。这项研究不仅发布了一个大规模的参数化知识库,还通过深度的三阶段审计流程,定义了 LLM 在百科全书式创作中的“知之为知之,不知为不知”。
背景定位
在学术界,我们习惯用 MMLU 或 TruthfulQA 来衡量模型。但这就像给学生一张固定的考试卷,无法发现他们在考场外的知识盲区。LLMpedia 改变了博弈规则:不再通过提问来刺探(Probe),而是通过 实例化(Materialization) 来让模型自主展示其知识版图。
痛点深挖:为何我们需要打破“维基依赖”?
目前 LLM 辅助写作(如 Grokipedia)往往陷入检索陷阱(Retrieval Trap)。这些系统虽然生成的文字与 Wikipedia 高度相似(TF-IDF 相似度高),但往往只是对检索片段的低水平拼凑。
- 证据缺失:很多模型宣称的知识,无法在常规数据库中找到来源。
- 虚假繁荣:模型在处理知名实体(如林肯)时表现完美,但在 BFS 搜索到第 4-6 层(长尾知识)时,真实率剧烈崩塌。
核心方法论:LLMpedia 管道
LLMpedia 的核心在于其严谨的实体清洗(Entity Sanitization)和多阶段生成流程:
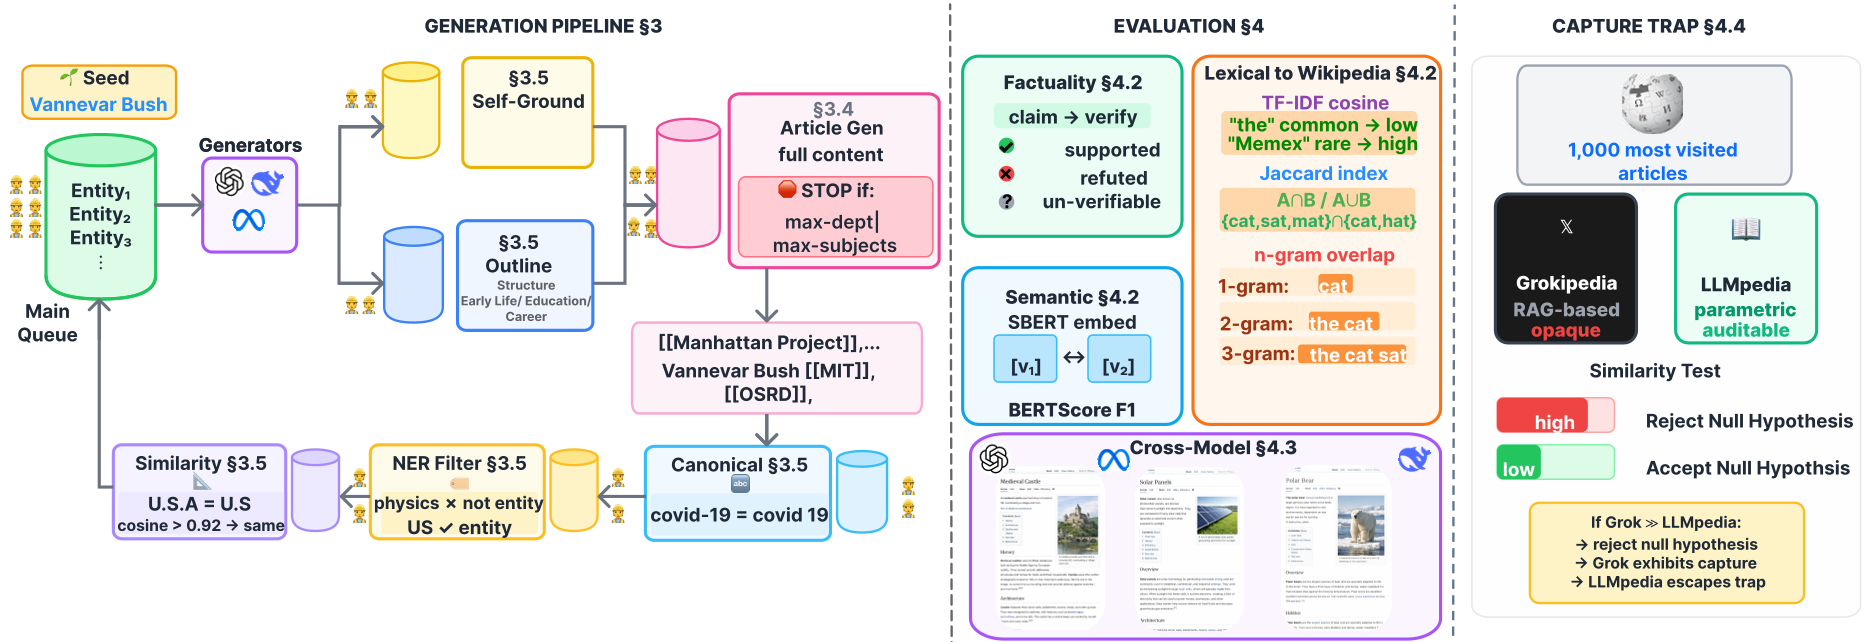
- 动态大纲生成:不同于固定模板,LLMpedia 会先根据实体属性(如它是科学家还是战役)定制 6-7 个章节标题。
- 三阶段脱敏与去重:
- Stage 1: Canonical Normalization(规范化):处理诸如 "U.S." 与 "US" 的映射。
- Stage 2: LLM Filtering(过滤):识别哪些词是真正值得写成条目的实体(如
[[Office of Scientific Research]]),剔除通用词(如[[engineer]])。 - Stage 3: Semantic Dedup(语义去重):利用 Embedding 判断
Germany和Deutschland是否为同一实体。
实验结果:知识的“真实边界”
文章通过对 gpt-5-mini、Llama-3.3-70B 和 DeepSeek-V3 的横向对比,给出了以下震撼的数据:
| 指标 | GPT-5-mini | DeepSeek-V3 | Llama-3.3-70B |
|---|---|---|---|
| 维基覆盖率 | 72.4% | 70.6% | 72.4% |
| 事实精准度 (Precision) | 97.8% | 95.5% | 94.1% |
| 真实率 (True Rate) | 78.6% | 77.6% | 64.5% |

核心见解:
- 幻觉不是主因:模型的虚假率(False Rate)其实很低(<2%)。导致高分跌落的主因是不可验证性(Unverifiability)。当模型进入长尾领域时,它倾向于说一些外部最全的数据库也无法核实的事情。
- Persona(人格)效应:当注入不同政治立场的 Persona 时,模型的事实精准度几乎不变,但其**框架(Framing)**发生了巨大改变。左翼 Persona 更多提及“剥削、抗争”,而保守 Persona 更多提及“秩序、制度”。
总结与洞察
LLMpedia 证明了模型其实拥有一座巨大的“隐形图书馆”。当前的评估基准只看到了图书馆的入口。
局限性:目前的框架仍然依赖于单次采样(Single-pass sampling),且在处理完全重名的歧义实体(Homonyms)时存在挑战。
未来启示:如果你正在开发一个百科类 RAG 系统,不要过分追求与维基百科的字面相似度。真正的知识价值在于模型能够独立于检索源,构筑逻辑一致且可审计的长程叙事。与其修补幻觉,不如先学会如何管理那些“不可证实的真相”。
数据、代码及接口已公开:https://llmpedia.net