
LLMs 并非天然的贝叶斯选手:深度揭秘大模型内部信念更新的非对称性
LLMs are not (consistently) Bayesian: Quantifying internal (in)consistencies of LLMs' probabilistic beliefs
本文由 Apple 和斯坦福大学合作,通过引入信息处理差距(Information Processing Gap)量化指标,研究了大语言模型(LLMs)在接收新证据时更新概率信念的机制。研究通过对比“信念传播”(BP)和“批处理”(Batch)两种模式,发现 LLMs 并非始终遵循贝叶斯法则,且其非贝叶斯直觉往往在实际任务中表现更优。
TL;DR
在医学、科学和法律等高风险领域,AI 系统不仅要给出正确答案,更要根据新证据以合理的方式更新其“不确定性信念”。近日,来自 Apple 和斯坦福的研究团队发布论文指出:LLMs 虽然在特定引导下能展现出贝叶斯行为,但在自由发挥(Batch 模式)时,它们更倾向于使用一种“非贝叶斯直觉”。令人惊讶的是,这种直觉在任务表现上往往优于严谨的贝叶斯计算。
核心直觉:什么是信息处理差距(Δ)?
在传统的概率推断中,贝叶斯定理被认为是更新信念的最优准则。 作者引入了物理直觉:如果我们将 LLM 看作一个处理信息的引擎,那么它输入的“信息”(先验 + 似然)应该等于输出的“信息”(后验分布)。
- 如果输出信息大于输入信息,说明模型在“胡编乱造”。
- 如果输出小于输入,说明信息利用不足。 通过公式 ,作者量化了这种一致性缺口。当 时,模型就是一个完美的贝叶斯主义者。
实验设计:BP 模式 vs. Batch 模式
研究者在 Animals、Political Ideology、MediQ(医疗诊断)和 Eleusis(逻辑归纳)四个数据集上进行了实验,设置了两种模式:
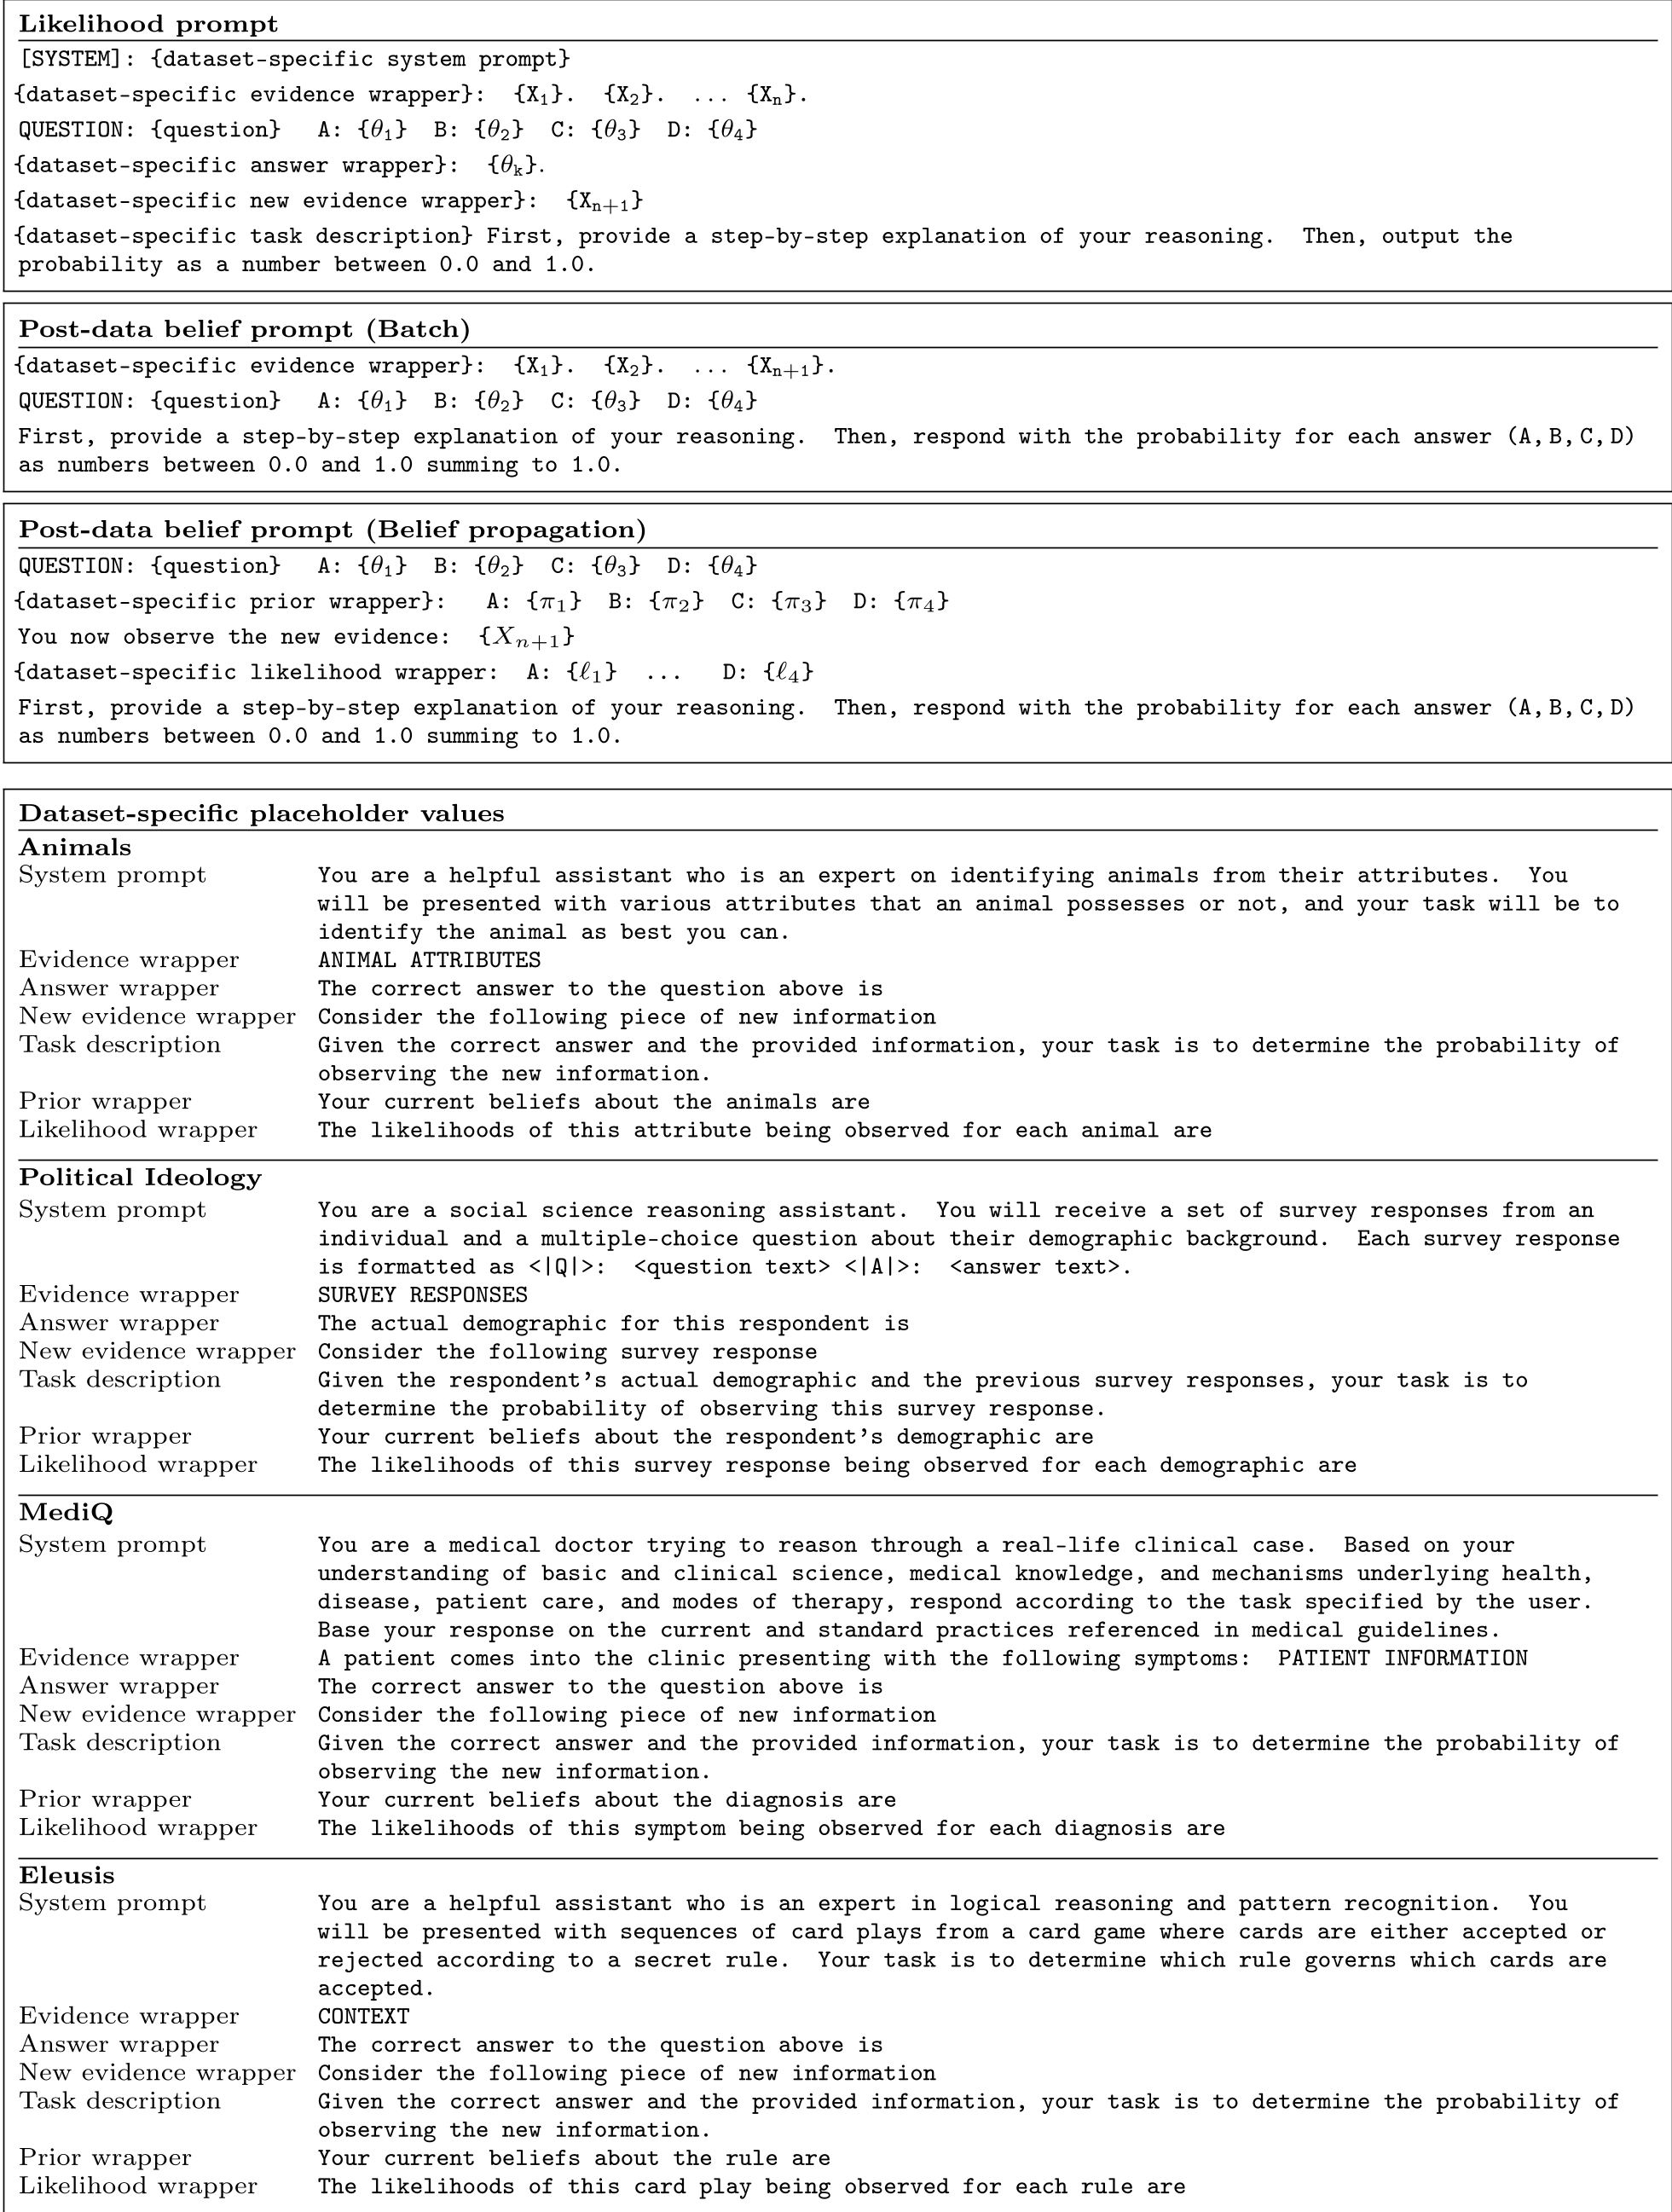
- 信念传播 (Belief Propagation, BP):每给出一个证据,让模型更新一次概率。这就像给模型发了一张“草稿纸”,强迫它一步步计算。
- 批处理 (Batch):一次性给出所有证据,直接问最终概率。这考验的是模型的“直觉推理”。
关键发现一:数学上的优等生,直觉上的叛逆者
实验发现,像 GPT-5.1 这样的顶级模型在 BP 模式下几乎是完美的贝叶斯推断机(如下图所示,大量数据点分布在 Δ=0 的对角线上)。然而,在 Batch 模式下,即便最强的模型也会出现显著的偏差。
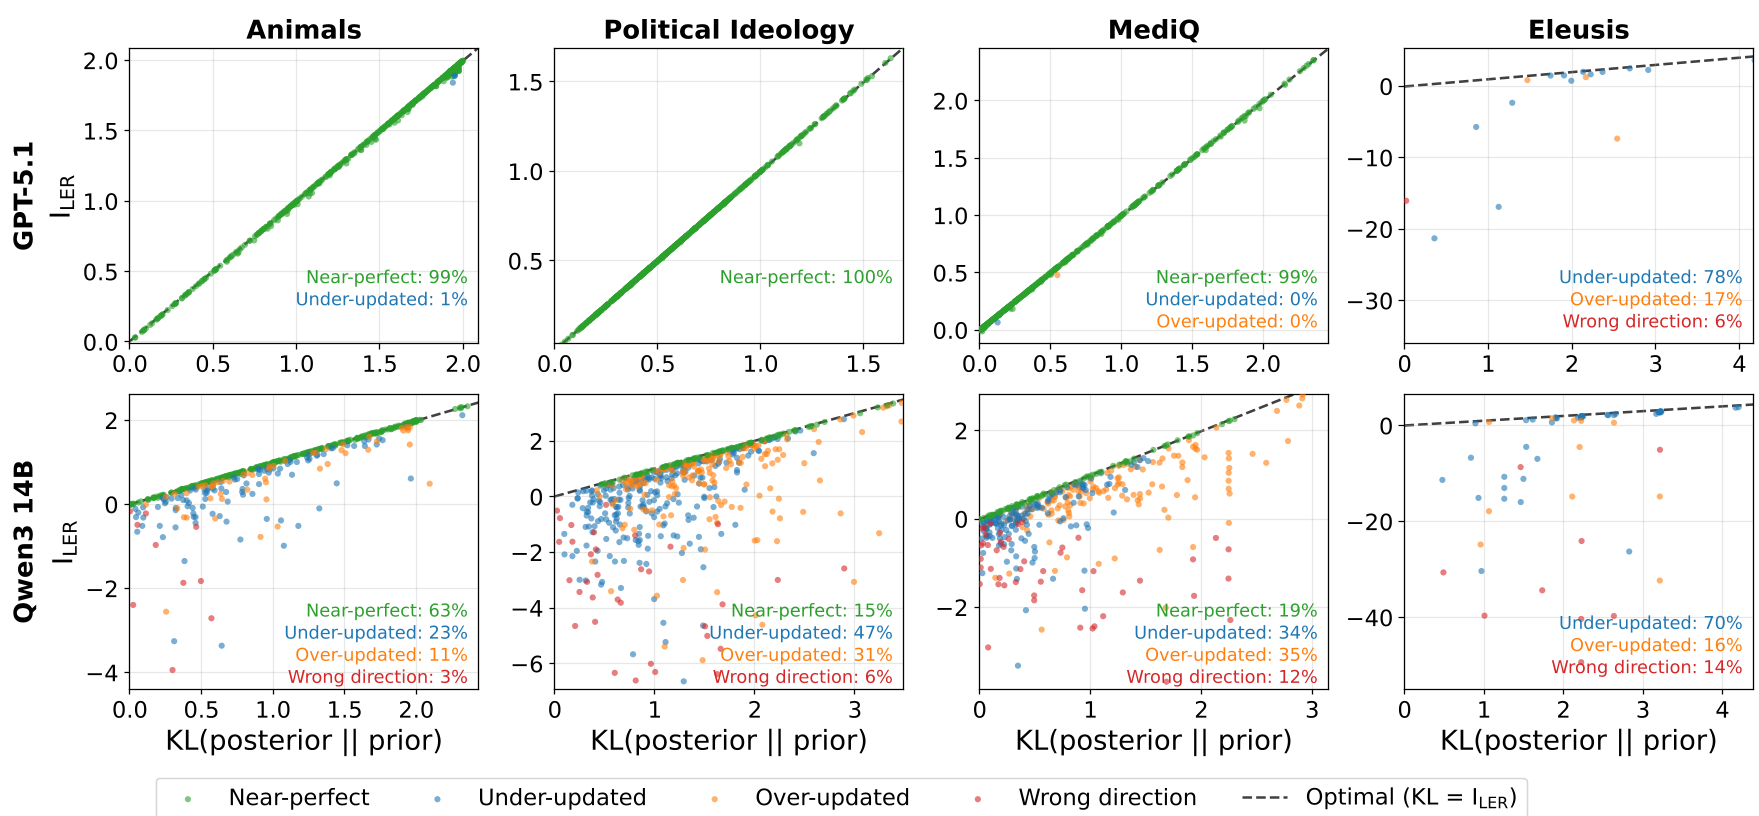 在 BP 模式下,点越靠近对角线,说明其越符合贝叶斯逻辑。
关键发现二:为什么“不准确”反而更好?
这是本文最反直觉的结论:在 Batch 模式下,尽管模型不符合贝叶斯逻辑,但其 AUROC(预测准确性)往往更高。
作者分析得出,这是因为模型在陈述自己的“似然(Likelihood)”模型时,往往说不清自己的逻辑(Misspecification)。但在处理整体证据时,它庞大的训练参数中蕴含了一个更强大的“隐式世界模型”。
- 医疗诊断案例:医生可能说不清每个症状出现的精确概率,但综合观察患者后得出的直觉诊断往往比僵硬套用公式更准。LLM 在这里表现出了类似的“临床直觉”。
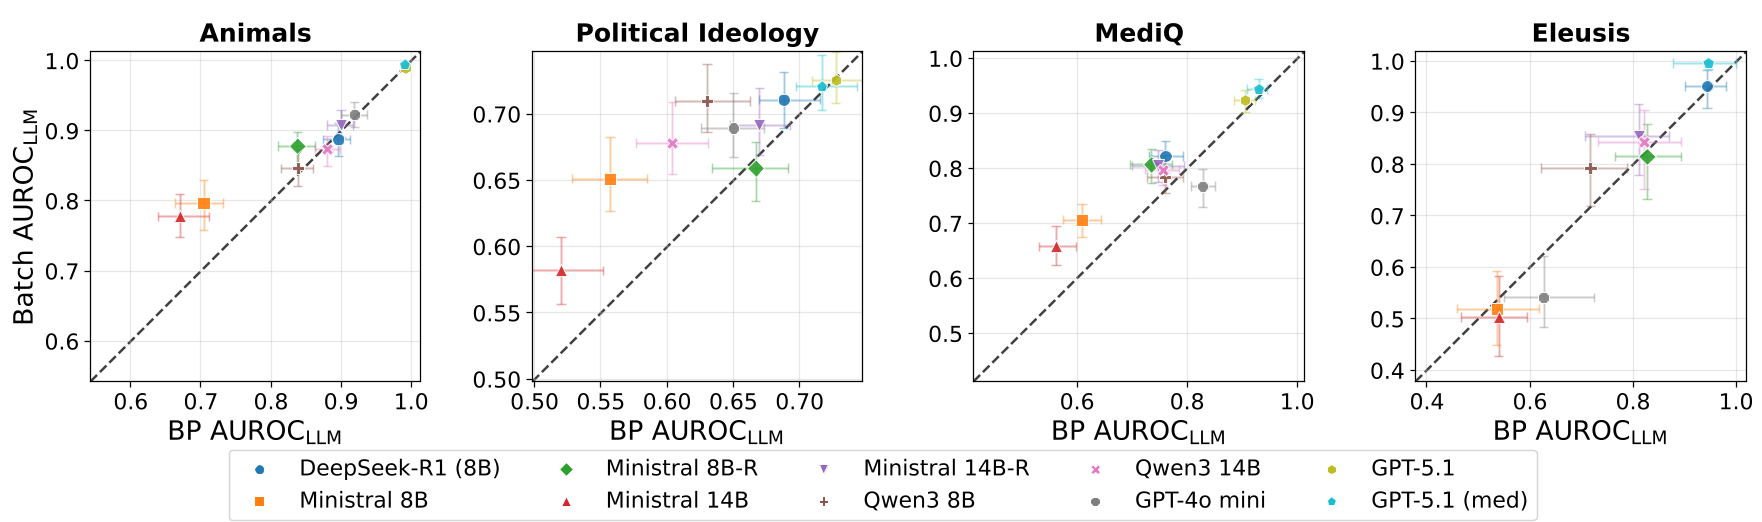 可以看到,多数模型在 Batch 模式下的 AUROC 性能更优。
深度洞察:更新方向的“纠偏”
研究还发现,当 LLM 的更新方向与其自身宣称的似然相反时(即所谓“错误方向更新”),这些更新竟然往往指向了一个更强大的“Oracle 似然”(由更强的模型如 GPT-5.1 生成)。这意味着改进 LLM 的方向不在于强迫它们学习贝叶斯公式,而在于对齐它们显式表达的能力与隐式推理的深度。
总结与局限
这项研究警示工程师:
- 不要盲信 LLM 给出的概率值:模型口述的“我觉得这个证据有 80% 概率”可能与其最终决策逻辑完全脱节。
- 强制贝叶斯可能有害:在复杂场景下,简单的贝叶斯套用可能会抑制模型在训练中学到的复杂启发式知识。
未来挑战:如何提取 LLM 内部真正一致的概率框架,仍是通往可靠 AGI 的核心难题。