
定位、引导与改进:大语言模型机理可解释性的行动指南
Locate, Steer, and Improve: A Practical Survey of Actionable Mechanistic Interpretability in Large Language Models
本文提出了一套名为“定位、引导与改进”(Locate, Steer, and Improve)的实用框架,旨在将机理可解释性(Mechanistic Interpretability, MI)从单纯的观察性科学转化为可干预的模型优化方法。该综述系统归纳了针对大语言模型(LLM)的诊断与干预技术,并在对齐安全、能力增强及效率提升等多个 SOTA 场景中验证了其行动力价值。
TL;DR
如果将大语言模型(LLM)比作一个黑盒,那么“机理可解释性”(Mechanistic Interpretability, MI)正试图从“看客”向“手术医生”进化。本文不再仅仅讨论 LLM 的内部神经元长什么样,而是提出了一套Locate-Steer-Improve的实战流水线,教你如何精确找到问题单元、实时干预模型走向,并最终实现参数级的永久改进。
背景定位:从观察到干预的跨越
以往的 MI 研究常被视为一种“观察性科学”,类似于天文学家观察恒星。虽然我们知道了“感叹号神经元”或“归纳头”的存在,但如何利用它们修复模型的幻觉?如何利用它们让模型更安全?本文通过系统化的框架,将 MI 重新定义为一种干预性工程学科,强调“从模型内部进行改进(Improving from the inside)”。
1. 核心方法论:三阶进化流水线
作者将整个流程拆解为三个步骤,逻辑严密地回答了“ Why -> How -> Improvement”的问题:
第一阶段:定位 (Locate) —— 寻找“责任人”
要在数以千亿计的参数中找到负责某个特定任务(如:性别歧视或法语翻译)的单元,论文归纳了四种核心手段:
- 因果归因 (Causal Attribution):通过 Patching(修补)实验,观察替换某个激活值后输出的变化,这是判定因果律的金标准。
- 梯度检测 (Gradient Detection):利用一阶导数快速筛选敏感单元,效率极高。
- 稀疏自编码器 (SAE):这是近年来的明星技术,它像显微镜一样,将重叠纠缠的特征(Superposition)拆解为纯洁的单义特征(Monosemantic concepts)。
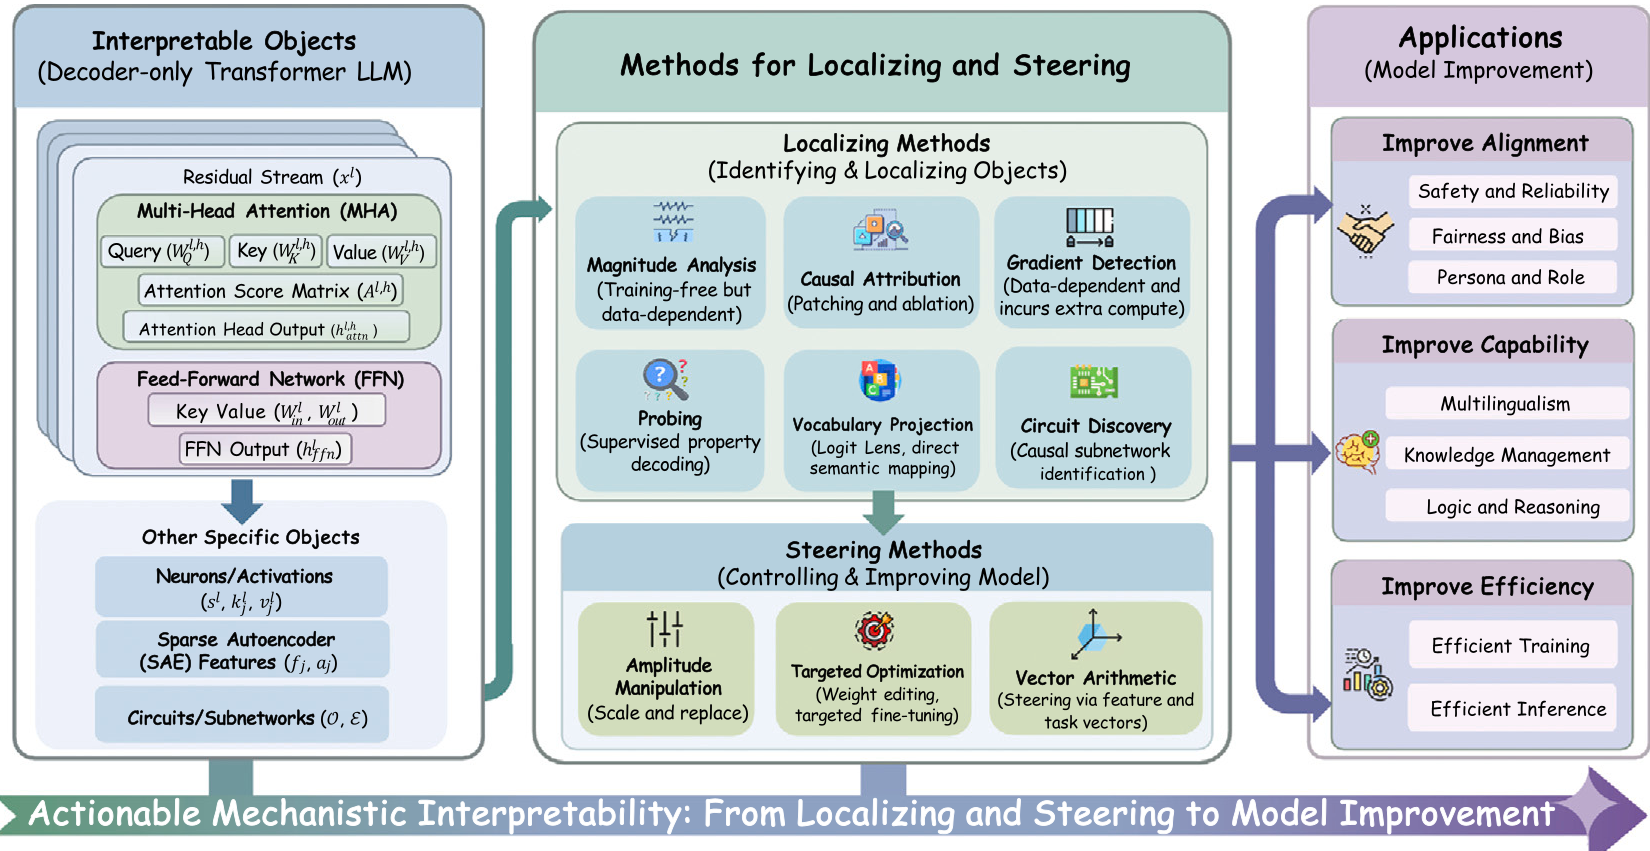 上图展示了从定义对象到最终改进模型的完整逻辑闭环。
第二阶段:引导 (Steer) —— 实时干扰
一旦找到了“目标特征”,我们就可以在推理时进行干预:
- 幅度操纵 (Amplitude Manipulation):直接把某个坏神经元的激活强度设为 0。比如,关掉“法语神经元”,模型就会乖乖说英语。
- 向量算术 (Vector Arithmetic):在残差流(Residual Stream)中加上“诚实向量”,让模型在不改变参数的情况下变得更诚实。
第三阶段:改进 (Improve) —— 永久重塑
这是最终目标,通过定向优化 (Targeted Optimization),仅更新那些被定位到的少数参数,实现“外科手术式”的模型微调,既解决了问题,又避免了“灾难性遗忘”。
2. 架构解析:残差流是“信息高速路”
论文深入剖析了 Transformer 的内部物理直觉。作者指出,**残差流(Residual Stream)**不仅仅是简单的连接,它是信息的共享内存,每个注意力头(Attention Head)和前馈网络(FFN)都在向这条高速公路“写入”或“读出”信息。
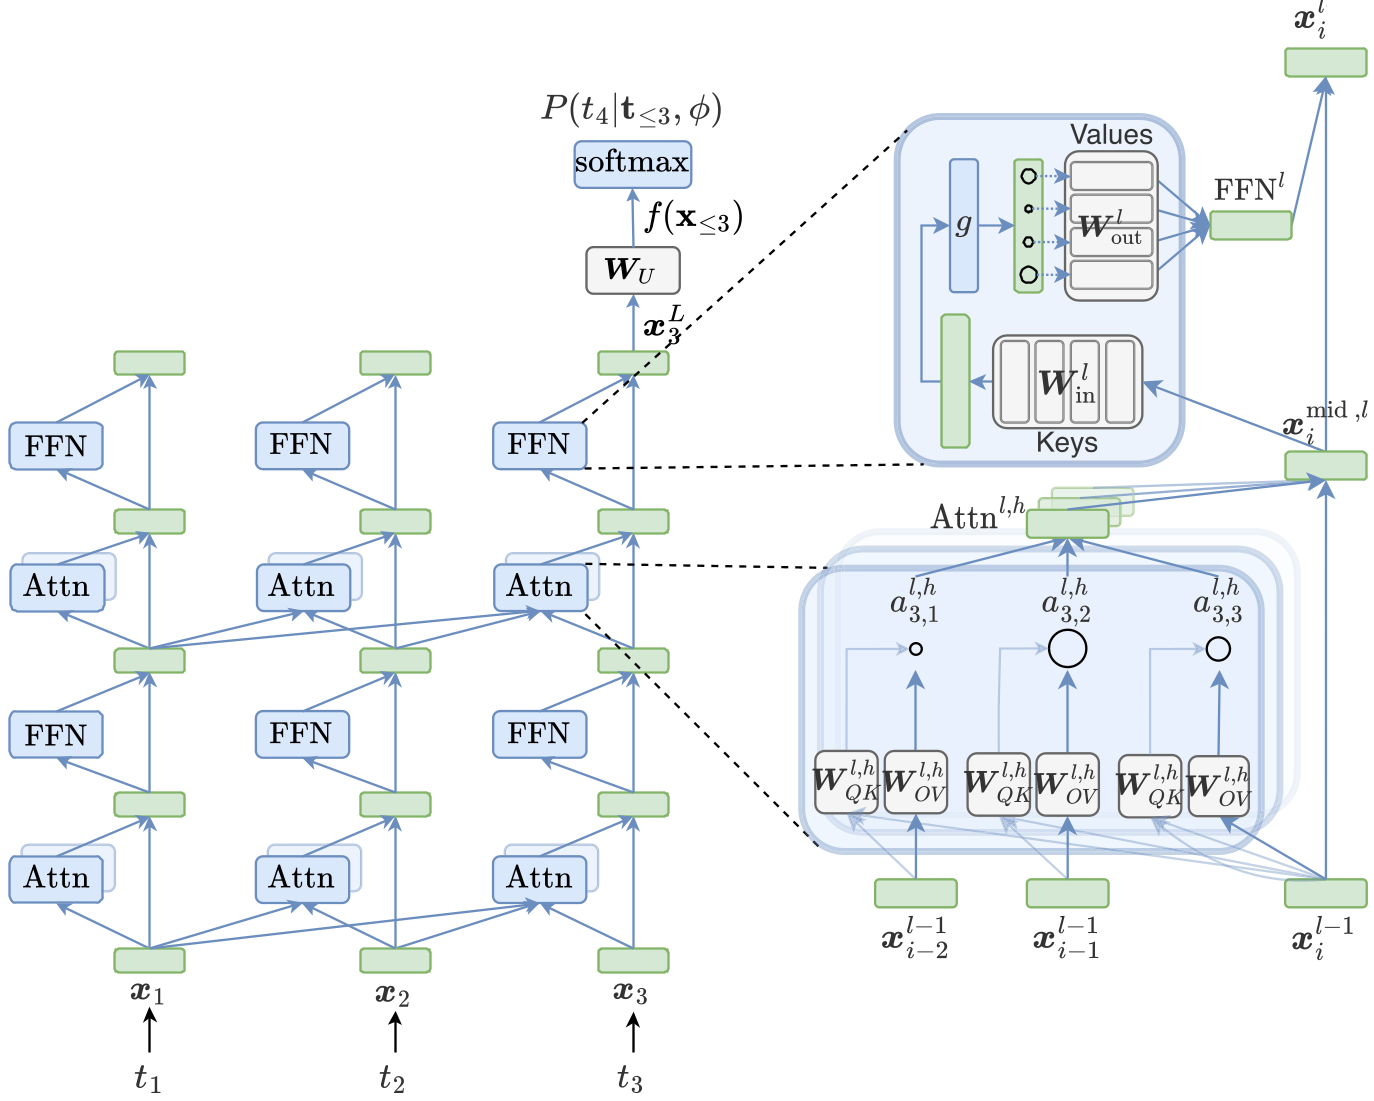 图示说明了 MHA 和 FFN 如何作为加性分支与残差流交互。
3. 实战案例:MI 能解决什么?
A. 对齐与安全:消除“毒性”
通过 SAE 定位到毒性特征后,研究者发现直接抑制这些特征的激活值(Amplitude Manipulation),可以比传统的拒绝提示词更彻底地消除有害输出,且不会导致模型变“傻”。
B. 知识重写:定向参数编辑
利用 Causal Tracing(如下图所示),我们可以定位事实(如“巴黎是大都市”)存储在哪些特定的 FFN 层。通过定向更新这一小块参数,我们可以实现精准的知识重写,而不会误伤其他知识。
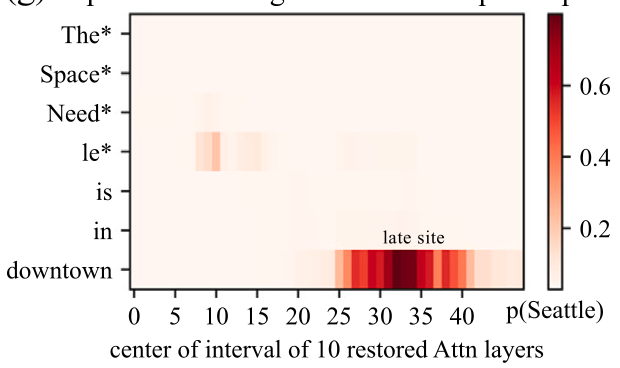 Causal Tracing 揭示了知识在早期 MLP 层提取,并在后期通过注意力传导。
C. 效率提升:1% 的奇迹
传统的全参数微调资源消耗巨大。而基于 MI 定位的稀疏微调 (Sparse Fine-tuning) 证明,仅针对特定的“语言敏感神经元”进行更新(参数占比 < 1%),在多语言翻译等任务上的表现甚至优于全参数微调。
4. 深度洞察与挑战
尽管框架很完美,但作者也直言不讳地指出了挑战:
- 可扩展性瓶颈:在 100B 以上的模型中,进行全局的因果追踪代价昂贵,SAE 的训练成本也随之暴增。
- 分布式表征 vs. 局部稀疏性:有些复杂逻辑可能分布在模型全局,强行进行局部“定位”可能会丢失关键信息。
- 副作用担忧:修改一个神经元是否会造成远距离的蝴蝶效应?目前的评估协议(如文中提出的最小化评估框架)仍需完善。
总结
这篇综述不仅仅是过去研究的罗列,它为大模型研究者提供了一份**“操作手册”**。随着 LLM 逐渐进入存量优化时代,这种“精准定位、定向干预”的机理可解释方法,将成为提升模型安全性与专业性的必经之路。
Takeaway: 想改进大模型?别再盲目加数据了,先用显微镜看看内部机制,再拿起手术刀精准提效。