
LongSeeker:弹性上下文编排,重塑长程搜索智能体的记忆
LongSeeker: Elastic Context Orchestration for Long-Horizon Search Agents
本文提出了 LongSeeker,一个旨在解决长程搜索智能体上下文管理难题的研究。核心方法是 Context-ReAct 范式,通过引入 5 种原子元操作(Skip, Compress, Rollback, Snippet, Delete)实现了对工作上下文的动态弹性编排,模型在 BrowseComp 等多个长程搜索基准上达到了 SOTA 水平。
TL;DR
在处理多步复杂任务时,传统的 AI 智能体往往被“历史记忆”压得喘不过气。上海交大团队提出的 LongSeeker 改变了这一现状:它不再机械地记录所有过程,而是通过一套名为 Context-ReAct 的新架构,学会了像人类一样“有选择地记忆、压缩、甚至撤回错误认知”。在挑战性的 BrowseComp 基准测试中,它以 30B 的参数量大幅超越了众多闭源模型和专业搜索智能体。
背景定位:Agent 的“信息过载”困境
目前的搜索智能体(如 OpenAI Deep Research 或各类 ReAct 定式的 Agent)大多遵循“追加模式”:每一步的工具结果、推理链路都无脑地塞进 Context。
- 痛点分析:随着任务步数增加,Context 中的噪声比(Signal-to-Noise Ratio)急剧下降,不仅推理成本激增,模型还容易被早期琐碎的观察信息误导(幻觉风险)。
- 现状局限:现有的滑动窗口截断(Sliding Window)容易丢掉关键信息;简单的总结(Summarization)又会损失数值、URL 等高精度细节。
核心动机:让上下文具备“弹性”
作者的直觉是:有效的上下文管理必须是自适应的。在长程搜索中,信息的保真度应该是“多分辨率”的:
- 刚搜到的证据需要全文保留以供验证;
- 已确定的中间结论可以抽象压缩;
- 某些关键数值(如代码、经纬度)需要精准截取;
- 走不通的死胡同应当直接回溯清空。
Context-ReAct:五大原子操作构建“超强记忆”
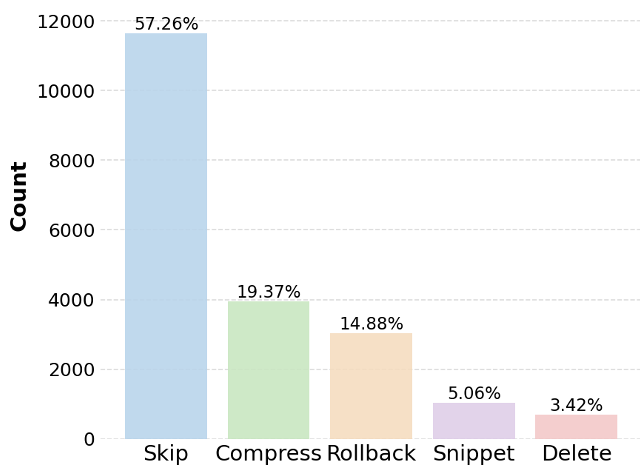
LongSeeker 将上下文管理直接整合进了模型生成的每一轮输出中,提出了 5 种核心元操作(Meta-Operations):
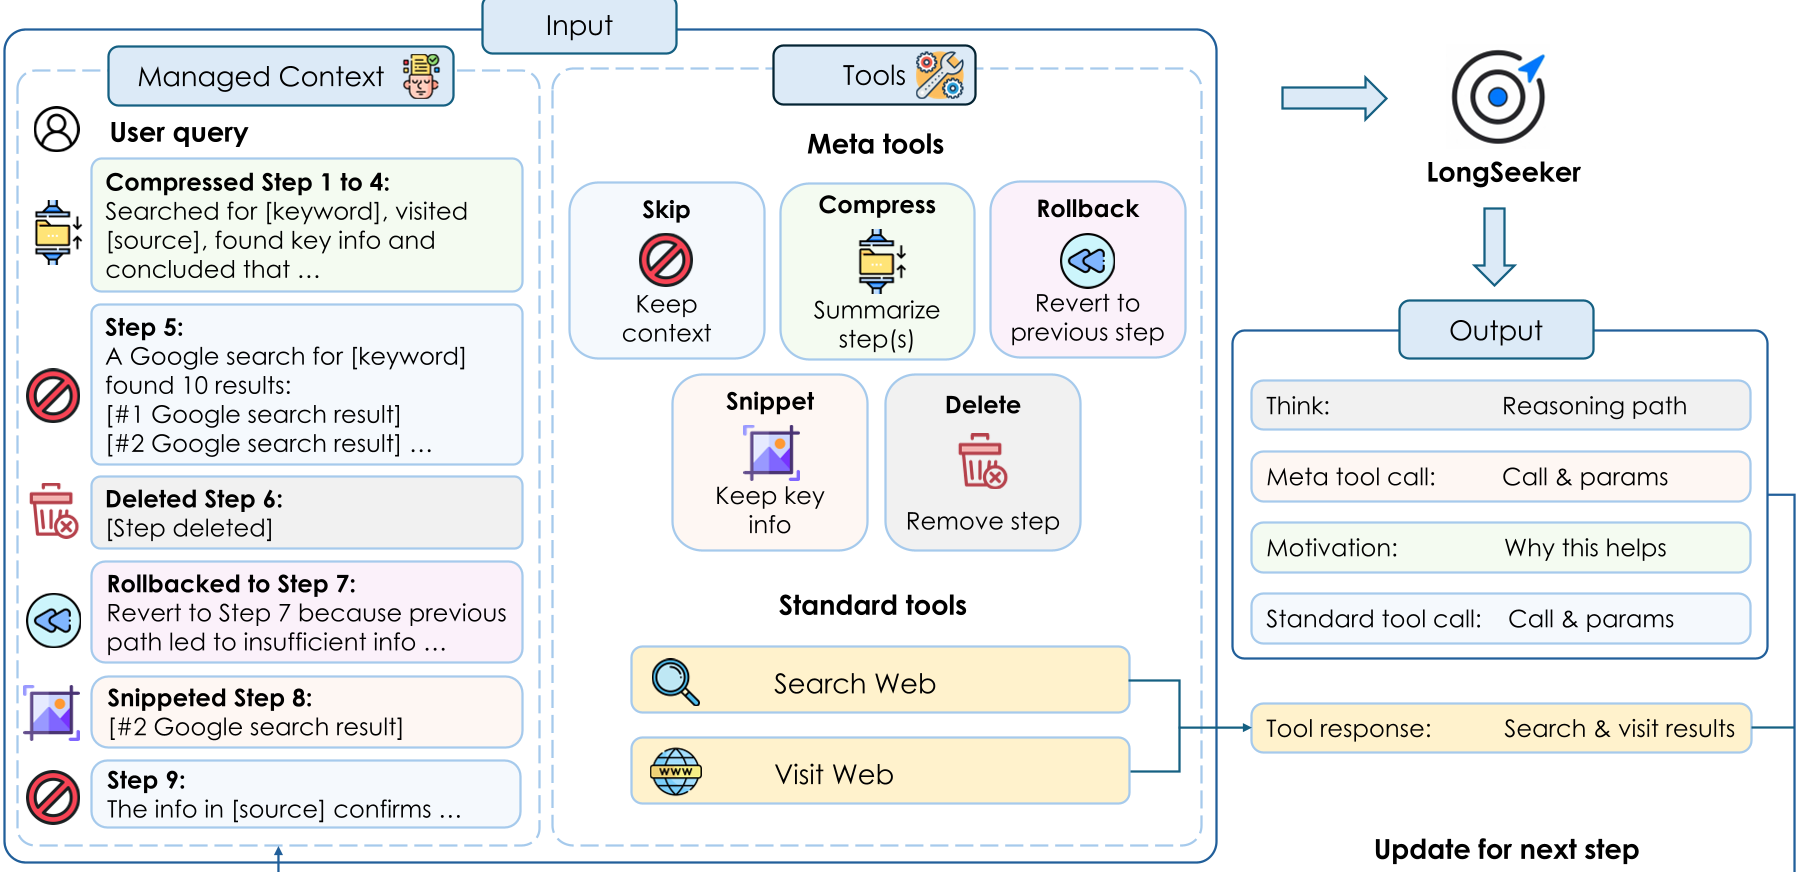
- SKIP:不进行任何处理,保持现状。
- COMPRESS:对指定范围的历史步骤进行抽象摘要。
- ROLLBACK:发现路线错误时,一键回溯到之前的某个状态,并记录失败原因防止重蹈覆辙。
- SNIPPET:高保真提取。通过锚点提取子串,解决摘要模型容易修改关键数字或实体的弊端。
- DELETE:彻底删除无意义的干扰步骤。
学术见解:作者从数学上证明了 COMPRESS 操作是“表达完备”的(理论上它可以演化成其他所有操作),但引入 ROLLBACK 和 SNIPPET 等具体指令,能给模型提供更强的归纳偏置(Inductive Bias),降低训练难度和推理成本。
实验战绩:极致的存储效率
LongSeeker 在 Qwen3-30B 的基础上,利用 10k 条合成的高质量“带有上下文管理动作”的轨迹进行了微调。
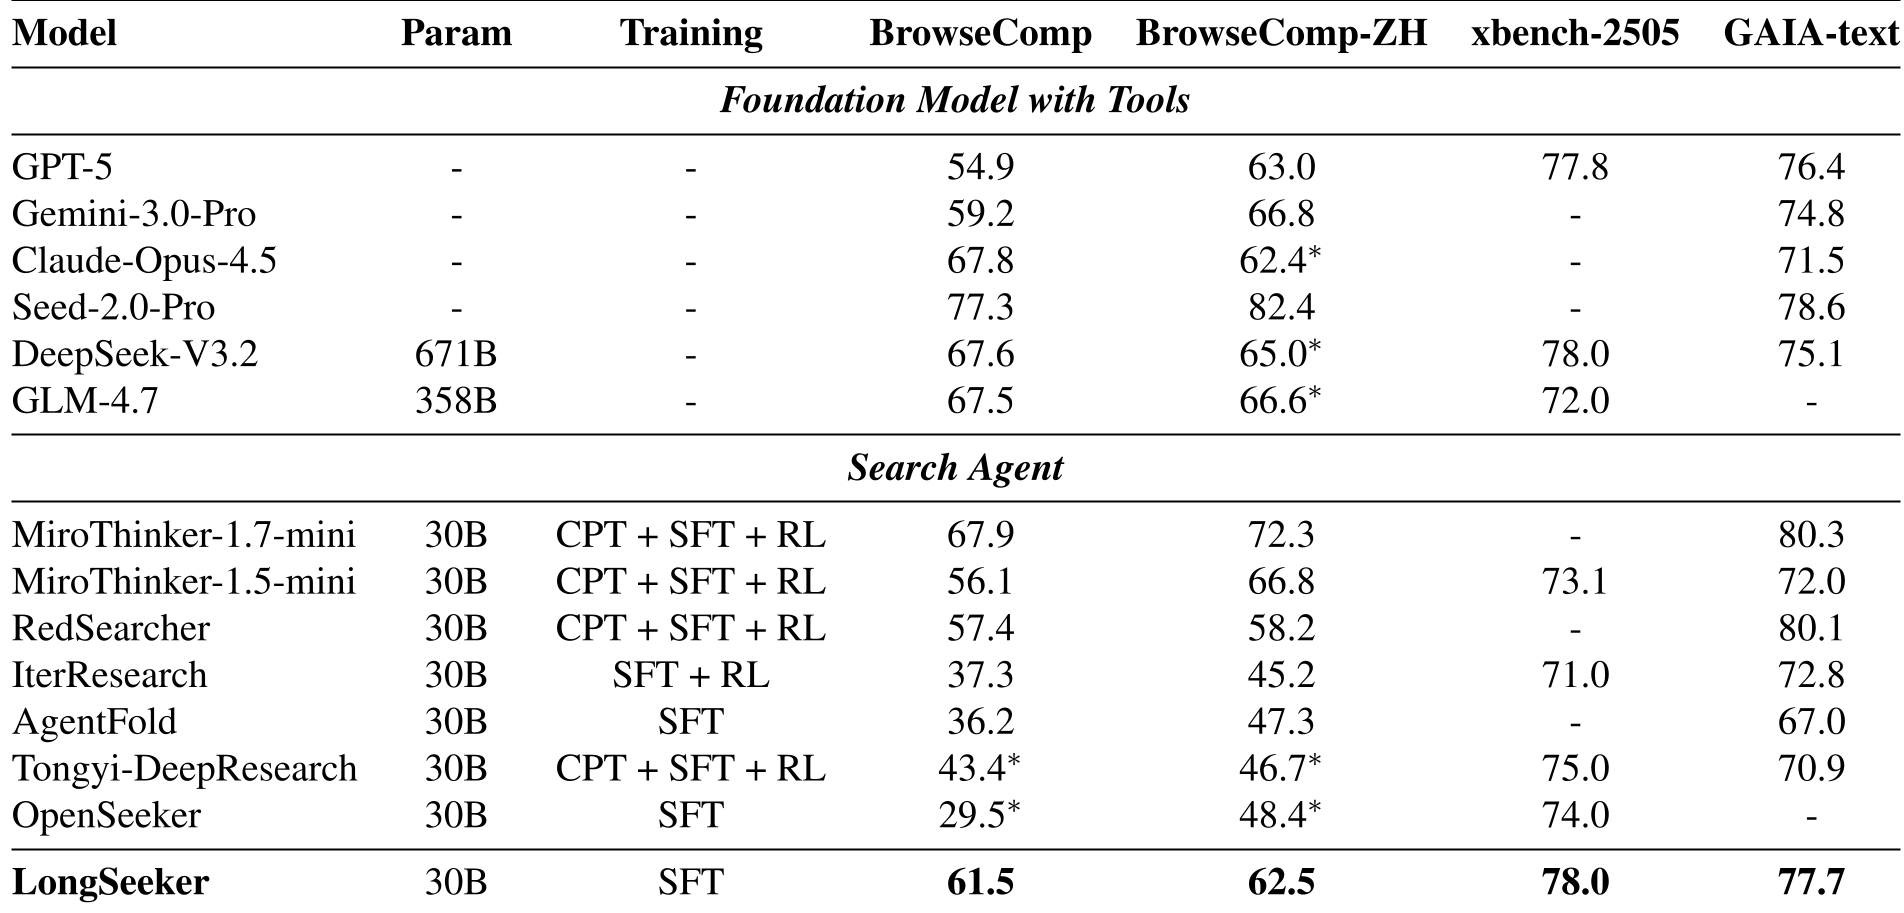
在核心实验中,LongSeeker 展现了惊人的稳定性:
- 性能:在 BrowseComp 榜单上以 61.5% 的得分击败了 Tongyi DeepResearch 和 AgentFold。
- Context 动态控制:如下图所示,相比于 DeepSeek-V3.2 会随步骤线性膨胀的上下文,LongSeeker 的上下文在经历初期增长后会迅速进入平稳期,即使跑了 300 步,消耗的 tokens 依然控制在 15k 左右。
深度洞察:迈向“心智管理”
LongSeeker 的成功预示着 Agent 架构的一个重要转向:智能体不应只是环境的被动观察者,而应是其自身内部记忆的主动编排者。
通过将“管理记忆”赋予原子操作权重,模型学会了在搜索深度增加时动态平衡“精确性”与“紧凑性”。这对未来开发高性能、低成本的长程搜索、法律发现或自动代码评审工具具有巨大的启示意义。
局限性:目前该研究主要依赖于 SFT(监督微调),未来结合强化学习(RL)通过任务成功率作为奖励,或许能让 Context 管理策略更加出神入化。
总结:LongSeeker 告诉我们,变强的秘诀不仅在于能记住多少,更在于知道什么时候该忘记。