
Lost in the Middle:大模型也会“走神”,上下文中间的信息去哪了?
Lost in the middle: How language models use long contexts
本文系统性地研究了长上下文语言模型处理信息的行为,提出了针对多文档问答和键值检索的受控实验。核心结论是:模型性能在相关信息位于输入开头(首因效应)或末尾(近因效应)时最强,而在处理上下文中间信息时性能显著下降,呈现出明显的“U型性能曲线”。
TL;DR
斯坦福大学等机构的这项研究揭示了一个令人不安的真相:即便大模型(LLM)声称拥有超长的上下文窗口,它们对信息的利用也是极度不均匀的。实验表明,模型最擅长处理开头和结尾的信息,而一旦关键信息落入上下文的“腹地”,模型的识别能力会遭遇断崖式下跌,这种现象被称为 “中部丢失”(Lost in the Middle)。
背景定位:长上下文的幻觉
在 Transformer 架构的演进中,长上下文处理能力已成为 SOTA 模型(如 Claude-3, GPT-4)的核心卖点。然而,能够“塞下” 100K Token 并不等同于能够“理解”它们。本文通过严谨的受控实验(Controlled Experiments),在学术界首次系统性地量化了位置偏见对比模型性能的影响。
核心发现:神秘的 U 型性能曲线
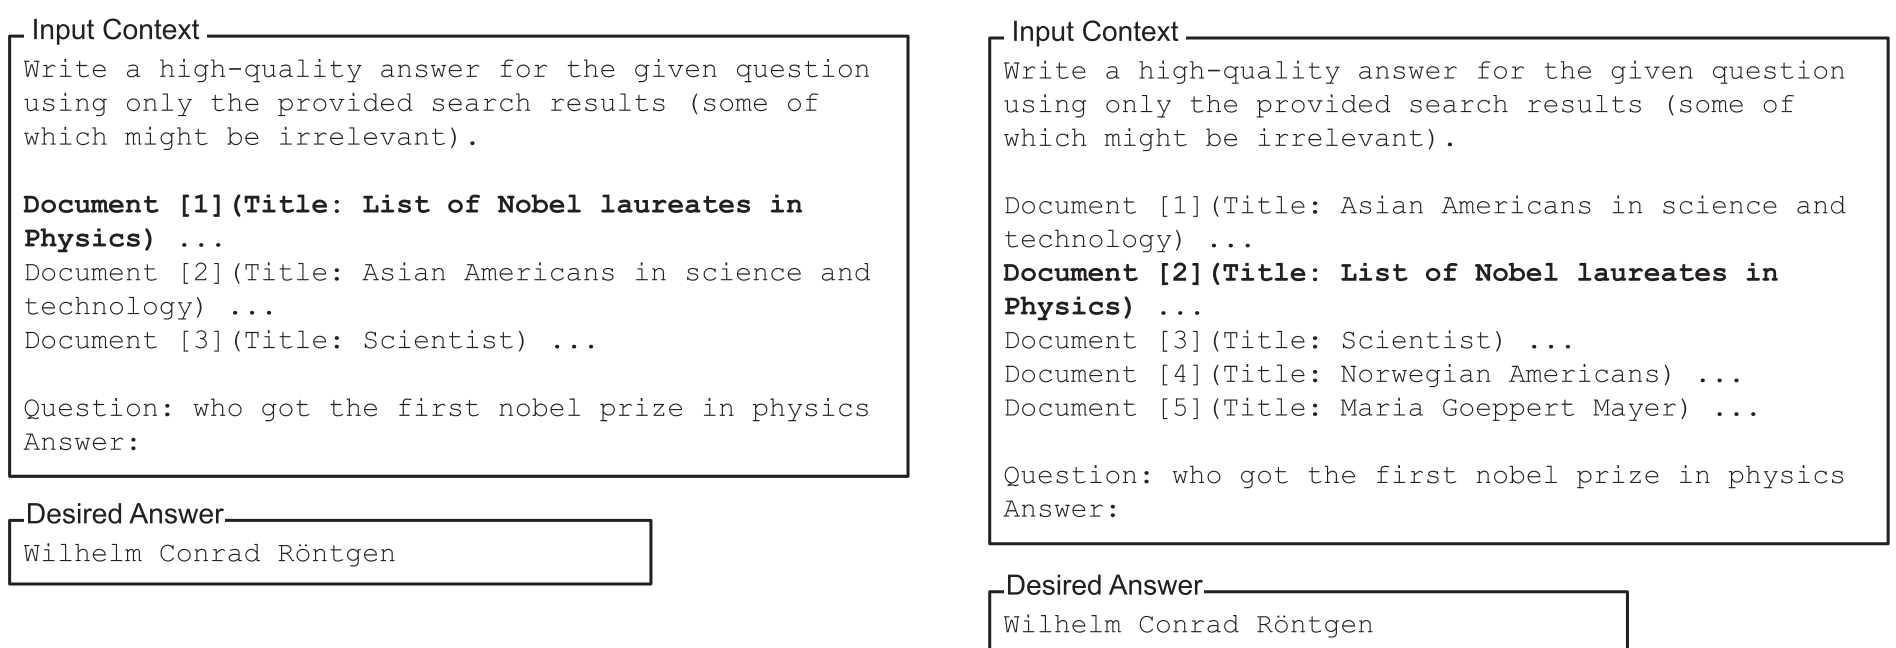
研究者使用了两类任务进行压力测试:
- 多文档问答 (Multi-document QA):在 个文档中只隐藏一个包含答案的文档,观察模型能否找对它。
- 键值检索 (Key-Value Retrieval):纯合成任务,测试模型从 JSON 结构中提取特定键对应值的能力。
实验结果展示了一张非常直观的 U 型曲线图:
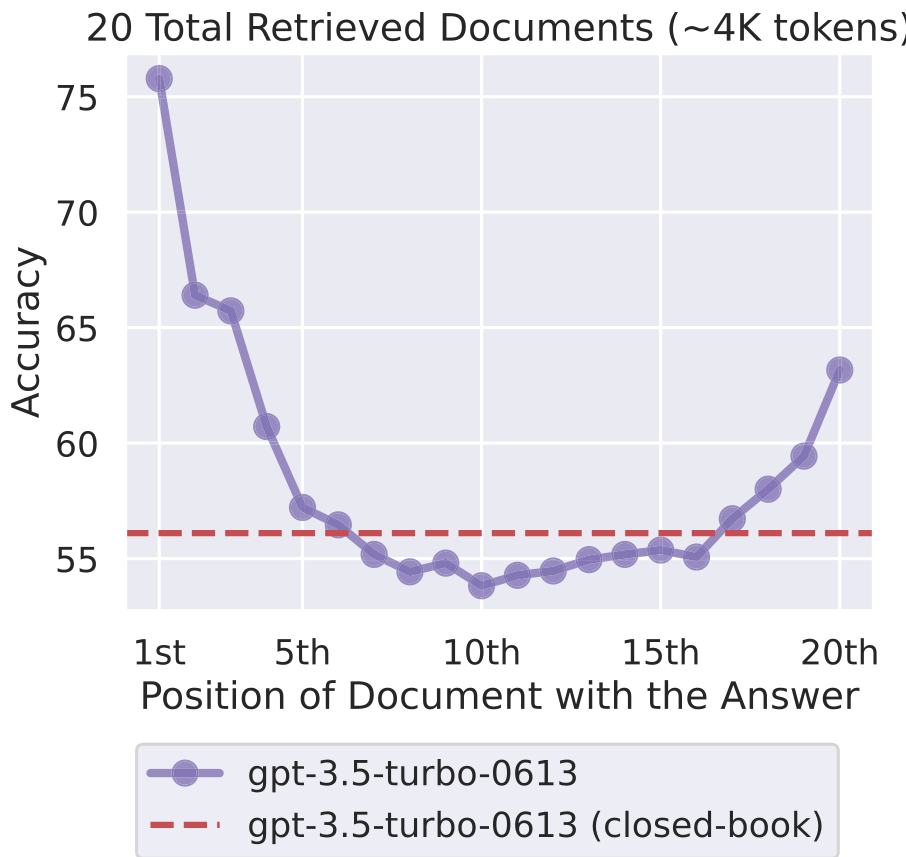
- 首因效应 (Primacy Bias):信息在开头,模型表现极佳。
- 近因效应 (Recency Bias):信息在末尾,模型也能较好捕捉。
- 中部崩溃:当相关信息隐藏在 20 个文档的中间位置时,Llama-2, GPT-3.5 等模型的准确率甚至不如“默写”搜索到的背景知识。
深度洞察:为什么会这样?
1. 架构的影响:Decoder-only 的天然缺陷?
研究发现,采用双向注意力的 Encoder-Decoder 架构(如 Flan-T5)在处理其训练长度内的序列时表现得更为稳健。相比之下,主流的 Decoder-only 模型 由于只能看到之前的 Token,在处理位于中间的上下文时,缺乏对全局信息的双向感知能力。
2. 查询位置的魔力
一个有趣的实验是,如果将“问题”同时放在上下文的开头和结尾(即 Query-Aware Contextualization),合成任务的表现会显著提升,但在复杂的自然语言 QA 任务中,这种改进却微乎其微。这说明模型对简单模式匹配(KV 检索)和深层语义理解(QA)的注意力分配机制是不同的。
3. 模型规模是把双刃剑
作者对比了 Llama-2 的 7B, 13B 和 70B 版本。令人意外的是,较小的模型(7B)主要表现为近因效应,只有足够大的模型才会展现出明确的 U 型曲线。这暗示了 “首因效应”可能是模型在大规模预训练中习得的一种高阶能力。
实验战绩与 RAG 的启示
在针对检索增强生成(RAG)的案例研究中,作者发现:
- 收益递减:当检索到的 PDF 文档数量从 20 个增加到 50 个时,GPT-3.5 的准确率只提升了不到 1.5%。
- 负面负担:增加更多的文档虽然提高了召回率(Recall),但也增加了模型在中间地带“走神”的概率。
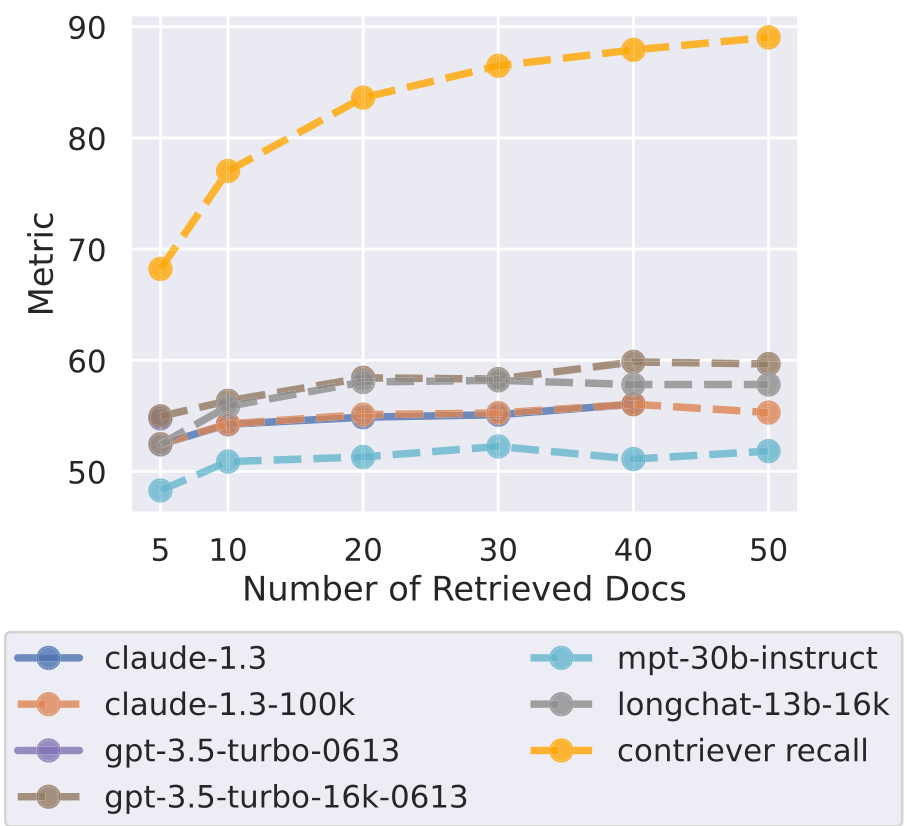
结论非常明确:无脑堆砌上下文长度是低效的,精准的重排序 (Reranking) 比单纯扩展长度窗口更有意义。
总结与未来展望
《Lost in the Middle》是长上下文研究领域的里程碑式论文。它告诉我们:
- 评估标准需重构:不能只看 Perplexity,必须看模型在不同位置的检索能力。
- 工程避坑:在设计 RAG 系统时,务必通过算法将最相关的文档放在输入的最前面。
- 局限性:尽管本文揭示了现象,但对 Transformer 为何在中部出现失效的深层数学原理(如注意力权重稀释)仍有待进一步探索。
对未来的大模型研究者而言,如何拉平这条 U 型曲线,让大模型“全神贯注”,将是实现真正通用智能的关键挑战。