
动力学视角下的 LLM:无需检索与重采样的低成本幻觉检测新思路
Low-Cost Black-Box Detection of LLM Hallucinations via Dynamical System Prediction
本文提出了一种名为 DS-Hallucinaton 的新型黑盒幻觉检测方法,将大语言模型(LLM)的输出视为一种高维动力系统(Dynamical System)。通过 Koopman 算子理论捕捉 token 嵌入向量在流形上的演化动态,该方法在无需外部检索或多次采样的情况下,仅凭单次生成(Single-sample pass)即可实现 SOTA 级别的检测精度。
TL;DR
传统的幻觉检测要么得查数库(检索增强),要么得像复读机一样生成好几次看对不对(采样一致性)。本文提出了一个“降维打击”的视角:把 LLM 的输出看作是一个物理动力系统。通过分析 Token 嵌入向量在空间中的“飞行轨迹”,我们仅靠一次推理就能分辨出它是认真的还是在信口开河。
痛点深挖:幻觉检测的“三高”困局
当前的黑盒检测方法面临着显而易见的挑战:
- 高延迟:检索外部知识(RAG 模式)受限于网络和索引速度。
- 高成本:SelfCheckGPT 等方法需要生成 5-10 个采样,API 费用直接翻倍。
- 访问受限:商业模型(如 GPT-4)不提供 Hidden States,导致很多“白盒”检测方案无法落地。
作者敏锐地察觉到:幻觉并不是随机的错误,而是一种统计上的必然。事实性文本和幻觉文本在嵌入空间(Embedding Space)中的演化遵循不同的规律,即它们位于不同的**流形(Manifold)**上。
核心机制:Koopman 算子与动力学拟合
作者将 LLM 视为一个离散时间非线性系统。为了处理复杂的非线性,引入了 Koopman 算子理论。其核心直觉是:虽然 LLM 生成是非线性的,但我们可以通过“升维”(Lifting)找到一个算子,让它在更高维的空间里表现为线性演化。
算法流程:
- 离线拟合:收集已知的“事实”和“幻觉”文本,通过 Extended DMD 算法训练出两个预测器 (事实模型)和 (幻觉模型)。
- 在线推理:当新文本产生时,观察其 Token 轨迹,同时用 和 进行下一步预测。
- 残差对比:如果事实模型预测得更准(残差更小),则判定为真;反之判定为幻觉。
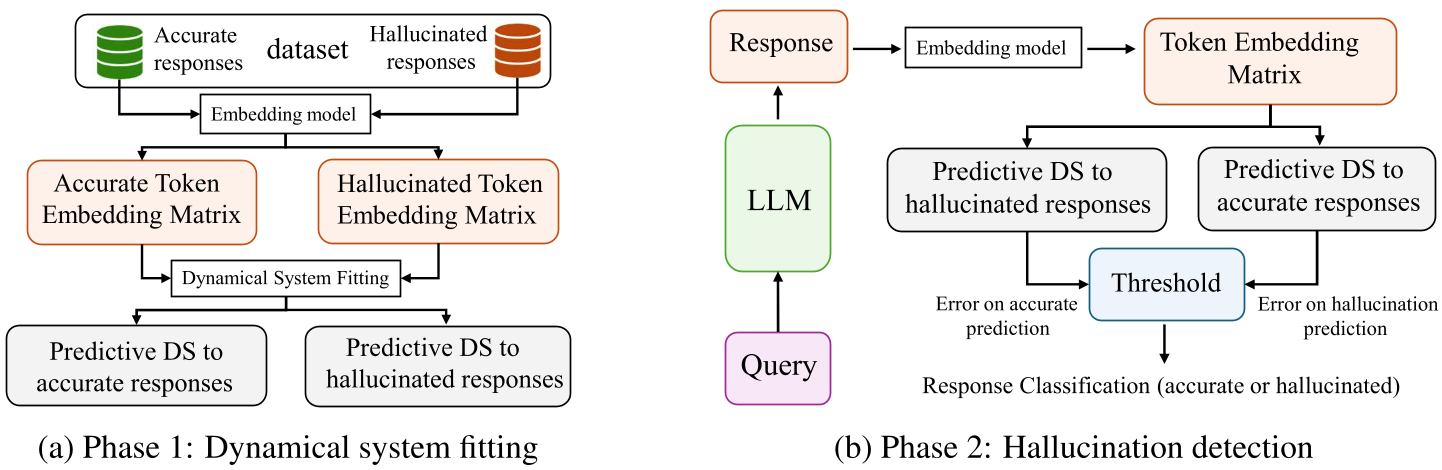 图 1:动力系统拟合与检测流程。Phase 1 端训练模型,Phase 2 执行差分残差评分。
实验战绩:单次 pass 吊打重采样
实验中最令人兴奋的发现是:随着序列长度的增加,检测精度显著提升(如图 5 所示)。这符合动力系统的物理直觉——观察的时间窗越长,轨迹的特征越明显。
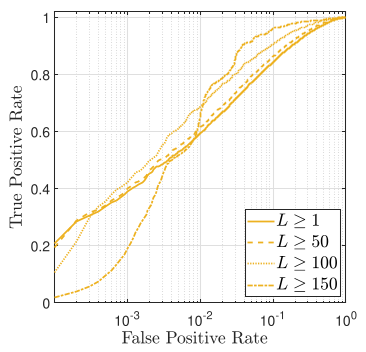 图 2:在 HaluEval 任务中,随着 Token 长度 的增加,ROC 曲线(尤其是小模型)呈现出明显的左上漂移,性能大幅增强。
关键结论:
- 超越最强基线:在 WikiBio 任务中,该方法(使用 Llama-3 嵌入)的 AUC-PR 比经典的采样法 SelfCheckGPT 提高了约 4%。
- 跨模型泛化:有趣的是,在一个模型上训练的动力系统预测器,在另一个模型生成的嵌入上居然也能保持超过 50% 的准确率,说明幻觉在语义空间中具有某种“通用特征”。
深度洞察:个性化与局限性
论文还提出了一个非常实用的功能:偏好感知校准。 由于不同场景对“幻觉”的容忍度不同(比如写小说可以瞎编,但写医嘱不行),用户可以通过少量样本调整阈值 。
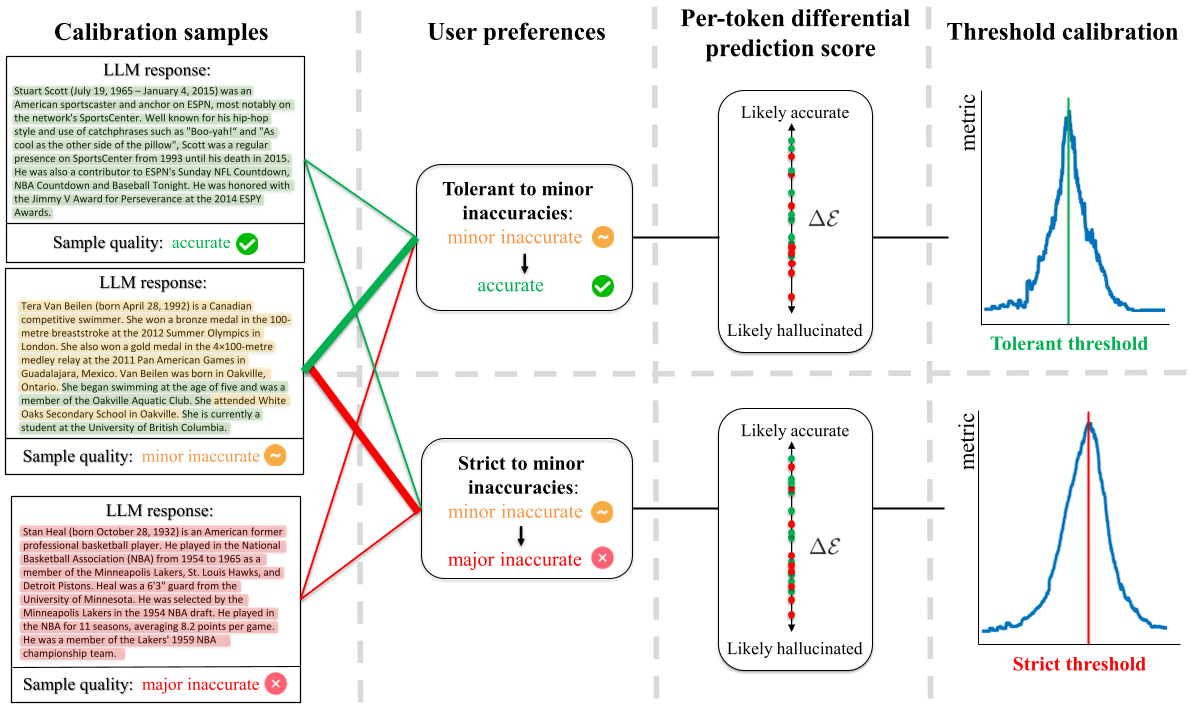 图 3:用户可根据严苛(Strict)或容忍(Tolerant)的偏好,通过示教样本自动优化分类边界。
局限性分析
尽管该方法极大地降低了成本,但它属于“知错但不能改错”的类型。它能告诉你这段话有 90% 的概率是幻觉,但它无法像 RAG 那样告诉你正确的答案是什么。此外,它对嵌入模型的质量有一定依赖。
总结
本文为大模型事实性评估开辟了一个跨学科的视角。通过将离散的文字处理转化为连续的流形动力学问题,作者证明了:LLM 的幻觉是有迹可循的物理运动轨迹。对于追求实时性、对推理成本敏感的企业级应用来说,这无疑是一个极具吸引力的技术方案。