
打造“登山机”:微软 MAI-Thinking-1 深度解析——从零构建推理巅峰
MAI-Thinking-1: Building a Hill-Climbing Machine
本文介绍了 MAI-Thinking-1,这是一个拥有 35B 激活参数 / 1T 总参数的稀疏混合专家模型 (MoE)。通过自研的“登山机”(Hill-Climbing Machine) 系统化优化流程,该模型在不使用任何第三方模型蒸馏数据的情况下,从零开始训练,在 AIME 2025 (97.0%) 和 SWE-Bench Pro (52.8%) 等 STEM 推理和编程任务中达到了顶尖水平。
TL;DR
微软 AI 团队在最新报告中公开了 MAI-Thinking-1 的技术细节。这是一个 1 万亿参数量级的 MoE 模型(激活 35B),它不仅是一个强大的推理模型,更是一套名为“登山机 (Hill-Climbing Machine)”的系统化方法论的产物。在拒绝任何外部蒸馏(Distillation-free)的前提下,该模型在 AIME 2025 上刷出了 97.0% 的惊人战绩。
核心直觉:AI 开发是一个系统级优化问题
作者认为,AI 的进步不应寄希望于偶然的灵光一现,而应被视为一个经验优化的闭环。他们构建的“登山机”系统包含了从数据清洗、分布式框架 YOLO 到 Rocket 强化学习系统的全栈自研。这种“原生”主义确保了模型能力的真实性和可控性,避免了模仿蒸馏数据带来的“虚假智能”。
架构演进: sparsity 的艺术
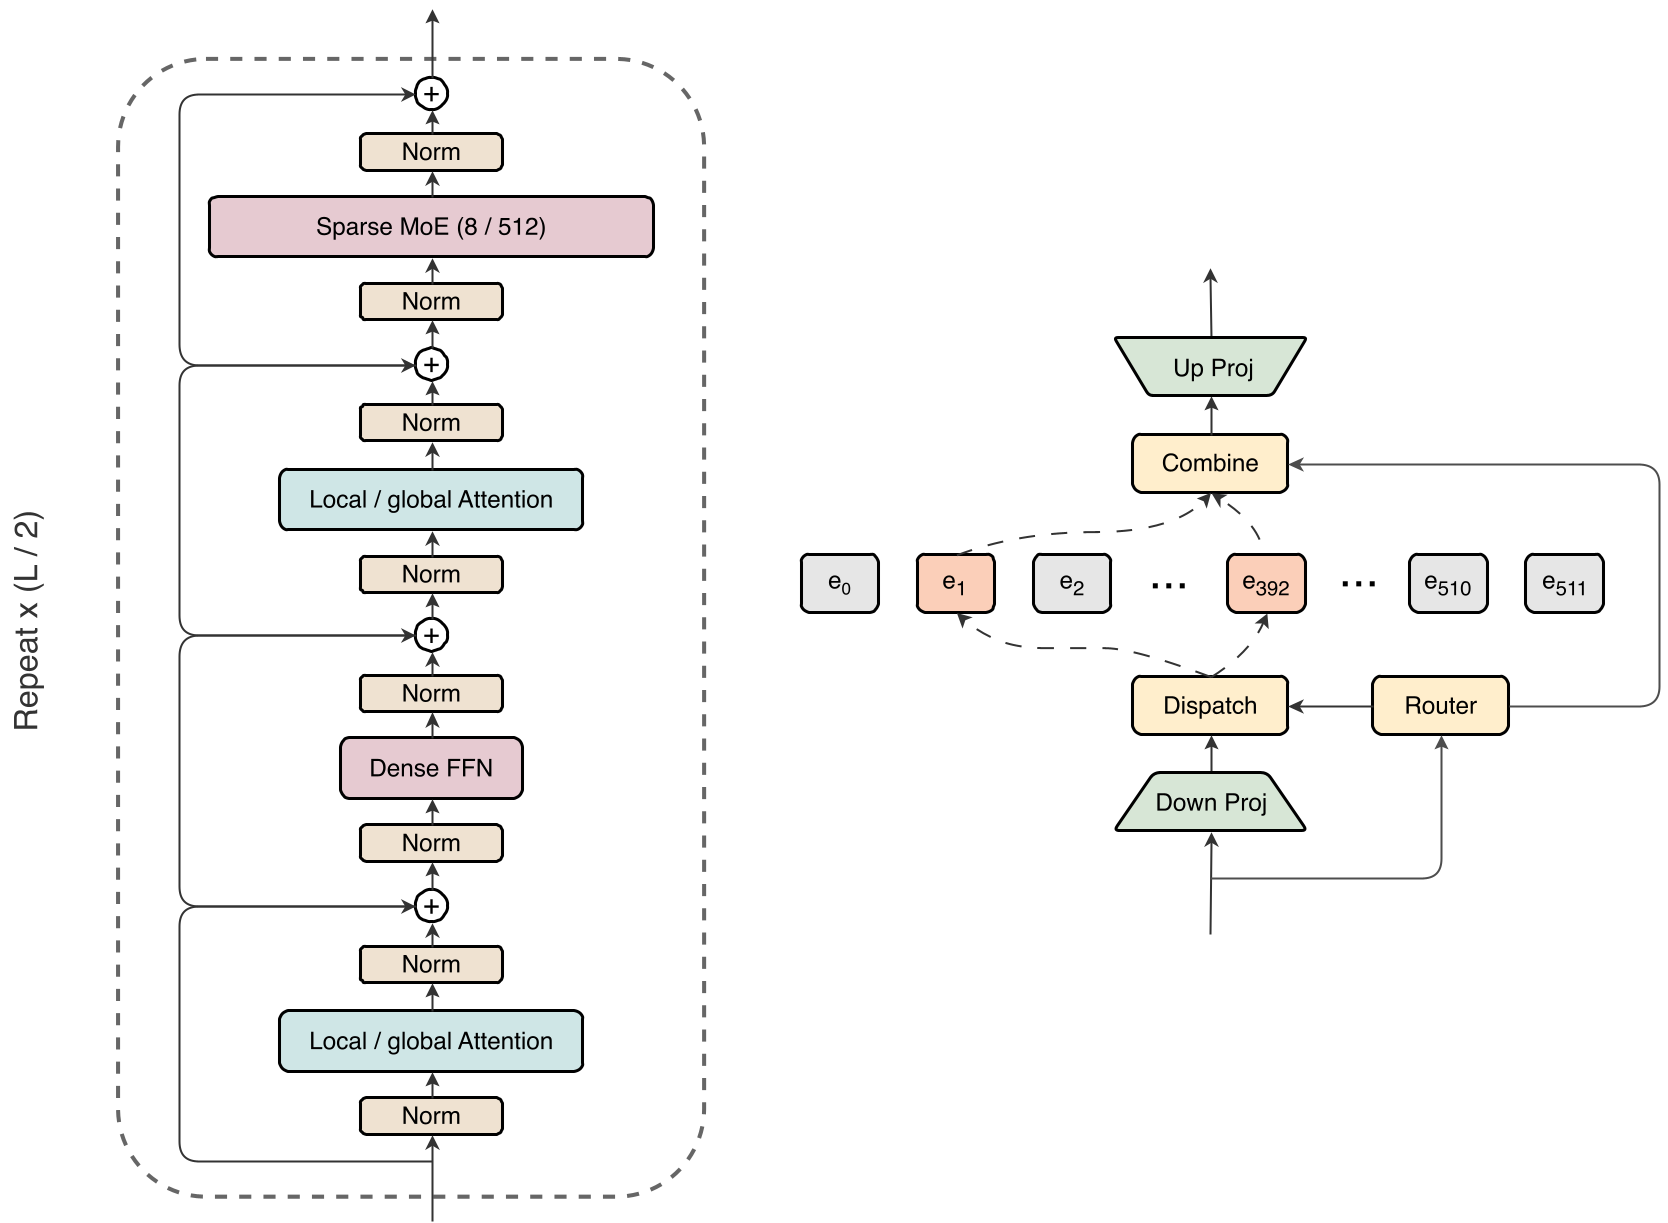
MAI-Thinking-1 采用了精妙的混合架构:
- 交替层设计:模型并非全程 MoE,而是将高稀疏度的 MoE 层与小规模的稠密 FFN 层交替排列。实验证明,这种设计在相同的计算带宽(MFU)下比纯 MoE 效率更高。
- LatentMoE:借鉴了最新的研究成果,在全对全通信(All-to-All)之前对表示进行压缩(Down-projection),极大地缓解了跨机通信的压力。
- 注意力梯度优化:采用了 5:1 的局部/全局注意力比例,结合 FlashAttention-4,确保了 256K 超长上下文的处理能力。
强化学习的“登山感”:从 GRPO 到自蒸馏
为了复刻推理能力的突破(类似 OpenAI o1 的路径),MAI-Thinking-1 在强化学习阶段引入了关键创新:
- 自适应熵控制:通过 PID 控制器动态调整裁剪界限,无需显式的熵奖励项即可维持探索多样性。
- 自蒸馏恢复:当 RL 环境发生变化或训练因硬件崩溃时,通过对当前最佳推理迹(Traces)进行自蒸馏,将模型能力“物理固化”到 SFT 基座中,从而继续攀登。
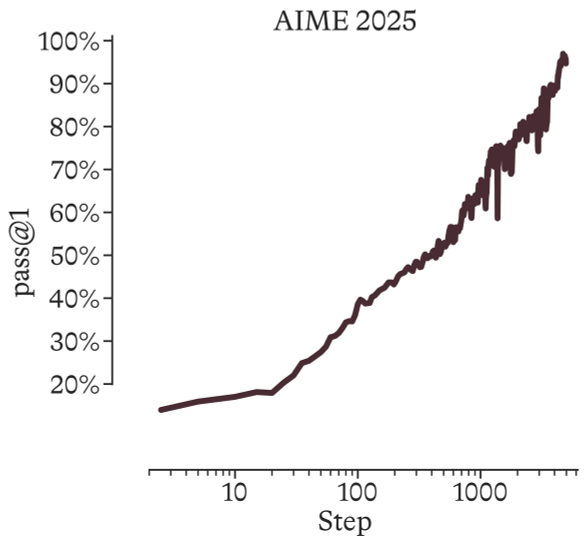 上图展示了模型在 AIME 和编程任务中通过强化学习实现的持续对数线性增长。
实验战果:STEM 与编程的双重压制
在硬件效率上,得益于自研框架 YOLO 对内核级别的优化,MAI-Base-1 在 8000 块 GB200 上跑出了 90% 的 Goodput。在下游任务中,其表现堪称彪悍:
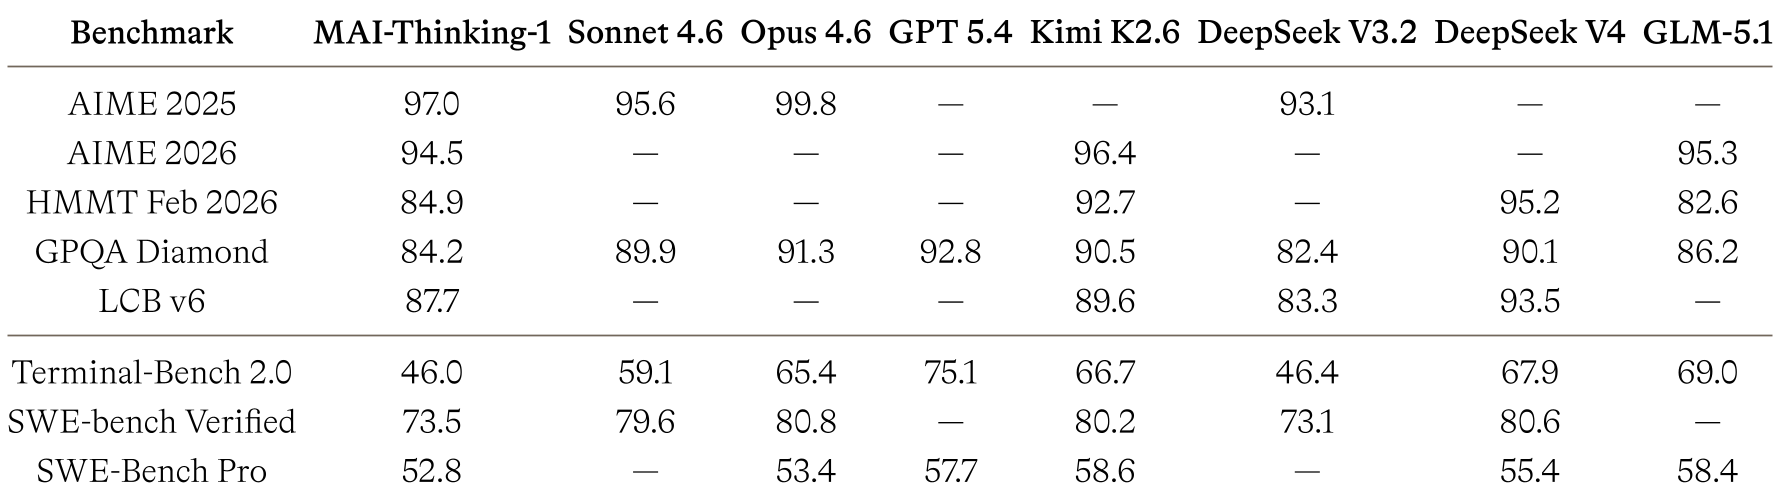
- AIME 2025:97.0%(超越 Claude 3.5 Sonnet 的 95.6%)。
- SWE-Bench Pro:52.8%,证明了其在真实的复杂软件工程任务中的逻辑编排能力。
深度洞察与总结
MAI-Thinking-1 的成功标志着大模型开发进入了“工匠时代”:
- 数据纯净度:完全摒弃合成数据,坚持企业级原生数据。
- 系统共生:模型架构与底层芯片拓扑(GB200 NVLink 域)的高度共担设计。
- 推理意识:通过 RL 强制模型生成
<think>标签,其逻辑痕迹表现出从最初的“盲目猜测”到后期的“严谨自审”的进化。
局限性:虽然 STEM 性能强劲,但在部分多语言长尾任务中仍存在鲁棒性漏洞。此外,这种极高参数量(1T)下的端到端极致优化,对算力的垄断性要求极高,这既是防线,也是挑战。
展望未来,当“自动登山”成为标配,AI 的竞争将彻底转向数据质量的极致颗粒度与系统运行的稳定性。