
[CVPR 2025(?)] Mario:打破孤岛,让 LLM 掌握多模态图推理的“动态平衡”
Mario: Multimodal Graph Reasoning with Large Language Models
2026-03-05
总结
问题
方法
结果
要点
摘要
本文提出了 Mario,一个专门用于多模态图 (MMG) 推理的统一框架。通过结合图增强的视觉语言模型 (GVLM) 和模态自适应指令微调,Mario 在节点分类和链路预测任务中均达到了 SOTA 水平。
TL;DR
在现实世界中,多模态数据并非孤立存在,而是交织在复杂的网络(如社交网络、电商图谱)中。本文提出的 Mario 框架,通过“图约束对齐”和“模态自适应路由”两手抓,解决了多模态图(MMG)推理中长期存在的一致性弱与偏好差异两大痛点,在零样本(Zero-shot)迁移中甚至跑出了翻倍的战绩。
背景定位:从“孤岛对齐”到“结构推理”
目前的视觉语言模型(VLM)通常假设图中的每一个节点都是标准的“图文对”,但在 MMG 中:
- 噪音大:一张商品的图片可能只是售后说明,而核心语义全在文本里;或者文本极短,全靠图像补位。
- 关联深:节点的真实含义往往隐藏在其邻居节点的关联中。 Mario 的出现,旨在将 Graph 的结构先验注入 LLM 的推理逻辑中,使其不再只是盯着单个节点看,而是“顾全大局”。
痛点深挖
- C1: 弱跨模态一致性 (Weak Cross-modal Consistency):传统 CLIP 这种模型在处理 MMG 时,往往发现文本和图像的相关性极低(见原图 1a,余弦相似度极低)。
- C2: 异质模态偏好 (Heterogeneous Modality Preference):有的节点是“视觉驱动型”,有的则是“文本驱动型”。一刀切的 Prompt 策略会导致信息利用率低下。
方法论详解:Mario 的双重变奏
第一阶段:图约束视觉语言模型 (GVLM)
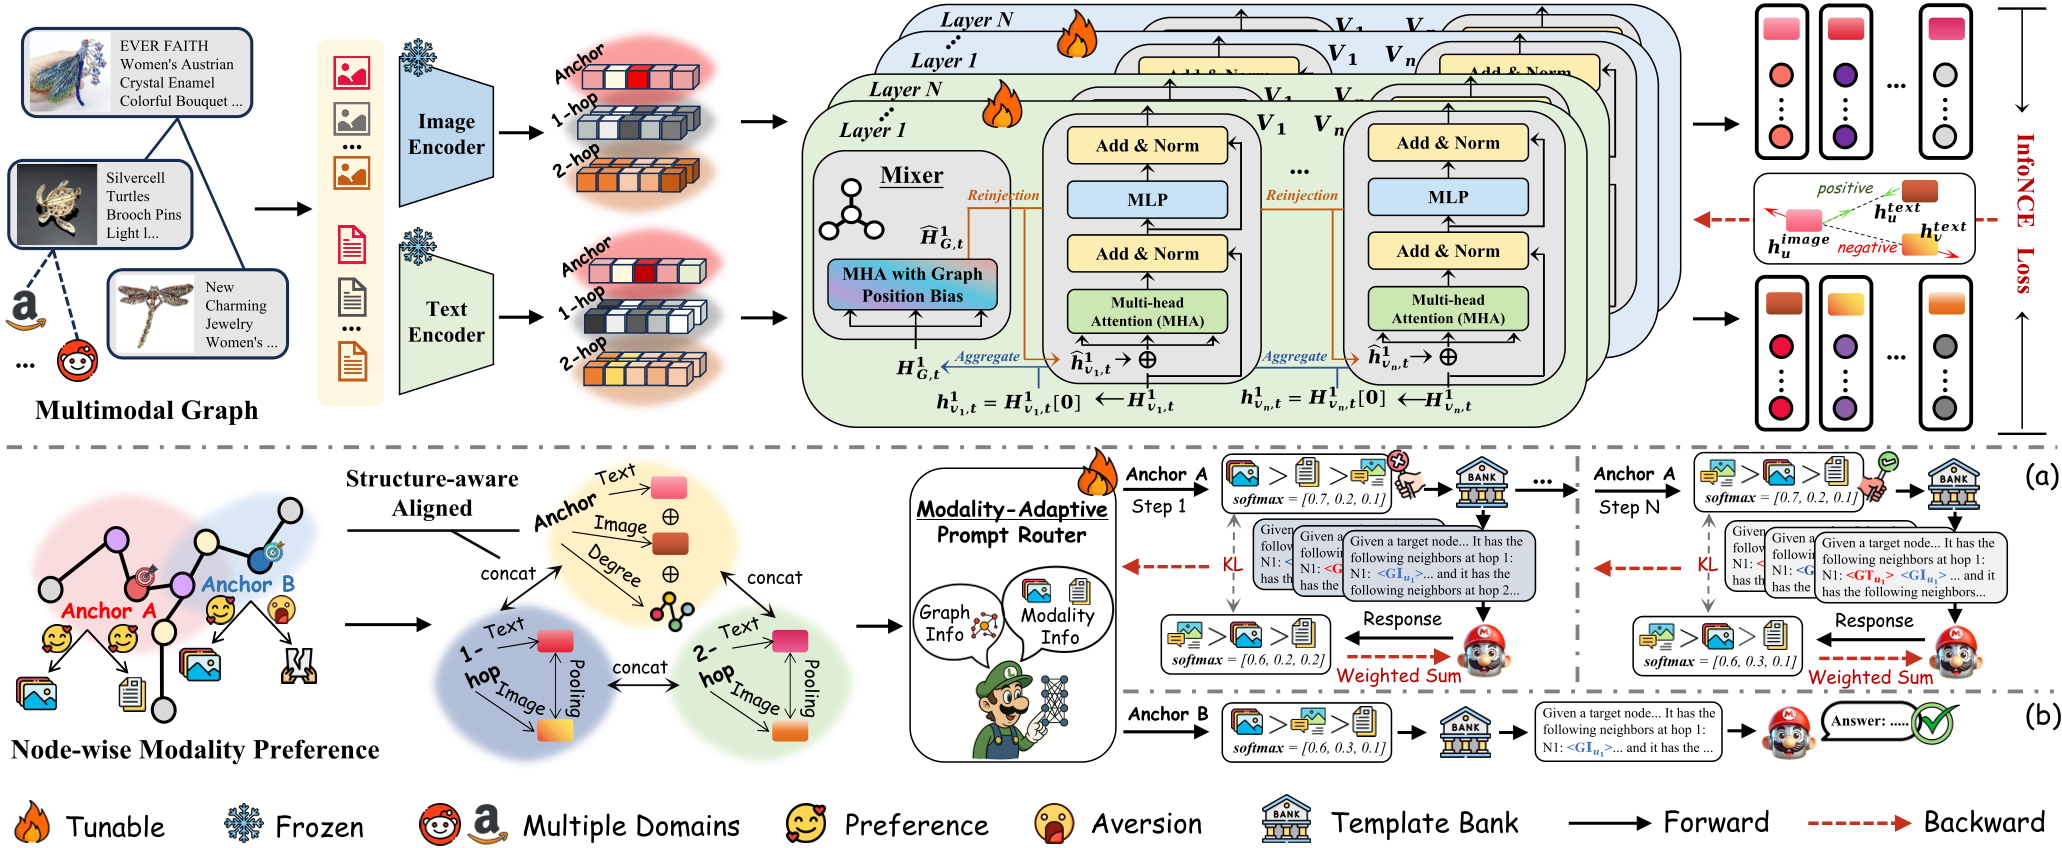
为了让 text 和 image 在同一个结构背景下对话,作者设计了一个 Topology-Aware Multimodal Mixer。
- 结构注入:通过在 Transformer 层中加入 head-specific 的可学习位置偏差(基于最短路径距离),模型在计算注意力时能“感知”到邻居的存在。
- 动态对齐:使用双向 InfoNCE Loss,让同一节点的不同模态在结构约束下相互靠近,强行纠正那些“词不达意”的噪声。
第二阶段:模态自适应指令微调 (MAPR)
这是全篇最“聪明”的设计。作者没有强迫 LLM 同时处理所有模态,而是给 LLM 穿上了一个“分流器”:
- 可学习路由器:通过 MLP 捕捉节点特征、邻居上下文和度数(Degree),预测当前节点最适合哪种 View(Text-only, Image-only, Mix)。
- KL 散度约束:利用 LLM 实际产生的 Loss 作为“老师”,指导路由器判断哪种模态组合是真的有效。
实验与结果:全线碾压
在 Amazon 和 Reddit 的多项测试中,Mario 的表现几乎是一骑绝尘:
- SOTA 对比:在 CDs 数据集上,相比同类最优 baselines 提升了近 12.3% (63.43% vs 56.45%)。
- 收敛效率:如图 3 所示,由于路由器能精准定位有效模态,模型在 Movies 数据集上的收敛速度比固定模板快了 2.3 倍。
深度洞察:模态偏好的“同质性”
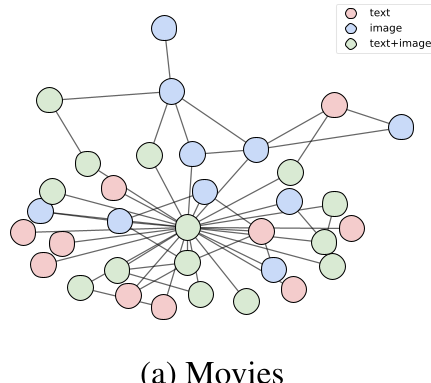
作者通过可视化发现了一个有趣现象:模态偏好在图中具有局部一致性(见原图 5)。这意味着,如果你和你的邻居经常被“捆绑购买”,你们可能更依赖同样的一套模态特征来被 LLM 识别。
总结与展望
Mario 成功的关键在于承认了数据的非理想性。它不假设每一对图文都是完美的,而是通过图结构去修正和筛选信息。
- 局限性:虽然推理效率高,但训练阶段需要对三个模板进行 Forward/Backward,计算开销在训练初期较大。
- 未来:这种“路由”思想极具启发性,未来是否可以扩展到更复杂的 3D 或音频图谱中?值得期待。