
MATHNET:当 Olympiad 解题不再等于数学检索
MATHNET: A GLOBAL MULTIMODAL BENCHMARK FOR MATHEMATICAL REASONING AND RETRIEVAL
本文提出 MATHNET,包含 30,676 道 Olympiad-level problems 和三类任务:Problem Solving、Math-Aware Retrieval、Retrieval-Augmented Problem Solving。结果显示最强解题模型可达到 78.4% 准确率,但嵌入模型在等价题检索上的 Recall@1 仅约 5%;当检索到结构对齐的专家配对题时,DeepSeek-V3.2-Speciale 在人类评分下达到 97.3%。
TL;DR
MATHNET 把数学奥赛评测从“能否写出答案”扩展为三个互相耦合但本质不同的能力:Problem Solving、Math-Aware Retrieval 和 Retrieval-Augmented Problem Solving。论文用 30,676 道 Olympiad-level problems、47 个国家、17 种语言和 143 场竞赛构建了主语料;在 Table 3 中,gemini-3.1-pro-preview 的 Micro Avg 达到 78.4,gpt-5 为 69.3,但 Table 4 显示最强 embedding 模型 gemini-embedding-001 的 All R@1 仅 4.83,qwen3-embedding-4B 也只为 4.96。进一步地,Table 5 中 DeepSeek-V3.2-Speciale 在人类评分下从 Zero-shot 的 84.8 升至 Expert-RAG 的 97.3,说明检索增强并非天然有效,而取决于召回的上下文是否真正具备数学结构对齐。
背景定位
这是一篇典型的 Benchmark 和 Dataset 工作,而不是单纯刷新某个单一推理榜单。它的坐标系意义在于同时占据两个方向:一方面,它用官方题册规模超过既有 Olympiad 数据集;另一方面,它首次把“数学问题检索”作为独立任务推到前台。MATHNET 的主要贡献不是证明某个模型更强,而是指出模型在“找到等价题”这件事上几乎失败,并把这种失败转化为可测量、可构造、可改进的评测对象。
从论文给出的 Table 1 看,既有 benchmark 多集中在英语或中英双语、社区平台来源或较小规模上;MATHNET 则强调 official country booklets、international contests 和 national contests 来源,并覆盖 EN、ZH、ES、RU、FR、RO 等语言。这里的关键不是语言数量本身,而是它让“数学等价”必须跨表示、跨记号、跨自然语言叙述而被识别,从而逼近真实竞赛出题与科研检索的困难。
问题与动机
现有数学推理评测存在一个被长期掩盖的失效机制:生成模型可以因为训练数据中存在相似题目、或者因为最终答案碰巧正确而获得高分,但这并不说明模型掌握了数学对象的等价类。论文在 Section 1 中给出了一个核心例子:形如 $x^{2}+y^{2}=1$ 与 $a^{2}+b^{2}=1$ 的表述在结构上等价,甚至可以与单位范数二维向量集合相关联,但它们并不等价于 $x+y=1$。传统 retrieval 模型可能因为变量名、关键词或表面符号重叠,把 $x+y=1$ 这类近邻错误表述排在更高位置。
这个问题在专家工作流中也很真实。论文提到 IMO shortlist 构造过程中,出题人需要识别新题是否与已有题目、书籍或在线题集重复;数学研究中,研究者搜索“upper bounds on prime gaps”这类自然语言主题,而不是固定公式。现有系统擅长语义改写匹配,却对 symbolic equivalence、变量重命名、代数变形和跨域同构不敏感。MATHNET 的动机正是把这种“结构盲视”变成可量化评测。
核心章节:MATHNET 作为 benchmark 的三段式骨架
评测目标与设计:从答案正确性到数学等价类
MATHNET 的主语料 MathNet-Solve 支撑 Problem Solving;MathNet-Retrieve 支撑 Math-Aware Retrieval;MathNet-RAG 支撑 Retrieval-Augmented Problem Solving。三者不是同一任务的三种变体,而是刻意拆分出的三层能力:生成能力、表示能力、检索对生成是否有用。这种拆分的价值在于,它避免把“检索增强后变强”直接归因于 solver 更强;相反,论文通过 Zero-shot、Embed-RAG 和 Expert-RAG 三个条件,把 retrieval quality 单独隔离出来。
论文进一步提出一个精细的相似性 taxonomy:Invariance、Resonance 和 Affinity。Invariance 是严格等价,例如变量重命名、代数改写、几何再表述或跨域同构;Resonance 是部分相似,两个问题不等同,但可用同一证明策略、引理或结构直觉解决;Affinity 则是主题性相关,例如都属于数论或组合,但没有共享解法结构。MATHNET-RAG 使用 35 对 expert-paired real problems,并明确落在 Structural Resonance 类别,这说明作者关心的不是“找到几乎一样的题”,而是“找到能迁移人类类比直觉的题”。
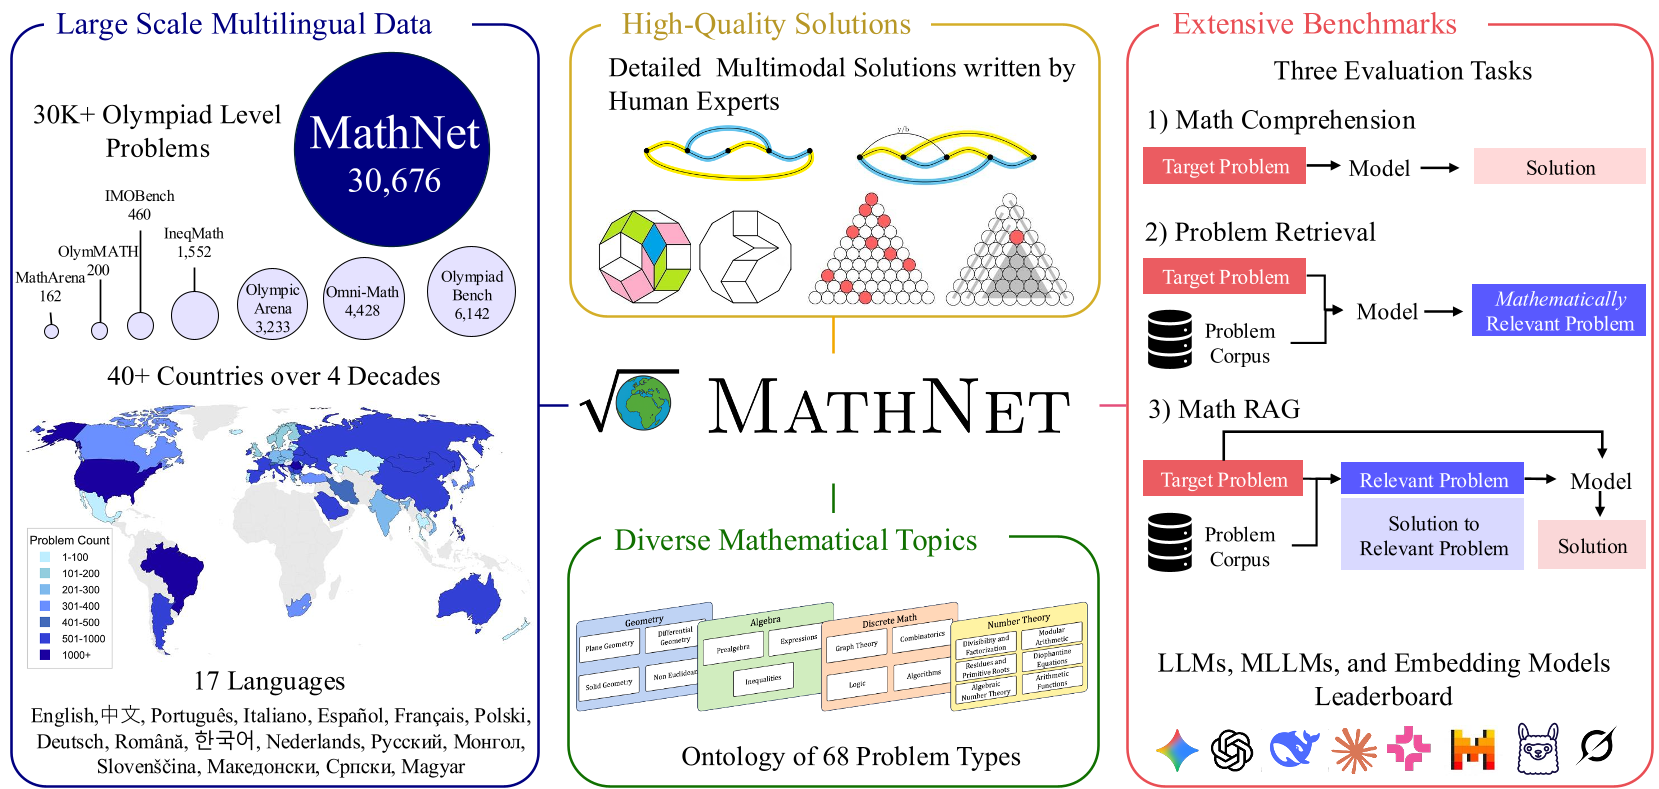
为什么不用简单的 Invariance 作为 RAG 的唯一正例?因为如果 retrieved context 与 target 几乎完全等价,RAG 的任务会退化为复制示例答案,不能测量类比迁移能力。论文选择 Structural Resonance pair,使模型必须从官方解法中抽取可迁移结构,而不是直接搬运符号。论文没有给出 Invariance、Resonance、Affinity 三种 pair 在同一 solver 上的完整对照实验,但 Table 5 的 Expert-RAG 与 Embed-RAG 差异至少说明,上下文相似度层级会影响下游推理。
指标的形式化定义:准确率、Recall@k 与检索质量边界
Problem Solving 的评分并不只是检查最终答案。Section 4.2 说明 MATHNET 采用类似 IMO-Bench 的模型评分:GPT-5 作为 judge,基于题目、参考解答和模型解答给出 0 到 7 分,再将分数二值化。可以把它形式化为:
其中 是测试题数, 是第 道题由 judge 给出的整数分数,取值来自 0、1、6、7 等评分档位, 是指示函数。这个式子在论文中的作用是把“证明过程质量”压成一个 benchmark accuracy,而不是只看 boxed answer。它比 exact-match 更接近奥赛评分,因为答案碰巧对但推理有严重漏洞时,judge 仍可给低分。它的边界也很明显:若阈值从 降为 ,大量 partial progress 会被错误计为正确;若升为 ,则许多合理但有小瑕疵的解法会被过度惩罚。论文选择阈值 6,本质上是在“完全正确”和“几乎正确”之间取一个保守边界。
Math-Aware Retrieval 的核心指标是 Recall@k。对每个 anchor problem ,MATHNET 构造一个等价正例 ,并用 embedding similarity 排序候选问题。可写为:
其中 是 anchor 集合, 在 MathNet-Retrieve 中为 10,000, 表示正例 在该 anchor 的候选排序中的位置。这个式子定义了任务是否成功:只要 top-k 中出现等价正例,就记为命中。相比生成式解题,Recall@k 更直接暴露 representation 的缺陷:模型可能生成正确答案,却仍无法把等价题排到前面。若把 增大,命中变容易,但任务会退化为“只要捞进候选池就行”;若把 压到 1,则真正要求 embedding 区分数学等价与表面相似。论文 Table 4 同时报告 R@1 与 R@5,并强调 R@1 极低,而正文又提到 Recall@10 在部分领域可超过 80,这恰好说明问题不是“完全找不到”,而是 top 排序被 near-miss 错误干扰。
数据构造与质量控制:官方文档、三段式提取与人工核验
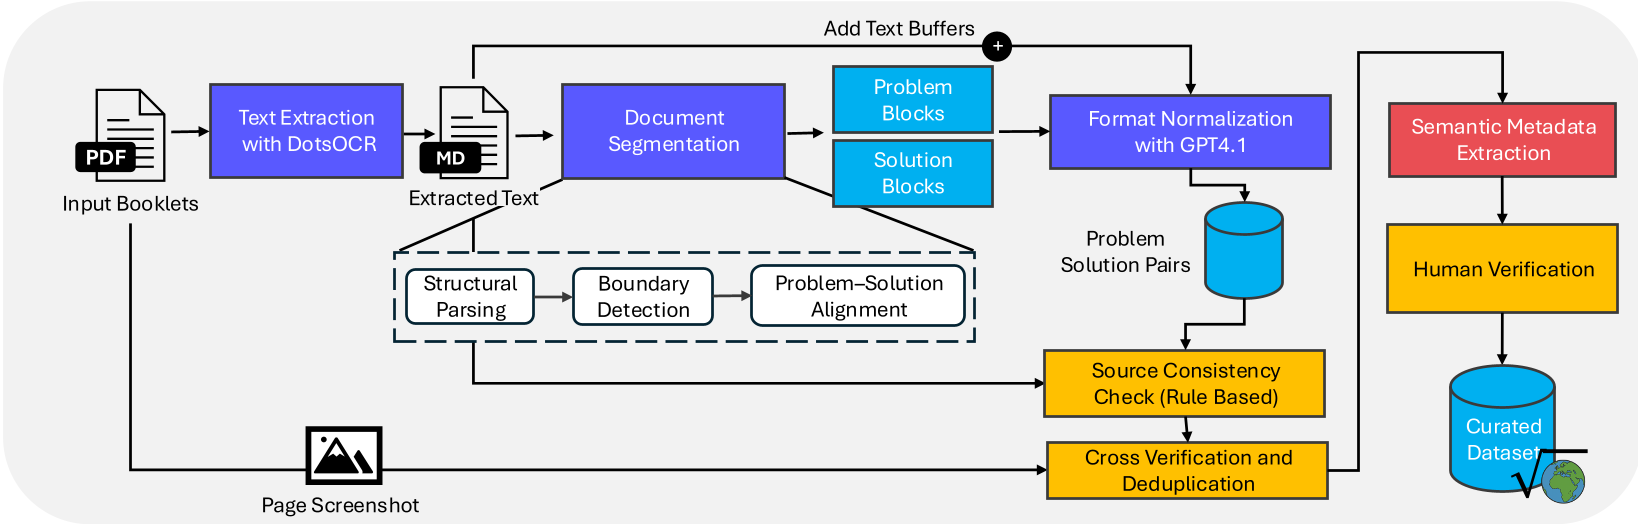
MATHNET 的数据基础不是 AoPS 社区帖子,而是官方题册。Section 3.2 报告数据收集范围为 1985 至 2025 的 47 个国家材料,包含 1595 份 PDF volumes 和超过 25,000 页。这一步很重要,因为官方材料保证题目与解答由国家队或竞赛组织作者撰写,风格一致,且不像社区平台那样混入非正式讨论、多人改写和噪声标注。论文随后用多语言 document parsing framework dots-ocr 将不同版式转为 Markdown,再用 LLM pipeline 对齐问题与解答。
提取流程分为三个阶段。Stage 1 是文档摄取和问题分段,使用 Gemini-2.5-Flash 识别问题和解答所在行号,并记录作者、提示、来源文件和页码。Stage 2 使用 GPT-4.1 从定位片段中提取 LaTeX-friendly 的问题与解答,并保留前后 buffer text 以避免截断。Stage 3 使用 rule-based analytical checker、GPT-4.1 screenshot judge 和人工 annotator 进行验证,只有三方一致同意才保留。这样的质量控制直接服务于 benchmark 可信度:如果提取出的“官方解答”本身不完整或错配,后续 judge 评分会被污染。
MathNet-Retrieve 的构造则更直接地针对 retrieval failure mode。论文用 10,000 个 anchor problems,对每个 anchor 用 GPT-5 生成 1 个 equivalent positive 和 3 个 hard negatives,形成 40,000 个 synthetic problems。可以形式化为:
其中 是原始题目, 是数学等价正例, 到 是保持表层形式但改变数学结构的负例。这个式子定义了评测集合的最小单元:不是普通 query-document pair,而是一个正例与三个近邻错误例共同构成的困难候选环境。如果 被替换成随机无关题,任务会退化成关键词匹配;如果只保留 positive,则无法检验模型是否被 subtle symbolic perturbation 误导。hard negative 的意义正在于此:它让 Recall@1 失败变得可解释。
MATHNET 三个组件的总体结构可以用下面这张表概括:
| 组件 | 规模 | 支撑任务 |
|---|---|---|
| MathNet-Solve | 30,676 道题,train 23,776、test 6,400、test-hard 500 | Problem Solving |
| MathNet-Retrieve | 10,000 anchors,1 个等价正例和 3 个 hard negatives,共 40,000 synthetic problems | Math-Aware Retrieval |
| MathNet-RAG | 35 anchors 与 35 个 expert-paired real problems,共 70 problems | Retrieval-Augmented Problem Solving |
这张表说明 MATHNET 不是一个只给题号和答案的集合,而是把数据分成三种评测角色: Solve 用于测 solver,Retrieve 用于测 embedding,RAG 用于把两者连起来。论文没有给出 MathNet-Retrieve 中人工标注者对 synthetic pairs 的不一致率,但 Section 6 提到 expert annotators reviewed problem similarity labels,因此数据构造不是纯自动生成的闭环,而是带有专家核验层。
实验与证据
主结果:解题能力快速进步,但几何与离散仍难
Table 3 报告了 Problem Solving Accuracy 在 MathNet-Solve-Test 上的结果,包含 Algebra、Number Theory、Geometry、Discrete Math 四个 domain,以及 Macro Avg 和 Micro Avg:
| 模型类别 | 模型 | Algebra | Number Theory | Geometry | Discrete Math | Macro Avg | Micro Avg |
|---|---|---|---|---|---|---|---|
| LLM text-only | ministral-3B | 6.4 ± 1.0 | 2.9 ± 0.9 | 4.3 ± 0.8 | 1.7 ± 0.6 | 4.4 ± 0.5 | 4.4 ± 0.5 |
| LLM text-only | DeepSeek-V3.2 | 51.6 ± 2.0 | 45.3 ± 2.6 | 32.2 ± 1.8 | 32.7 ± 2.1 | 40.1 ± 1.2 | 40.1 ± 1.2 |
| LLM text-only | grok-3 | 37.7 ± 1.9 | 33.0 ± 2.3 | 21.7 ± 1.6 | 24.2 ± 1.9 | 28.5 ± 1.1 | 28.5 ± 1.1 |
| LMM | Llama-4-Maverick-17B | 22.5 ± 1.7 | 14.4 ± 1.8 | 10.7 ± 1.2 | 8.6 ± 1.3 | 14.7 ± 0.9 | 14.7 ± 0.9 |
| LMM | gpt-4.1 | 29.4 ± 1.8 | 24.0 ± 2.2 | 15.7 ± 1.4 | 16.6 ± 1.7 | 21.4 ± 1.0 | 21.4 ± 1.0 |
| LMM | gpt-4o | 10.9 ± 1.2 | 7.0 ± 1.3 | 4.5 ± 0.8 | 4.2 ± 0.9 | 6.8 ± 0.6 | 6.8 ± 0.6 |
| Reasoning LLM | DeepSeek-R1 | 46.1 ± 2.0 | 39.5 ± 2.5 | 31.2 ± 1.8 | 27.3 ± 2.0 | 36.3 ± 1.2 | 36.3 ± 1.2 |
| Reasoning LMM | gemini-3.1-pro-preview | 83.7 ± 1.5 | 82.2 ± 2.0 | 74.6 ± 1.7 | 75.6 ± 2.0 | 78.4 ± 1.0 | 78.4 ± 1.0 |
| Reasoning LMM | gemini-3-flash-preview | 77.7 ± 1.7 | 73.3 ± 2.3 | 67.0 ± 1.8 | 64.0 ± 2.2 | 70.4 ± 1.1 | 70.4 ± 1.1 |
| Reasoning LMM | gemini-2.5-flash | 50.5 ± 2.0 | 42.6 ± 2.5 | 36.8 ± 1.8 | 31.0 ± 2.1 | 41.1 ± 1.2 | 41.1 ± 1.2 |
| Reasoning LLM | gpt-5 | 80.3 ± 1.6 | 73.6 ± 2.3 | 61.1 ± 1.9 | 65.3 ± 2.2 | 69.3 ± 1.1 | 69.3 ± 1.1 |
| Reasoning LLM | gpt-5-mini | 67.6 ± 1.8 | 61.5 ± 2.6 | 50.3 ± 2.0 | 50.2 ± 2.3 | 57.0 ± 1.2 | 57.0 ± 1.2 |
| Reasoning LLM | gpt-5-nano | 53.9 ± 2.0 | 49.6 ± 2.6 | 32.4 ± 1.8 | 34.6 ± 2.1 | 42.2 ± 1.2 | 42.2 ± 1.2 |
| Reasoning LLM | claude-opus-4.6 | 53.2 ± 2.0 | 44.6 ± 2.5 | 44.3 ± 1.9 | 36.4 ± 2.2 | 45.7 ± 1.2 | 45.7 ± 1.2 |
Table 3 的核心信息不是某个模型比另一个高几个点,而是分层非常剧烈。gemini-3.1-pro-preview 的 Micro Avg 为 78.4,gpt-5 为 69.3,而 ministral-3B 只有 4.4;仅从表中数字看,首尾差值达到 74.0 个百分点。更值得注意的是 domain 不均衡:gemini-3.1-pro-preview 在 Algebra 上为 83.7,Number Theory 上为 82.2,但 Geometry 降至 74.6,Discrete Math 降至 75.6;DeepSeek-V3.2 的 Algebra 为 51.6,Geometry 只有 32.2。这说明即便 frontier reasoning models 在符号代数和数论上进步很大,几何图形推理与离散结构搜索仍是瓶颈。
Appendix D 的 Table 9 与 Table 10 进一步给出 sensitivity 证据。Table 9 显示 gemini-3.1-pro-preview 在 text+images 子集上达到 85.1,高于 full set 的 78.4;gpt-5 的 text+images 为 72.0,也高于 full set 的 69.3。Table 10 显示跨语言结果并不均匀:gemini-3.1-pro 在 Chinese 上为 64.2,而在 English 上为 77.4;DeepSeek-R1 在 Chinese 上仅为 7.3,English 上为 35.8。这组数字意味着 benchmark 的 multilingual 和 multimodal 设计不是装饰,而会真实影响排序和绝对分数。
检索结果:Top-1 几乎失败,问题不在找不到,而在找错
Table 4 报告 MathNet-Retrieve 上的 Recall@1 和 Recall@5。数值如下:
| 模型 | 代数 R@1 | 代数 R@5 | 数论 R@1 | 数论 R@5 | 几何 R@1 | 几何 R@5 | 离散 R@1 | 离散 R@5 | 全部 R@1 | 全部 R@5 |
|---|---|---|---|---|---|---|---|---|---|---|
| all-mpnet-base-v2 | 4.54 | 73.06 | 4.67 | 82.54 | 4.37 | 74.76 | 4.25 | 75.38 | 3.78 | 57.70 |
| multi-qa-mpnet-base-dot-v1 | 4.00 | 69.40 | 3.73 | 80.76 | 3.88 | 71.73 | 3.98 | 73.40 | 3.27 | 55.08 |
| cohere-embed-v4.0 | 2.73 | 59.85 | 2.67 | 68.85 | 2.35 | 59.87 | 2.78 | 63.40 | 2.24 | 44.81 |
| qwen3-embedding-4B | 5.24 | 78.74 | 4.62 | 86.43 | 5.60 | 79.05 | 5.96 | 81.50 | 4.96 | 64.95 |
| gemini-embedding-001 | 5.50 | 81.62 | 4.95 | 87.43 | 5.49 | 81.86 | 5.35 | 82.80 | 4.83 | 68.88 |
| text-embedding-ada-002 | 2.05 | 54.94 | 2.22 | 63.35 | 2.16 | 55.07 | 2.71 | 57.51 | 1.94 | 42.02 |
| text-embedding-3-small | 2.10 | 47.47 | 1.89 | 54.62 | 2.10 | 47.61 | 2.84 | 50.12 | 1.98 | 35.49 |
| text-embedding-3-large | 3.19 | 68.18 | 2.73 | 75.25 | 3.20 | 68.18 | 3.35 | 69.52 | 2.74 | 54.23 |
Table 4 揭示出一个非常尖锐的落差:最强的两个 embedding 模型在 All R@1 上也只有 4.96 和 4.83,几乎相当于随机猜测量级;但 All R@5 上升到 64.95 和 68.88。这说明等价题并非完全无法进入 top 候选,而是被大量 hard negatives 挤压到 1 名之后。论文正文还称 Recall@10 在多个领域超过 80,且 gemini-embedding-001 的 Recall@10 为 83.79。这个现象比单纯低分更有诊断价值:embedding 模型具备某种“语义附近”的能力,但 top-1 决策极易受表层符号影响。
失败机制在 Section 4.3.2 和 Figure 6 中解释得比较清楚。Figure 6 展示了等价题与 near-miss hard negatives 的 cosine similarity distribution。论文文字指出 non-equivalent pairs 有时比 equivalent pairs 获得更高 similarity,这意味着 embedding 空间里的距离排序与数学等价排序不一致。模型可能把包含相同关键词、相似句式和接近公式的题目误判为更相关,而对真正只做了变量重命名或代数变形的题目排序靠后。
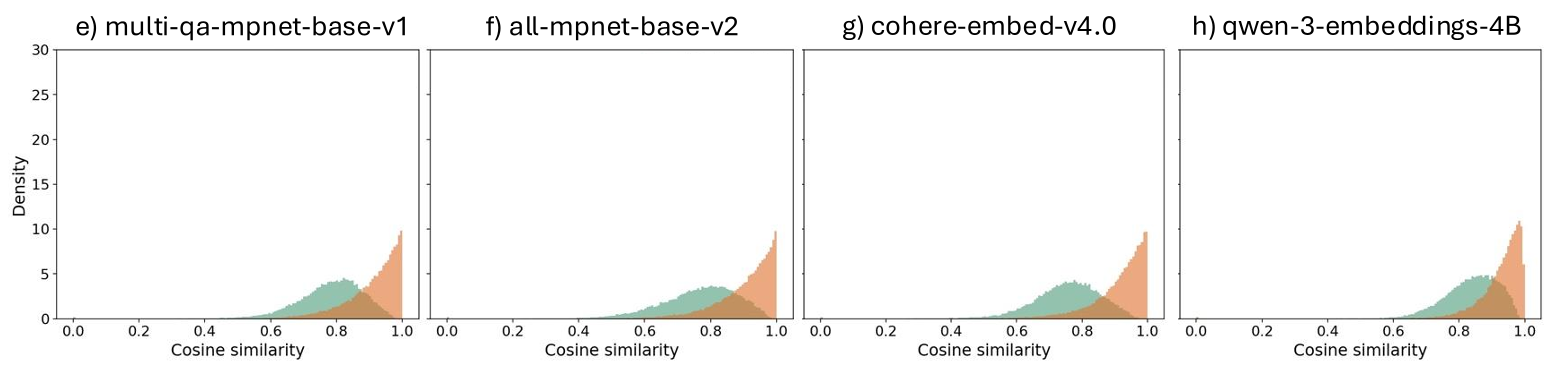
这组证据对 embedding 训练提出了具体要求。若要提升 Recall@1,最直接的路线不是增加普通 contrastive negatives,而是增加数学 hard negatives:变量重命名不变、结构不变但符号微扰、局部表达式相似但全局不变量不同。MATHNET-Retrieve 已经提供了这种 quadruplet 结构,但论文没有训练新的 math-aware embedding,而是把缺口留给社区。
RAG 结果:有效上下文能提升,但嵌入检索不稳定
Table 5 报告 MathNet-RAG 上 Retrieval-Augmented Problem Solving 的结果,使用 35 problems,同时给出 human grading 和 LLM grading:
| 模型 | Human Zero | Human Embed-RAG | Human Expert-RAG | LLM Zero | LLM Embed-RAG | LLM Expert-RAG |
|---|---|---|---|---|---|---|
| DeepSeek-V3.2-Speciale | 84.8 ± 6.1 | 89.5 ± 5.2 | 97.3 ± 2.7 | 82.2 ± 6.5 | 87.9 ± 5.5 | 89.0 ± 5.3 |
| Claude-4.5-Opus | 46.8 ± 8.4 | 55.5 ± 8.4 | 52.4 ± 8.4 | 46.0 ± 8.4 | 50.3 ± 8.5 | 56.4 ± 8.4 |
| oLMO-3-Think | 45.2 ± 8.4 | 54.6 ± 8.4 | 47.6 ± 8.4 | 49.5 ± 8.5 | 45.6 ± 8.4 | 51.1 ± 8.4 |
| Grok-4.1-Fast | 75.4 ± 7.3 | 83.8 ± 6.2 | 83.2 ± 6.3 | 73.1 ± 7.5 | 67.7 ± 7.9 | 69.1 ± 7.8 |
| Gemini-3-Pro | 89.1 ± 5.3 | 92.9 ± 4.3 | 87.5 ± 5.6 | 73.2 ± 7.5 | 70.5 ± 7.7 | 76.4 ± 7.2 |
| GPT-5 | 76.8 ± 7.1 | 75.2 ± 7.3 | 86.6 ± 5.8 | 87.1 ± 5.7 | 81.8 ± 6.5 | 85.8 ± 5.9 |
| Phi-4-Reasoning Plus | 15.1 ± 6.1 | 14.3 ± 5.9 | 16.7 ± 6.3 | 24.1 ± 7.2 | 19.6 ± 6.7 | 30.0 ± 7.7 |
Table 5 的主结论是:Expert-RAG 是最强的整体设置,但提升并不单调。DeepSeek-V3.2-Speciale 从 Human Zero-shot 的 84.8 上升到 Human Expert-RAG 的 97.3,差值约 12.5 个百分点;GPT-5 从 76.8 上升到 86.6,也表现出明显的专家上下文收益。与此同时,Gemini-3-Pro 在 Human grading 下 Embed-RAG 为 92.9,高于 Expert-RAG 的 87.5;GPT-5 在 Human grading 下 Embed-RAG 为 75.2,甚至低于 Zero-shot 的 76.8。这说明 retrieved context 如果与 target 不真正结构对齐,可能引入噪声。
LLM grading 和 human grading 的差异进一步说明结论强度有限。Table 11 比较了 LLaMA-4、DeepSeek-V3、GPT-4.1、GPT-4o 四个 graders 与 human expert grading。例如 gemini-3-pro-preview 的 Human Zero-shot 为 89.1,而 LLM Avg 为 73.1;gpt-5 的 Human Zero-shot 为 76.8,而 LLM Avg 为 87.1。不同 grader 对同一 solver 的打分可相差十几个百分点。论文没有提供所有 solver 在全部 domain 和全部语言上的完整 LLM grader 表,但 Table 11 足以提醒读者:MathNet-RAG 的模型排名受到 grader 选择影响。
证据质量方面,Table 4 支撑的 retrieval 失败较为稳健,因为它覆盖 10,000 anchors 和多个 domain,且 Recall@1 与 Recall@5 的落差符合 Figure 6 的分布解释。Table 3 的 problem solving 结果也覆盖 6,400 道测试题,规模足够。相较之下,Table 5 的 RAG 结论只基于 35 problems,standard error 普遍在 5 到 8 个百分点左右,某些模型提升幅度与误差范围同量级。因此 Expert-RAG 的优势应理解为机制性证据,而不是严格显著的统计效应。论文也没有给出 formula-aware baseline 在 Section 4 主结果中的完整表格,但 Discussion 提到 structured representations 对 retrieval 重要,这留下了后续对照空间。
深度洞察与总结
MATHNET 最重要的学术贡献是把“数学检索”与“数学生成”从同一个含糊的 reasoning 标签下拆出来。生成模型可以在答案上表现出强推理,但 embedding 模型仍无法稳定识别等价类;反过来,RAG 实验表明,只有当检索到的上下文真正属于 Structural Resonance 层级时,solver 才会获得一致收益。这让后续研究有了一个更清晰的分工:solver 负责利用上下文,retriever 负责提供上下文,benchmark 负责测量两者是否共享数学结构。
它的局限性同样具体。第一,MathNet-RAG 的 35 对专家题非常小,Table 5 中多个结论受 standard error 限制,不能把某个模型在 Expert-RAG 的排名视为稳定 leader。第二,MathNet-Retrieve 的 synthetic positives 和 hard negatives 由 GPT-5 生成,论文说明有人类专家 review similarity labels,但没有给出人工复核样本量、错误率或标注者一致性,因此 equivalence gold label 的噪声仍需要后续量化。第三,Section 4 的主结果没有完整报告公式感知 baseline 或符号图检索 baseline,而 Discussion 又强调 structured representations 的关键作用,这使论文的诊断比解决方案更有力。
未来最有技术含量的方向不是继续堆更大的 math dataset,而是把 MATHNET-Retrieve 的四元组结构用于训练 math-aware embeddings:用 anchor、positive 和 hard negatives 构造 contrastive objective,让 embedding 学习变量重命名不变性、代数变形等价性和 near-miss 可分性。另一个方向是把 MathNet-RAG 的 taxonomy 从 35 对扩展到更大规模,并加入不同 Invariance 与 Resonance 层级的 controlled retrieval,以判断 solver 提升究竟来自 example answer,还是来自 structural analogy。MATHNET 真正打开的问题不是“模型会不会解题”,而是“模型能否在数学对象之间建立可检索、可迁移、可验证的等价关系”。