
MatSciBench:当 LLM 遇上材料科学,推理的极限在哪里?
MatSciBench: Benchmarking the Reasoning Ability of Large Language Models in Materials Science
本文推出了 MatSciBench:一个针对材料科学领域设计的大规模大学水平推理基准测试。该基准包含 1,340 个问题,涵盖 6 大核心领域及 31 个细分学科,是目前评估 LLMs 在跨学科科学推理和多模态理解(包含 315 个图像问题)方面最全面的工具。
TL;DR
材料科学是物理、化学与工程的交汇点,要求模型不仅具备扎实的领域知识,还要能看懂复杂的相图和应力曲线。本文介绍的 MatSciBench 通过 1340 个专家级问题,揭示了当前顶尖模型(如 DeepSeek-R1, GPT-5)在材料推理上的真实水位。结论是:思考型模型(Reasoning Models)虽强,但在面对科学图表和复杂计算时仍有明显短板。
背景定位:填补科学推理的最后一块拼图
在大语言模型(LLM)狂飙突进的今天,我们已经有了 GSM8K 测数学,GPQA 测研究生水平知识。但在“材料科学”这个极端依赖多维数据和逻辑链条的领域,一直缺乏深度基准。MatSciBench 的出现,为 LLM 在硬核工程领域的应用划定了标尺。
痛点深挖:为什么材料推理这么难?
- 跨学科门槛:一个关于“钢合金弹簧屈服强度”的问题,需要同时调用力学性能、材料类别和失效机制。
- 图像识别的“差之毫厘”:与日常图像不同,材料科学的相图、力学曲线图(Mechanical Plot)要求极高的数值读取精度,目前多模态模型在此溢出大量错误。
- 自以为是的修正:研究发现,模型在没有外部反馈的情况下进行“自我修正”,往往会因为 false critique(错误的自我批评)毁掉原本正确的思路。
方法论详解:精细化的评估坐标系
作者将 MatSciBench 划分为 6 个主领域(如失效机制、加工工艺等)和 31 个子领域。
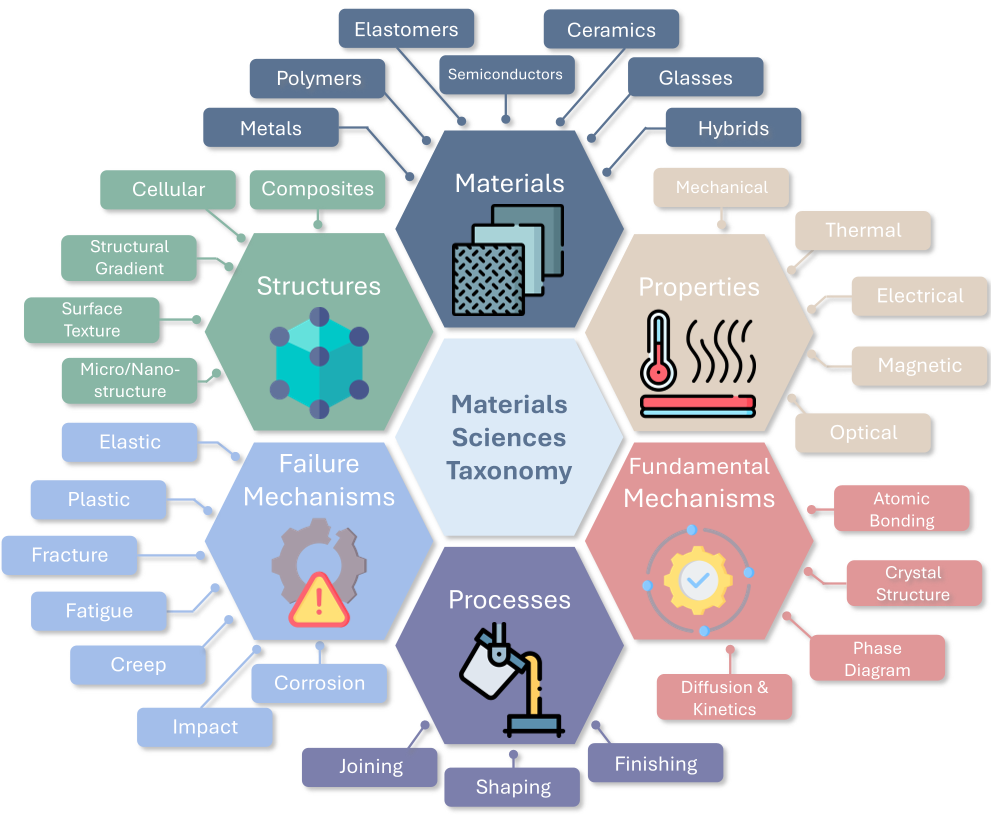 上图展示了 MatSciBench 的分类结构,覆盖了从晶体结构到失效分析的全生命周期。
为了验证模型推理的深度,作者引入了难度分级。由 6 个顶级模型(如 Claude 3.7, GPT-4.1)对推理长度进行加权投票,将题目分为 Easy, Medium 和 Hard。这种方式规避了单一模型偏见,更真实地反映了任务复杂性。
实验与结果:DeepSeek-R1 与 GPT-5 的巅峰对决
1. 纯文本推理:思考型模型的统治力
在纯文本测试中,DeepSeek-R1 表现惊艳,以 75.22% 的准确率略胜 GPT-5(75.02%)。这证明了通过强化学习增强推理链条(Long CoT)对于解决多步材料计算任务极为有效。
2. 多模态挑战:GPT-5 守住底线
一旦引入图表,所有模型的表现均出现断崖式下跌。
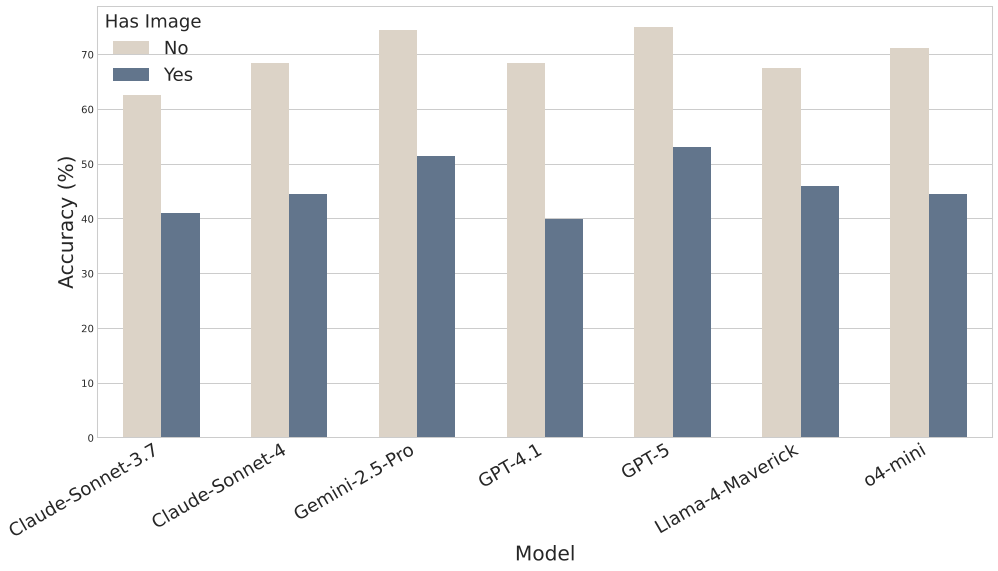 如图所示,图像语境下的准确率远低于纯文本。GPT-5 在此项上保持了行业第一,但 53% 的准确率离实际工程应用还有很大距离。
3. 工具增强 vs. 自我修正
一个有趣的洞察是:给模型配备 Python 解释器(Tool Augmentation)能够显著降低计算错误,使其在较短的 Token 成本下达到极高准确率。而自我修正(Self-correction)在 4/5 的非思考型模型中导致了性能下降,尤其在简单题目上,“想太多”反而出错。
深度洞察:瓶颈在何处?
通过对失败案例的定性分析,作者总结了四大痛点:
- 领域知识断层:模型有时分不清特定合金的微观结构与其性能的对应关系。
- 数值精度溃败:特别是在力学曲线图中,模型无法从像素级刻度中提取精确压力值。
- 逻辑断路:在 Hard 难度下,即使是思考型模型也容易在复杂的公式推导中丢失变量约束。
总结与展望
MatSciBench 的发布不仅是一个数据集,更是一个行业警示:长推理(Long CoT)并非万能药。对于材料科学这类高精尖领域,未来的方向应该是:
- 领域图文对齐:提升 MLLM 对科学坐标轴和专业图表的解析力。
- 可靠的验证器:用外部专业的材料数据库或仿真软件作为 LLM 推理的“反馈源”,替代不靠谱的自我审查。
材料基因组计划(MGI)的 AI 化进程,仍需在这些硬核基准上不断磨砺。