
PALU:精准外科手术式的 LLM 遗忘策略,只动前缀也能彻底抹除隐私
Maximizing Local Entropy Where It Matters: Prefix-Aware Localized LLM Unlearning
本文提出了 PALU (Prefix-Aware Localized Unlearning),一种针对大语言模型(LLM)的局部熵最大化遗忘学习框架。该方法通过在时间维度锁定敏感前缀(Prefix)并在词表维度锁定 Top-K Logits,实现了在保持模型通用能力的同时,高效切割敏感知识的生成路径。
TL;DR
传统的 LLM 遗忘算法往往像“割草”,把整个句子的概率全部压低,结果导致模型变傻(通用能力受损)。PALU 提出了一种全新的“微创手术”方案:通过锁定触发泄密的敏感前缀和词表中分量最重的 Top-K Logits,利用局部熵最大化让模型在关键时刻陷入“迷茫”,从而在不伤及模型元气的前提下,干净地切断敏感信息的生成路径。
痛点深挖:为什么简单的“禁言”行不通?
在 GDPR 等法规要求下,让模型“忘记”特定数据已成为刚需。但目前的 SOTA 方法(如 NPO, TPO)普遍存在两个盲区:
- 全局优化的冗余性:一句话里大部分是助词和连词,遗忘算法却对所有 Token 一视同仁地算梯度,这既费算力又容易破坏语言的流畅性。
- “野火烧不尽”的语义逃逸:使用负向交叉熵(Negated CE)抑制了某个名字,模型可能会立刻跳出一个近义词或变体来替代,因为你只是压低了最高点,而没有改变词表分布的内部结构。
核心直觉:双重稀疏性 (Dual-Sparsity)
PALU 的核心观点非常硬核:
- 时间上的稀疏性:LLM 的生成是单向因果的。只要我们通过干预最初的几个“关键触发词”(Initiating Tokens),就能让后续的生成轨迹发生偏转。
- 词表上的稀疏性:解码时,真正起作用的只有那几个高概率词。只需把这 Top-K 个词的 Logits 拉平,就能制造足够大的混乱。
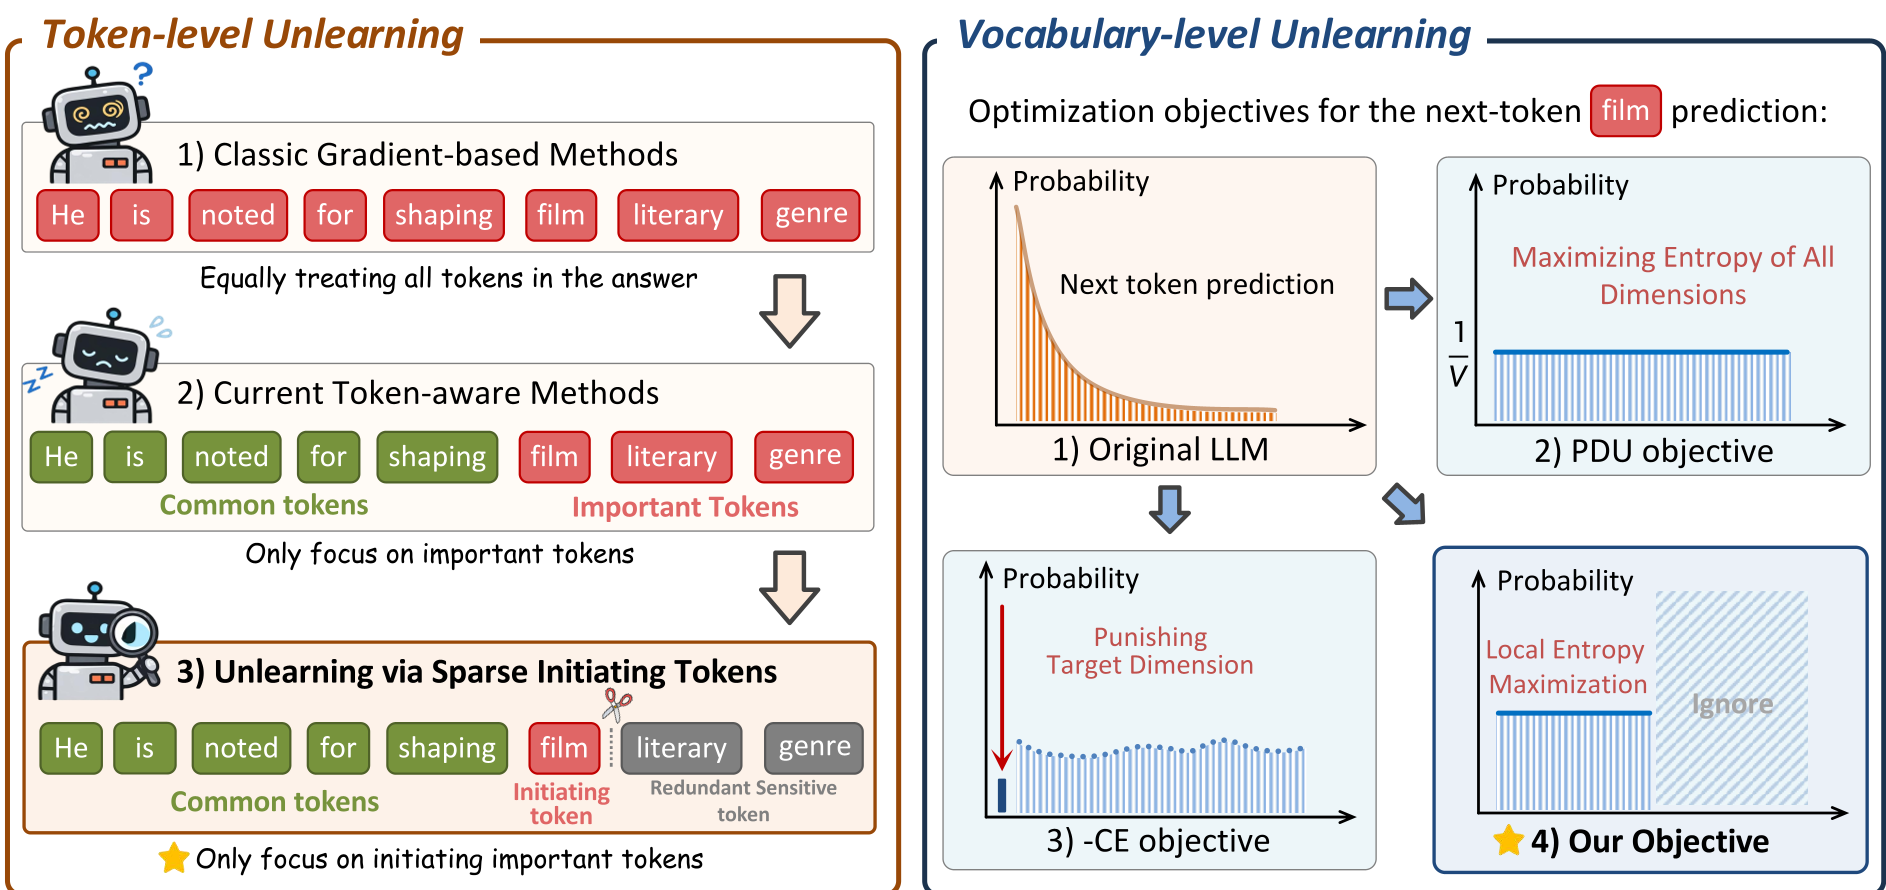 图 1:PALU 的双重局部化策略。左侧展示了 Token 级别的筛选,右侧展示了词表级别的局部熵增强策略。
技术解构:局部熵最大化 (LEM)
为了实现高效遗忘且不产生副作用,PALU 设计了一个局部遗忘损失函数 :
这里的物理含义是:
- 消除方差:让 Top-K 个 Logits 趋向于同一个目标值 (通常是全局均值),从而消除它们之间的显著性。
- 掩埋信号:将敏感词“埋入”背景噪声中。当模型在第 个位置左右为难时,它自然就会放弃原本的泄密路径,转向生成其他无关内容。
实验结果:鱼与熊掌可以兼得
在 TOFU 榜单的评估中,PALU 展现了极强的统治力:
- 极限性能:在 Llama-3.1-8B 上,它的遗忘质量(Forget Quality)达到了 SOTA。
- 保底能力:在最难的 10% 遗忘测试中,其他模型性能大幅滑坡,而 PALU 依然稳健。
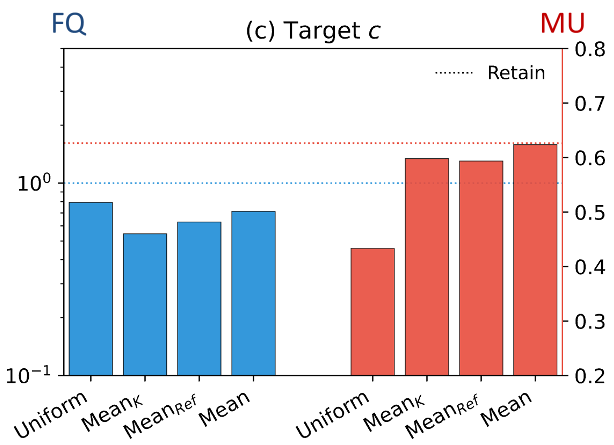 图 2:消融实验显示,仅需选 3 个前缀 Token 和 5000 个 Logits,性能就能达到全量优化的水平,验证了双重稀疏性的价值。
此外,PALU 在防御成员推理攻击(MIA)方面的表现也非常亮眼,泄露指标(LOSS)甚至低于直接重新训练的模型(Retain Model),实现了所谓的“深层遗忘”。
总结与洞察
PALU 的成功告诉我们:遗忘不是为了消灭概率,而是为了制造均匀的迷茫。
这种基于物理分布直觉的设计,避开了昂贵的全局计算,不仅在学术上提供了优雅的解释(局部熵最大化),在工程上也为大规模 LLM 的在线合规化提供了可落地的路径。不过,目前该方法还局限于文本领域,未来如何应用在图像 Patch 或音频向量的遗忘中,仍是值得探索的前沿方向。
Takeaway: 精准干预敏感前缀 + Top-K 词表平滑 = 极致的 LLM 遗忘效率。