
[EMNLP 2024] NovelSum:破解指令微调数据工程的“黑盒”迷思
Measuring Data Diversity for Instruction Tuning: A Systematic Analysis and A Reliable Metric
本文提出了一种名为 NovelSum 的新型数据多样性评估指标,专门用于指令微调(Instruction Tuning)场景。通过对 11 种现有指标的系统性分析,作者构建了 NovelSum 及其配套的数据选择策略 NovelSelect,在 LLaMA-3 和 Qwen-2.5 等 SOTA 模型上实现了与模型性能高达 0.97 的相关性。
TL;DR
在指令微调(Instruction Tuning)领域,“少即是多”已成为共识。然而,如何定义这“更少但更好”的数据?复旦大学的研究团队通过系统分析发现,现有的多样性指标(如词汇占比、语义距离)与模型最终性能的相关性极低。为此,他们提出了 NovelSum 指标及 NovelSelect 策略,通过“临近加权”与“密度感知”两大机制,精准刻画样本的“新颖性”(Novelty),实现了与模型性能高达 0.97 的强相关。
背景定位:当数据精选遇上“随机迷思”
近年来,LIMA 等工作证明了高质量小规模数据不仅能降低计算成本,甚至能超越大规模杂乱数据。然而,学术界在实践中发现,很多所谓基于多样性的数据选择策略,在实际微调效果上竟然跑不过 Random Selection(随机选择)。这反映了一个底层危机:我们根本没有一个衡量 IT(Instruction Tuning)数据集多样性的可靠“标尺”。
痛点深挖:传统指标错在哪里?
作者系统评估了 11 种指标(词汇多样性、距离多样性、分布多样性),发现了三个核心痛点:
- 词汇多样性失效:简单统计词汇重复率无法区分复杂的语义逻辑。
- 忽略样本独特性:有些指标只关注全局分布,即便数据中存在大量近乎重复的样本,只要它们覆盖了空间,得分依然很高。
- 密度盲区:在数学或代码领域,相邻的样本可能包含完全不同的逻辑细节。传统基于 Embedding 的欧氏距离在这些高密度区域会严重低估样本的价值。
方法论详解:NovelSum 的双重直觉
NovelSum 的核心是将数据集的多样性定义为所有样本新颖性 (Novelty) 的加总。其数学直觉包含两个维度:
1. 临近加权 (Proximity Weighting)
作者认为,一个样本的新颖程度主要取决于它与“邻居”的差异。如果一个样本和它最像的几个样本都很像,那它的信息增量就很低。
- 物理含义:通过对距离排序并施加单调递减权重 ,赋予近邻点更高的权重。这有效防止了距离极远的“离群点”在加和过程中掩盖了近距离的“冗余性”。
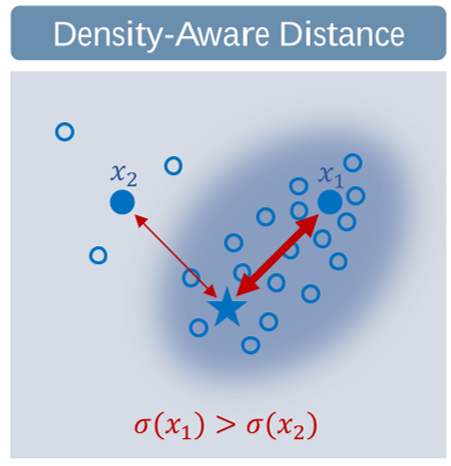
2. 密度感知 (Density Awareness)
为了解决不同任务领域(如 Coding vs. Chat)信息分布不均的问题,作者引入了密度因子 :
- 逻辑含义:如果一个区域极其密集(如海量的数学题),微小的语义位移也可能代表着本质的逻辑变化。通过密度补偿,使模型能够保留高信息量区域的细微多样性。
实验与结果:从观测到控制
作者在 LLaMA-3-8B 和 Qwen-2.5-7B 上进行了详尽的闭环验证。
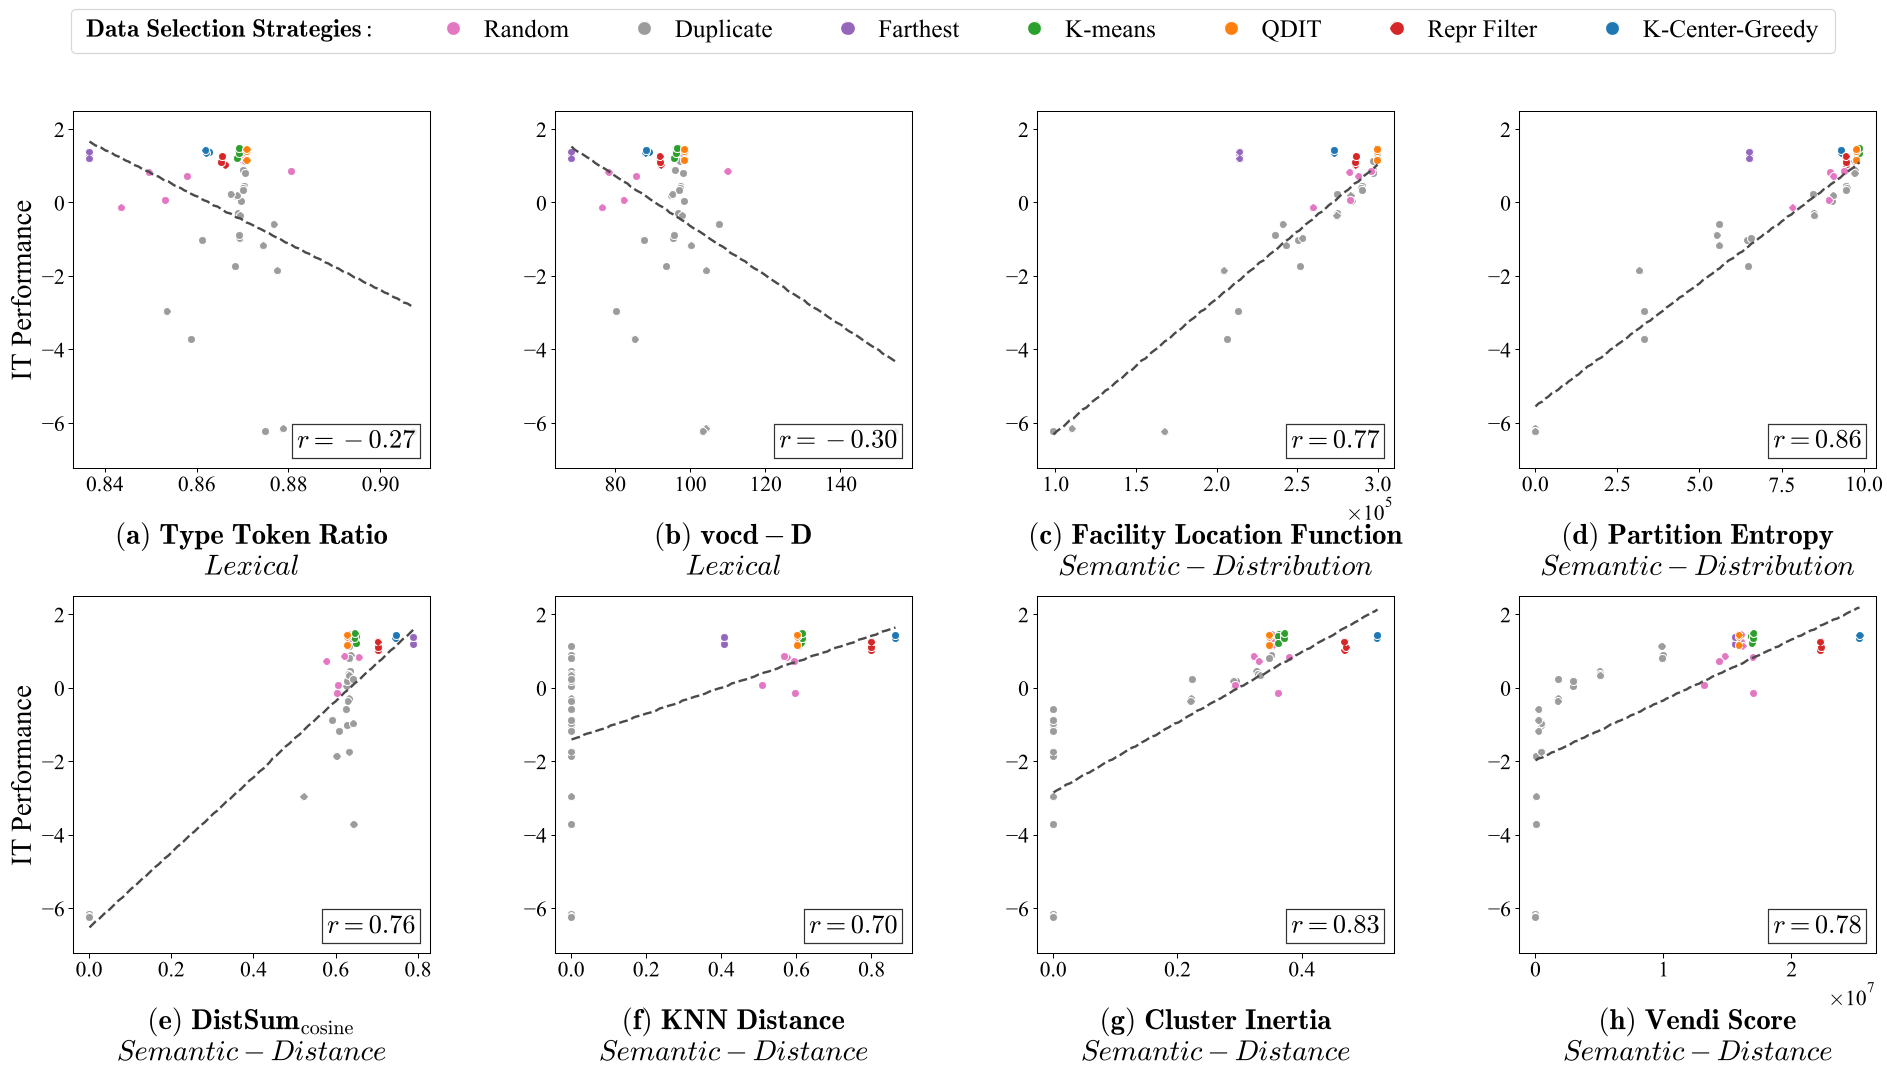
指标可靠性对比
结果显示,传统指标(如 DistSum, Vendi Score)在性能相关性上表现不稳定,而 NovelSum 在两个模型家族中均保持了 0.90 以上的 Pearson 相关系数。
数据精选实战:NovelSelect
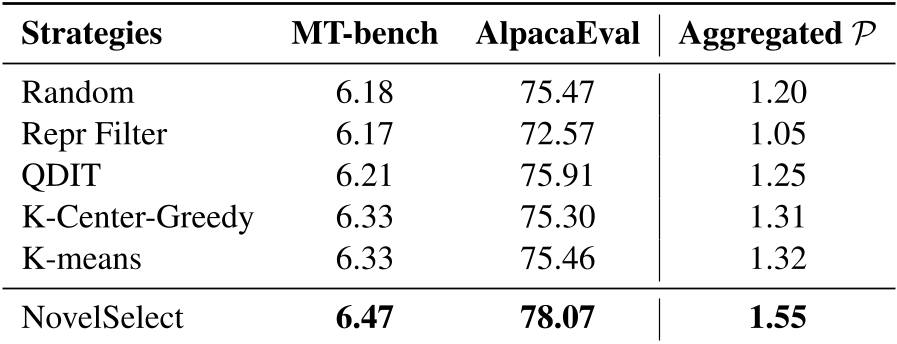
利用 NovelSum 作为优化目标,作者开发了贪心选择策略 NovelSelect。在 MT-bench 和 AlpacaEval 的综合评测中,针对 10k 规模的数据集,NovelSelect 稳定超越了 K-Center-Greedy 和 K-means 等传统强基线。
深度洞察:Embedding 也有“母语”效应
文章中一个极具启发性的发现是(见原文 Appendix E.2):使用与目标微调模型相同的 Embedding 提取器,得到的 NovelSum 相关性最高。 这暗示了不同 LLM 的语义空间存在 Inductive Bias。这意味着在进行数据工程时,最好使用你准备训练的那个模型的 Base 版本来做数据体检。
总结与局限性
NovelSum 成功地将模糊的“多样性”转化为可计算的“新颖性加和”。它不仅能告诉你数据集好不好,还能具体的告诉你哪条数据提供了最多的新信息。 局限性:目前研究主要集中在通用指令任务。对于数学、代码等极窄领域的专业化微调,可能需要更定制化的密度估计方案。同时,算力消耗虽在可控范围内,但面对亿级原始数据时,FAISS 的索引效率仍是工程落地的关键。
Takeaway: 真正的多样性不是简单的距离拉大,而是要在信息密集的瓦砾中寻找不重复的珍珠。