
MemSkill:让 Agent 像人类一样进化自己的记忆技能
MemSkill: Learning and Evolving Memory Skills for Self-Evolving Agents
本文提出了 MemSkill,一种将智能体(Agent)记忆操作重构为“可学习且可进化的记忆技能”的新范式。通过结合强化学习(RL)进行技能选择和基于大语言模型(LLM)的技能进化,MemSkill 在 LoCoMo 和 ALFWorld 等长上下文及具身智能基准测试中均取得了 SOTA 性能。
TL;DR
传统的 AI 智能体记忆管理就像是一个写死了规则的记事本,不管面对什么任务,存什么、怎么存都是固定的。MemSkill 彻底颠覆了这一逻辑:它将记忆操作定义为一套可进化的技能库(Skill Bank)。通过强化学习选择技能协助记忆提取,并利用“反馈-设计”闭环不断迭代技能本身,MemSkill 在长对话理解和具身智能任务中均打破了性能天花板。
1. 痛点:被硬编码“锁死”的记忆
目前的 LLM 智能体在处理长时交互时,通常采用特定的启发式规则(Heuristics)来决定哪些信息该留、哪些该删。这种方式存在三大弊端:
- 人类先验过强:开发者认为重要的,模型在特定任务中未必觉得重要。
- 粒度僵化:通常按回合(Turn)处理,面对超长文本时效率极低。
- 不可进化:一旦部署,记忆管理的逻辑就固定了,无法从错误中吸取教训。
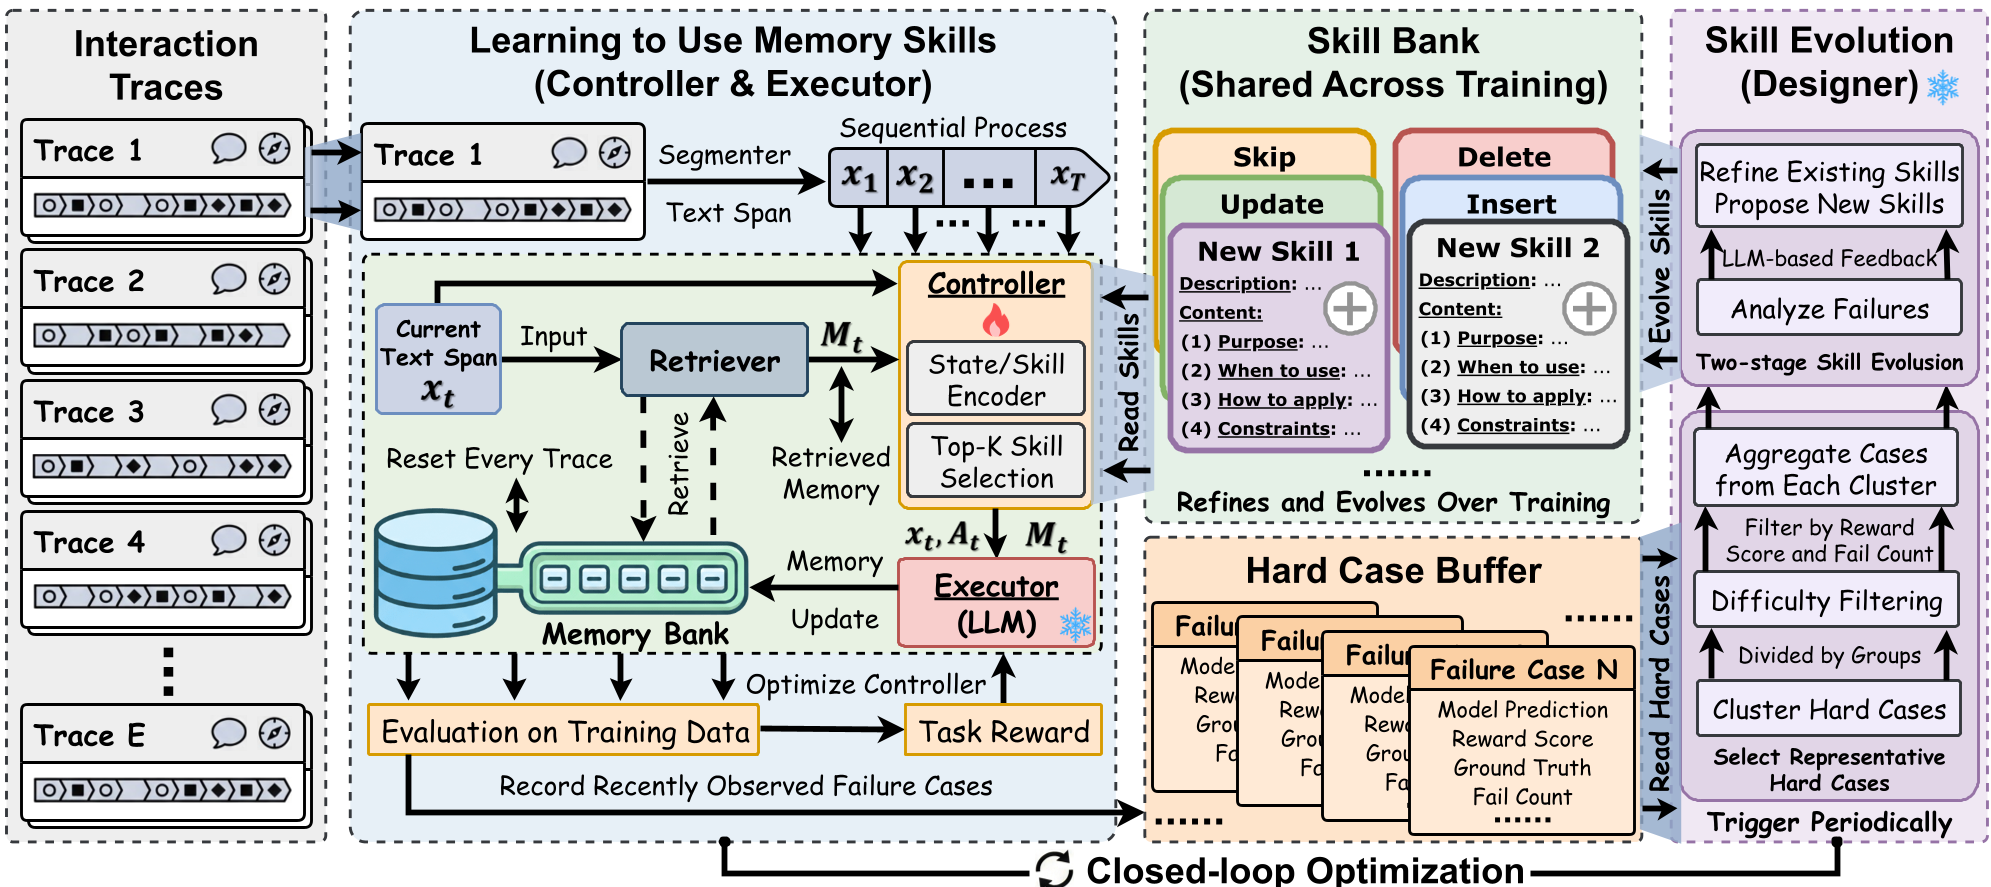
2. 核心方案:MemSkill 的三位一体架构
MemSkill 模仿了人类技能习得的过程,引入了三个核心角色:
2.1 Controller (技能调度员)
不再是盲目套用所有规则,Controller 负责根据当前的上下文(Context)和已有的记忆碎片,从技能库中挑选出最相关的 Top-K 记忆技能。它通过**强化学习(PPO)**进行训练,奖励信号直接来自于下游任务的成功率。
2.2 Executor (高效执行者)
传统的方案可能需要多次 LLM 调用来完成增、删、改。Executor 则根据 Controller 给出的技能指南,在**单次生成(One Pass)**中完成复杂的记忆构建。这不仅提高了速度,还增强了记忆的一致性。
2.3 Designer (进化设计师)
这是 MemSkill 最惊艳的地方。它会盯着那些 Agent 搞不定的“错题”(Hard Cases),分析是因为记忆没存下来,还是存得太模糊。随后,Designer 会修改旧技能的描述或发明全新的技能。
3. 技能是如何进化的?
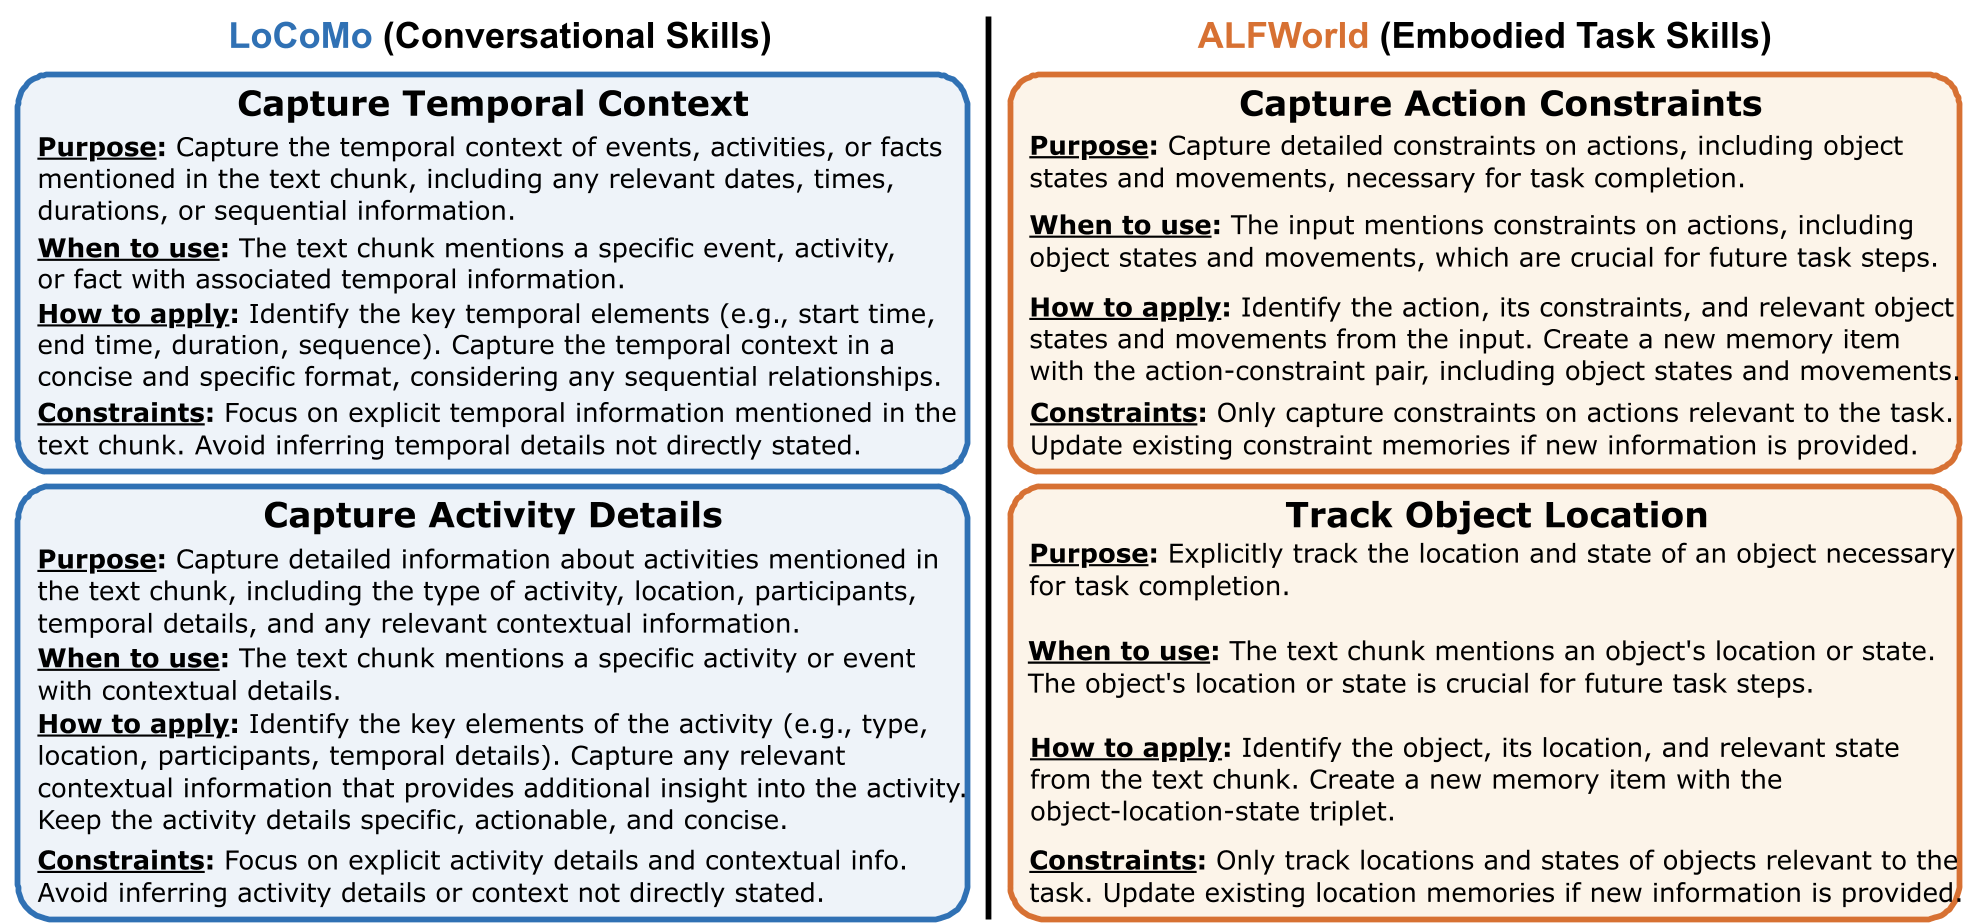
由初始的四个元动作(INSERT, UPDATE, DELETE, SKIP)开始,MemSkill 会根据不同领域长出完全不同的“技能树”。
- 在 LoCoMo(对话任务)中:进化出了“捕捉活动细节”、“提取实体细微差别”等技能,专注于人物关系和时间线。
- 在 ALFWorld(机器人任务)中:进化出了“追踪物体位置”、“捕捉动作约束”等技能,专注于环境状态的变化。
4. 实验战绩与深度洞察
在与 MemoryOS, A-MEM 等强力基线的对比中,MemSkill 展现了显著的优势:
- 跨模型泛化:在 Llama 上训练的技能库,直接搬到 Qwen 模型上依然能保持极高性能,证明了技能(Skill)这一抽象层级具有通用性。
- 消融实验验证:如果去掉 Designer(不进化技能),性能会大幅下降,这证明了静态规则的局限性。
5. 总结与展望
MemSkill 的成功告诉我们:**Agent 的能力不应仅仅通过模型参数的增加来获得,更应通过管理策略的自我演进来实现。**这种“闭环优化记忆管理”的思想,未来极有可能扩展到 Agent 的工具使用、多步推理等更广阔的认知领域。
局限性
尽管表现优异,但 Designer 的进化过程目前仍依赖于高性能 LLM 的分析,如何降低这一过程的算力成本是未来值得研究的方向。