
Metan:以不变应万变的递归元进化,打破大模型自提升的“深度魔咒”
Meta n : Recursive Self-Improvement through Emergent Depth
本文提出了 Metan,一种通过固定单一元操作 并对其累积输入进行递归调用的自主进化 Agent 框架。Metan 突破了现有自修改 Agent 因需固化驱动层而导致的“元深度瓶颈(约为 2.5 层)”,实现了由收敛状态自主决定的动态深度扩展。在包含 ARC-AGI-2、CO-Bench 等 8 个基准测试中,Metan 均显著超越了 Gödel Agent 与 OpenEvolve 等强基线,并在 ARC-AGI-2 难集上成为唯一取得非零有效得分的系统。
1. 核心速览 (Executive Summary)
TL;DR:现有自进化 LLM Agent 在尝试“修改自身”时,常陷入稳定性与元深度的两难困境——为了不把自身执行引擎改崩,必须固化底层驱动,导致实际元深度(Realized Meta-Depth)被锁死在 2.5 层以内。明尼苏达大学与首尔大学联合提出的 Metan 彻底颠覆了“修改优化器”的传统思路:固化单一元操作 ,转而对其输入进行递归。每一层 将下层栈的执行轨迹与代码包裹为新的策略前处理和辅助函数库,实现了由收敛条件动态决定的深层自进化。在包括 ARC-AGI-2、CO-Bench 等 8 项基准测试中,Metan 全面刷新 SOTA,并在 ARC-AGI-2 上成为唯一破零的系统(达到 0.331)。
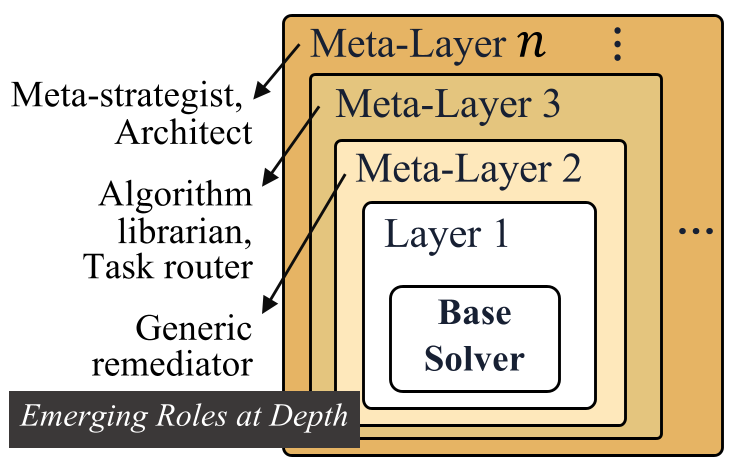
背景定位:这是自指涉系统(Self-referential Systems)自 Gödel Machine、Reflexion 和 Gödel Agent 提出以来的重要范式转移。它从架构层面解决了递归自提升的不稳定性问题,首次证明了超越两层的元深度能够在无显式指令的情况下自然涌现出分工明确的认知层级。
2. 痛点与动机 (Problem & Motivation)
人类智能的核心标志是**元推理(Meta-reasoning)**能力——跳出当前思维链条,从更高维度审视并重构解题过程。正如 Hofstadter 在《哥德尔、艾舍尔、巴赫》中所阐述的,“怪圈”(Strange Loops)是智能涌现的基石。然而,现有的自提升 LLM Agent 普遍面临严重的范式瓶颈:
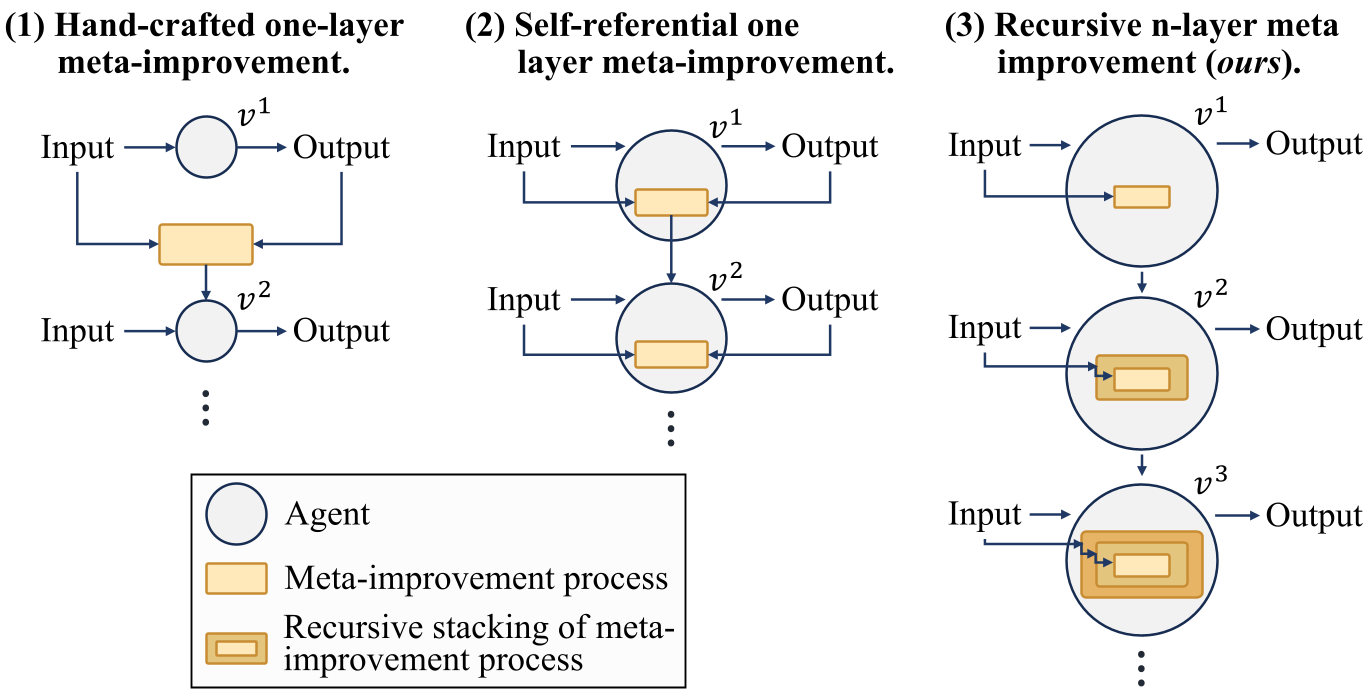
- 扁平的自我修正(Self-Refinement):像 Reflexion 等机制仅停留在“生成-评估-反思-重试”的单层循环,系统只能改进特定任务的答案(Data Level),而无法优化“改进答案的算法逻辑”。
- 人工设定的固定元系统(Hand-crafted Meta-systems):如 FunSearch、AlphaEvolve、ADAS 等,虽然引入了外部进化算法,但变异算子和选择规则是完全冻结的,元深度严格为 1。
- 自指涉 Agent 的“驱动锁死困境”:像 Gödel Agent、DGM 等允许 Agent 修改自身源码的系统,在实践中必须强制保护底层动作 API、评估循环等核心驱动(Driver)不被篡改以防崩溃。这种保护机制直接将实际元深度截断在 层。
为了打破这种“递归修改即破坏稳定”的权衡,作者提出了核心研究直觉:为什么一定要重写优化器本身?如果我们固定一个通用的元操作 ,只让它递归地吞噬自己的产出(代码与 Trace),输入信息的阶数随层数严格单调递增,系统自然能够站在越来越高的视界(Vantage Point)上进行元策略推理!
3. 方法论详解 (Methodology - The Core)
Metan 由统一元操作 、非侵入式包裹层 以及进化式归档调度器(Evolutionary Archive)构成。
3.1 元操作 与构建阶段 (Build-step)
在深度 ,系统并不修改底层求解器源码,而是调用一个全局通用的 Prompt 模板 :
- 为第 层求解器栈在所有任务上的全量执行轨迹(包含 Stdout/Stderr、退出码、得分等)。
- 为此前所有元层生成的代码栈。
- 输出的代码包 包含两个核心组件:
- 前处理函数 :注入高阶策略上下文与任务路由逻辑。
- 代码辅助库 :注入通用算法原语(如模拟退火、输出校验器等可调用函数)。
3.2 运行阶段与非侵入式包裹层 (Run-step)
执行特定任务 时,多层包裹器自外向内级联:
- 策略上下文逐层传递:最外层的 首先生成战略上下文,向内层层细化,最终汇聚为给 Base Solver 的复合引导。
- 库函数合并与覆盖:所有层级的辅助函数 统一前置注入到 Base Solver 生成的脚本中(同名函数由更深层覆盖)。
- 沙箱执行与 Trace 生成:生成深度为 的全新 Trace 。
3.3 组合覆盖与自发回滚能力
- 策略空间的乘法覆盖(Multiplicative Coverage):每一层具有 种可能行为,通过层间上下文条件约束,能够表达高达 种联合配置,远大于扁平架构的加法组合 。
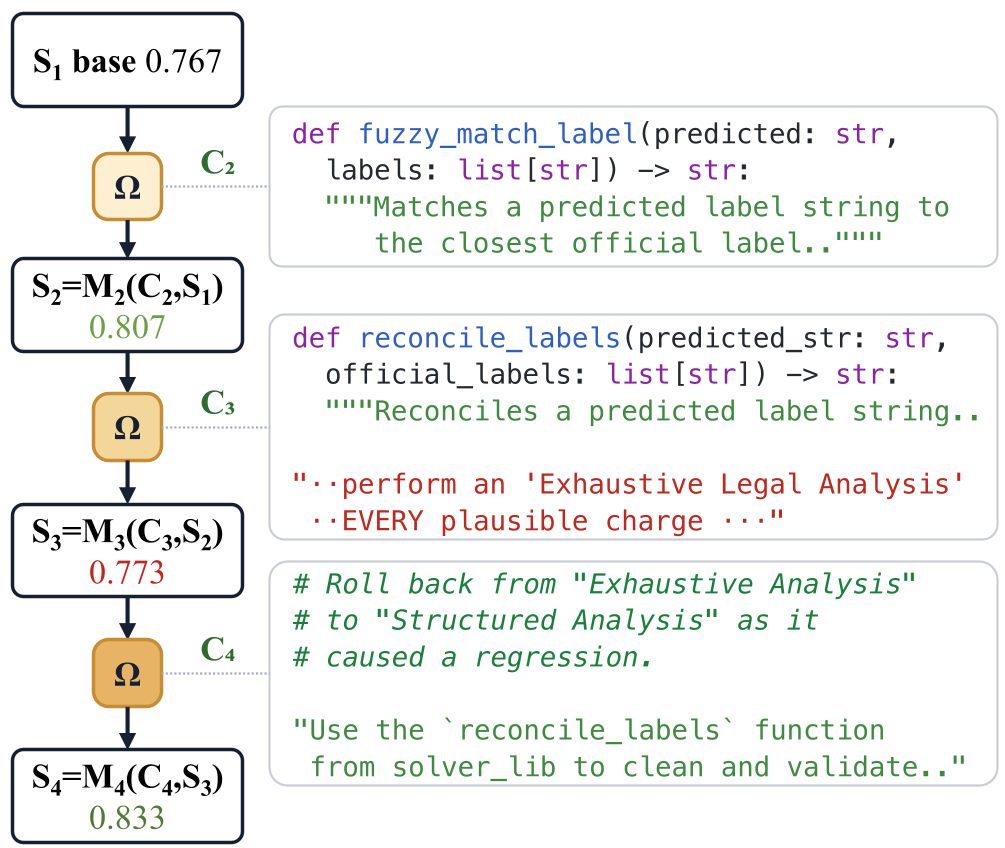
- 高阶诊断与回滚(Rollback):当第 3 层注入的严苛策略导致性能衰减时,第 4 层的 同时读取了 Trace 与第 3 层的代码 ,能够精确判定“是指令过度约束导致了回归,而辅助函数有效”,从而主动执行策略回滚(Restoration),这在只能看 Trace 的扁平 Loop 中是绝对无法实现的。
4. 实验与结果 (Experiments & Results)
实验涵盖两大骨干模型(开源 Gemma 4 31B-IT 与闭源 GPT-5.2),测试跨越 Python 算法设计(CO-Bench, AlphaEvolve Math, AlgoTune, ARC-AGI-2)、Docker 终端操作(TerminalBench 2.0)以及 Prompt 优化(LawBench, Symptom2Disease)共 8 类基准。
4.1 主流 Benchmark 全面领跑
如下表所示,Metan 在多项基准上对基线模型(OpenEvolve 与 Gödel Agent)形成了压倒性优势:
| 模型 / 方法 | CO-Bench (NP-Hard) | Symptom2Disease | LawBench (罪名预测) | AE Math | AlgoTune (加速比) | ARC-AGI-2 (Pass@2) |
|---|---|---|---|---|---|---|
| Gemma 4 31B-IT | ||||||
| Metan (Archive-Best) | 0.851 ± 0.014 | 0.733 ± 0.015 | 0.815 ± 0.013 | 0.869 ± 0.045 | ×15.10 ± 2.4 | n/r |
| OpenEvolve | 0.814 ± 0.022 | 0.718 ± 0.022 | 0.745 ± 0.034 | 0.802 ± 0.052 | ×10.45 ± 1.8 | n/r |
| Gödel Agent | 0.451 ± 0.023 | 0.710 ± 0.034 | 0.775 ± 0.023 | 0.581 ± 0.061 | ×13.22 ± 2.7 | n/r |
| GPT-5.2 Backbone | ||||||
| Metan (Archive-Best) | 0.870 ± 0.011 | 0.725 ± 0.014 | n/r | 0.917 ± 0.016 | n/r | 0.331 ± 0.010 |
| OpenEvolve | 0.702 ± 0.025 | 0.721 ± 0.007 | n/r | 0.726 ± 0.046 | n/r | 0.003 ± 0.001 |
| Gödel Agent | 0.527 ± 0.033 | 0.708 ± 0.037 | n/r | 0.674 ± 0.068 | n/r | 0.054 ± 0.006 |
- ARC-AGI-2 上的质变:ARC-AGI-2 旨在考察抽象泛化而非已知技能微调。基线系统得分几乎全部归零,而 Metan 凭借跨任务提炼变换原语并递归组合,取得了 0.331 的高分。
- 计算对齐(Compute Parity)下的鲁棒性:在严格限制 Token 预算与 OpenEvolve 一致( tokens)的条件下,Metan 依然保持领先,且采样效率高出约 13 倍(CO-Bench 评估 29 次 vs 378 次)。
4.2 深度角色的自发涌现 (Emergent Roles)
通过独立双 LLM 评估器对 596 个 输出代码进行标注,发现随着深度递增,系统自发演化出清晰的认知分工:
- Depth 2(战术原语):生成通用的底层代码库(如
local_search,simulated_annealing),22/36 的最终获胜求解器均调用了此类基础函数。 - Depth 3(专有路由):激进化地引入任务分支路由(
if/elif)和专用子库,但伴随着层间干扰(Interference)。 - Depth 4~6(回滚与精细化修正):回滚(Rollback)操作在 Depth 2 为 0%,在 Depth 3 升至 55%,在深层维持在 50% 左右。深层专注于纠正浅层的过度约束,形成罕见复杂任务的“专家链”。
4.3 消融实验:收益源自何处?
| 实验条件 (Gemma, CO-Bench) | 移除模块 | 验证集得分 | 变化 |
|---|---|---|---|
| Metan (Full Stack) | 完整体系 | 0.845 | — |
| - Code Library | 移除 代码注入 | 0.825 | -0.020 (贡献 ~15%) |
| - Outer-context | 移除层间上下文传递 | 0.751 | -0.094 (贡献 ~72%) |
| - Recursion (Depth-1) | 彻底移除递归元层 | 0.714 | -0.131 (递归总收益) |
消融结果揭示了一个深刻现象:层间传递的策略字符串(Conditioning Context)贡献了递归收益的 70% 以上。高层策略对低层行为的动态重塑,是元深度带来性能飞跃的最主要驱动力。
5. 深度洞察与总结 (Critical Analysis & Conclusion)
核心贡献 (Takeaways)
Metan 提出了一种**“外挂式、输入递归”**的自进化架构,成功解耦了“提升算子自身的稳定性”与“提升对象的高阶复杂性”。它用严谨的数学形式和实验数据证明:大语言模型不需要修改自身的解释器或代码逻辑,仅凭自指输入的高阶累积,即可自发涌现出从“编写工具”到“制定策略”再到“反思回滚”的深层智能阶跃。
局限性 (Limitations)
- 同质模型设定:当前实验中 Base Solver 与每一层 使用完全相同的 LLM,虽严谨控制了变量,但未探索“强模型充当 、弱模型充当 Base”的异构经济部署方案。
- 上下文膨胀与停止条件:尽管系统在 3~6 层自发收敛,但随着深度增加,累积代码栈的上下文占用增大,长程跨层依赖的表征形式仍有结构化空间(目前为纯文本/代码字符串)。
未来展望 (Future Work)
- 类型化与结构化策略传递:将层间的自由文本 Context 升级为强类型的 DSL 或图结构,进一步压榨 72% 上下文增益的潜力。
- 多智能体与跨模态自进化:将固定元操作拓展至具身智能动作空间探索与多模态科学假设自动生成,开启真正自主的持续学习循环。