
MindLLM:跨受试者大脑解码器,让 AI 读懂脑电波中的“奇思妙想”
Mindllm: A subject-agnostic and versatile model for fmri-to-text decoding
本文提出了 MindLLM,一种专门用于将 fMRI(功能性磁共振成像)信号解码为文本的通用型、跨受试者(Subject-agnostic)模型。该模型结合了神经科学启发的注意力机制 fMRI 编码器与现成的 LLM(Large Language Model),通过新创的“大脑指令微调”(BIT)技术,在多种解码任务和新受试者泛化上实现了 SOTA 性能。
TL;DR
研究人员开发了 MindLLM,这是首个能够直接在未见过的人类受试者身上运行、且能处理多种复杂文本任务的大脑 fMRI 解码模型。它不只是能把“看到的场景”复述出来,还能通过 Brain Instruction Tuning (BIT) 提取记忆和进行逻辑推理。实验显示其在新受试者泛化表现上提升了 24.5%,打破了脑机接口(BCI)必须“一人一训练”的魔咒。
背景定位:从“读图”到“读心”
传统的 fMRI 解码研究大多像是一个封闭的实验:你给受试者看一张飞机的图,模型预测出“飞机”这个词。但这种方法有两个致命缺陷:
- 个体差异大:每个人的大脑形状、活跃体素数量都不一样,导致 A 的模型在 B 身上完全失效。
- 任务死板:模型只会做“看图说话”,一旦问它“这张图勾起了你什么回忆?”,它就查无此信息。
MindLLM 的出现,旨在构建一个通用的脑语翻译器。
痛点深挖:为什么跨个体解码这么难?
大脑体素不仅是数据点,它们带有极强的解剖意义。比如,处理视觉和处理语言的区域在空间上是固定的。现有方法要么通过简单的 MLP(要求固定维度),要么通过 Pooling 压缩,这就像是粗暴地把一幅精密地图揉成纸团,丢失了最关键的空间相关性(Spatial Information)。
核心方法:神经科学启发的注意力机制
MindLLM 最精妙的设计在于其 fMRI Encoder。作者并没有像传统 Transformer 那样直接把体素值输入注意力层,而是做了一个“解耦”:
- Value:原始的 fMRI 信号强度(代表活跃度)。
- Key:位置编码 (Pos Enc) + 解剖分区编码 (Reg Enc)。
这种设计确保了模型学习的是“哪个脑区在干什么”,而不是死记硬背某个人特定的体素索引。
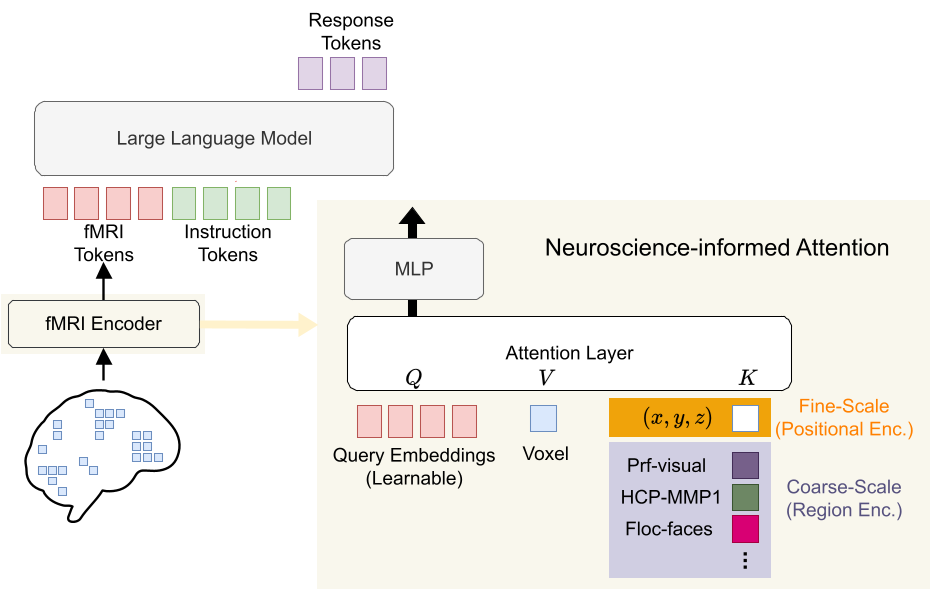 图 1:MindLLM 架构。左侧为受试者未知的编码器,右下角展示了位置与分区信息的融合机制。
大脑指令微调 (BIT)
为了让 LLM 听得懂大脑信号,作者构建了约 98 万条指令对话。利用图像作为中间媒介,将 fMRI 信号与诸如“描述一下刚才感知到的场景”、“根据图中内容进行推理”等自然语言指令挂钩。这让模型具备了:
- 视觉感知:理解当前所见。
- 记忆检索:描述之前看过的图像。
- 符号处理:进行数字运算和文字识别。
实验与结果:全方位碾压
MindLLM 在多项指标上大幅领先。在最考验泛化能力的 Unseen Subject 测试中,它的表现比之前的最优方法提升了 24.5%。
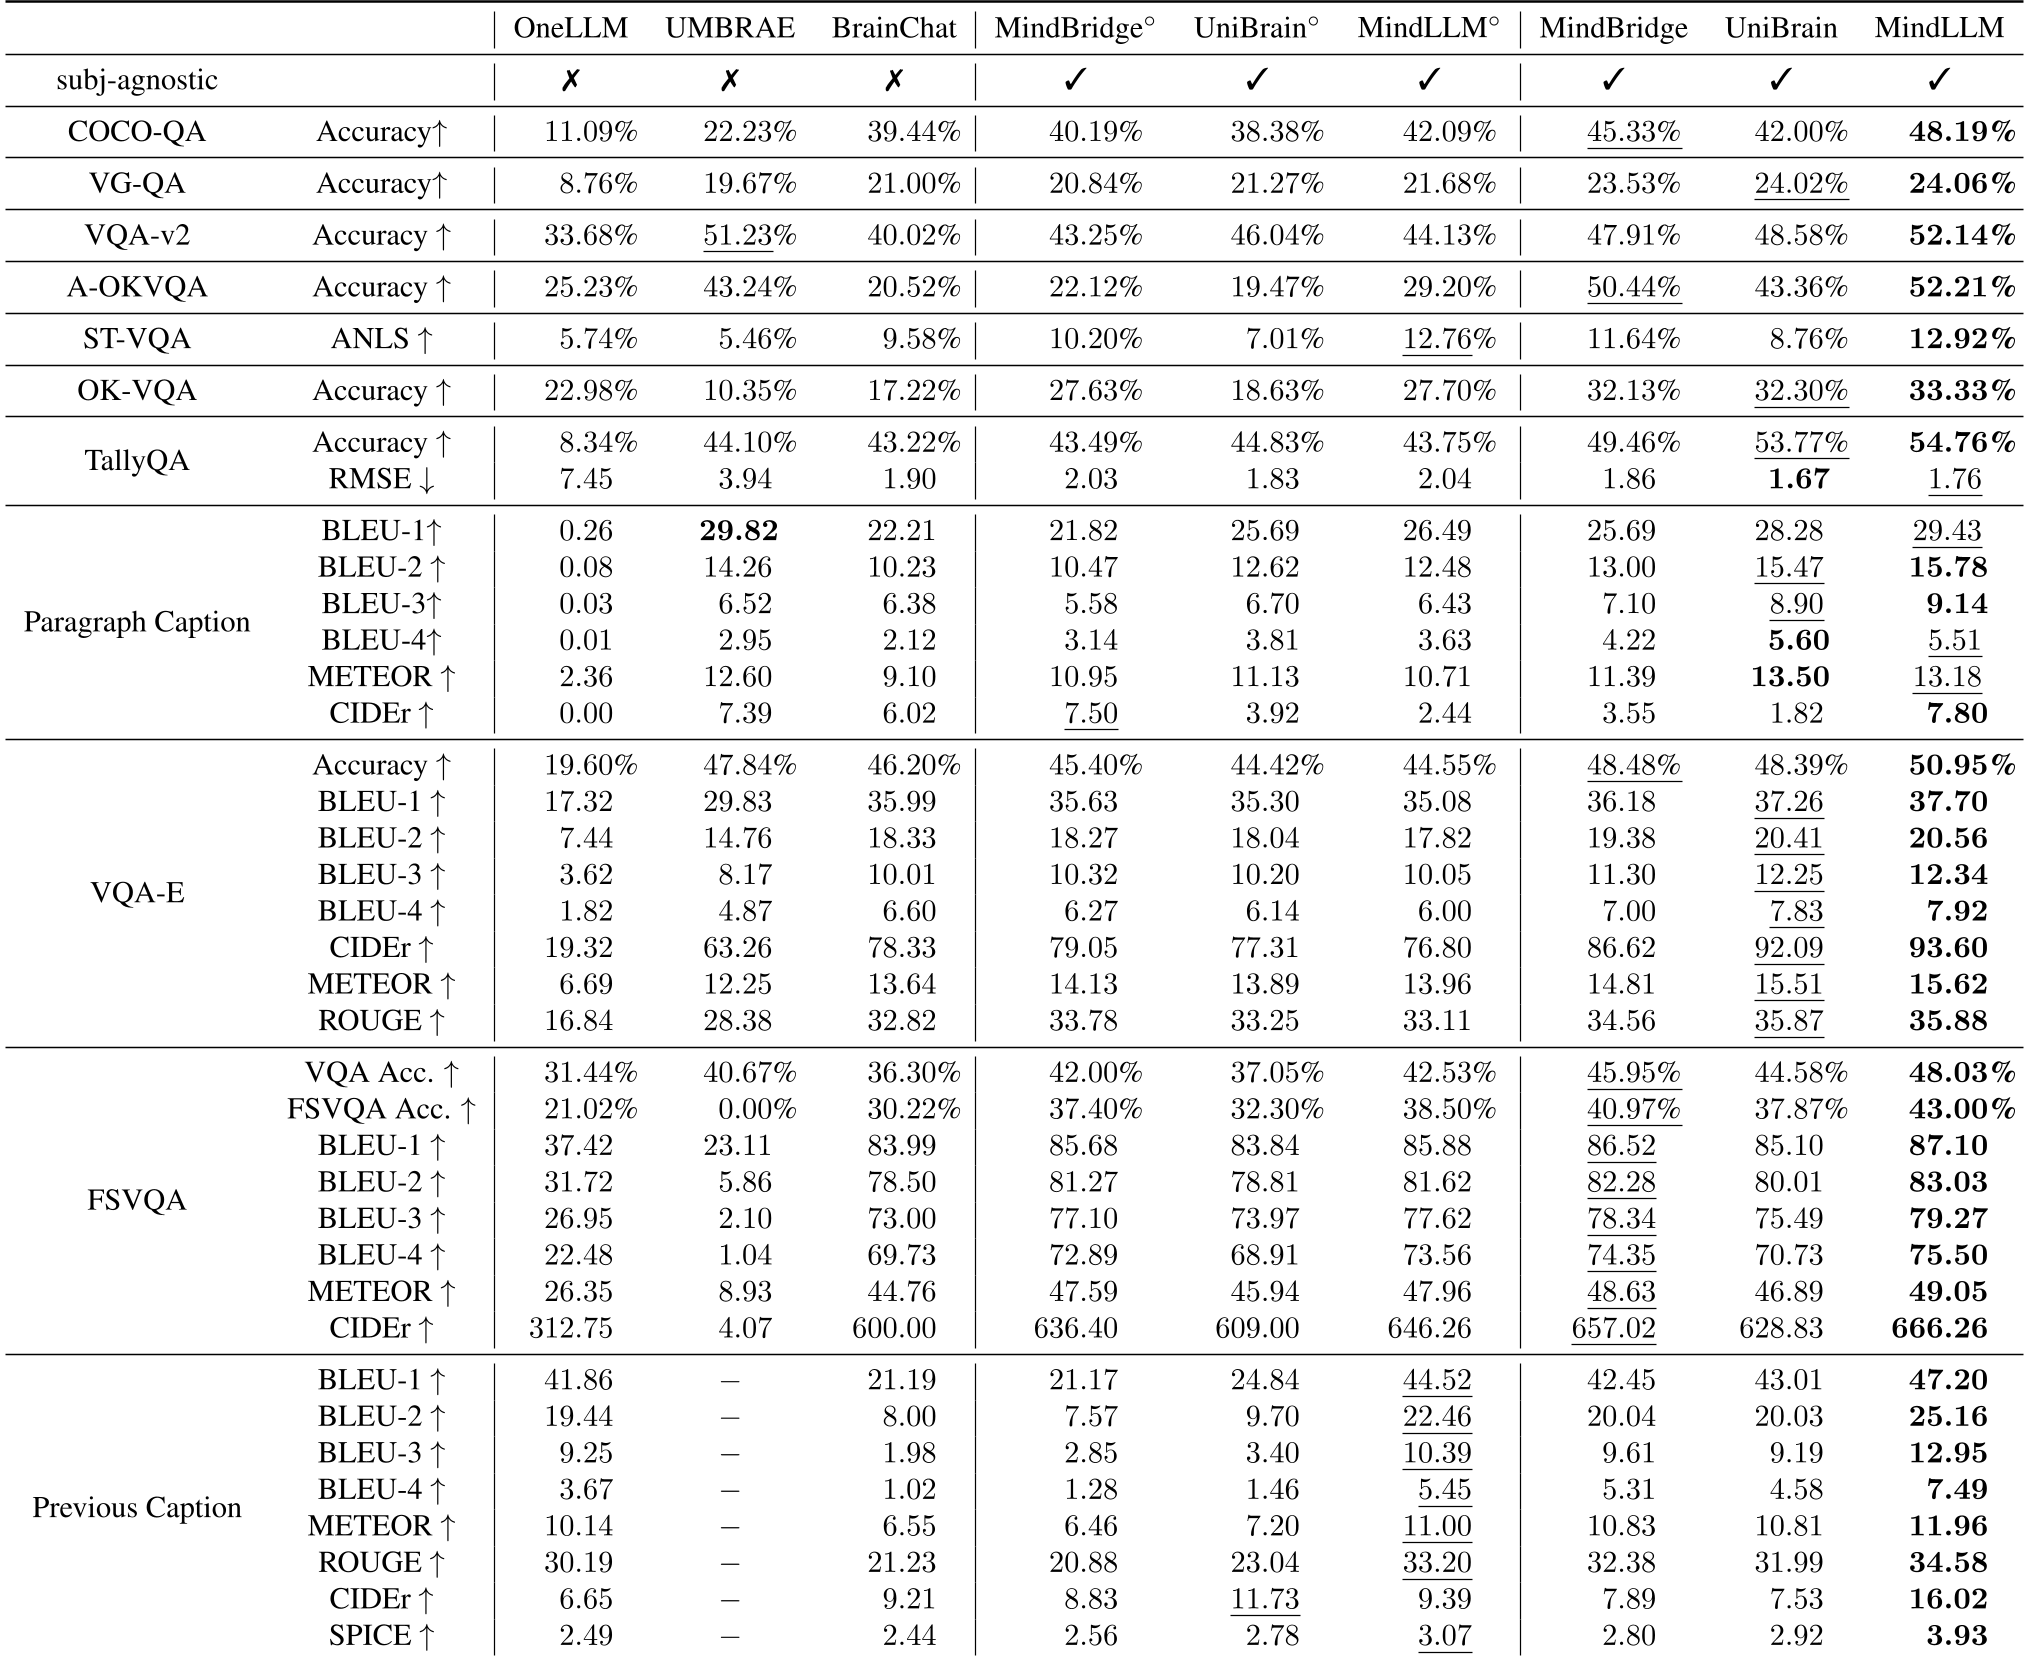 图 2:MindLLM 在各种下游对话与问答任务中的表现,显著优于 UMBRAE 和 UniBrain 等模型。
可解释性验证
最具说服力的是模型的可解释性图谱。通过可视化 Attention Weights,研究者发现某些 Query 专门盯着大脑的 PPA(环境记忆区)和 FFA(面部识别区)。这说明模型不是在乱猜,而是真实地捕捉到了神经科学公认的功能信号。
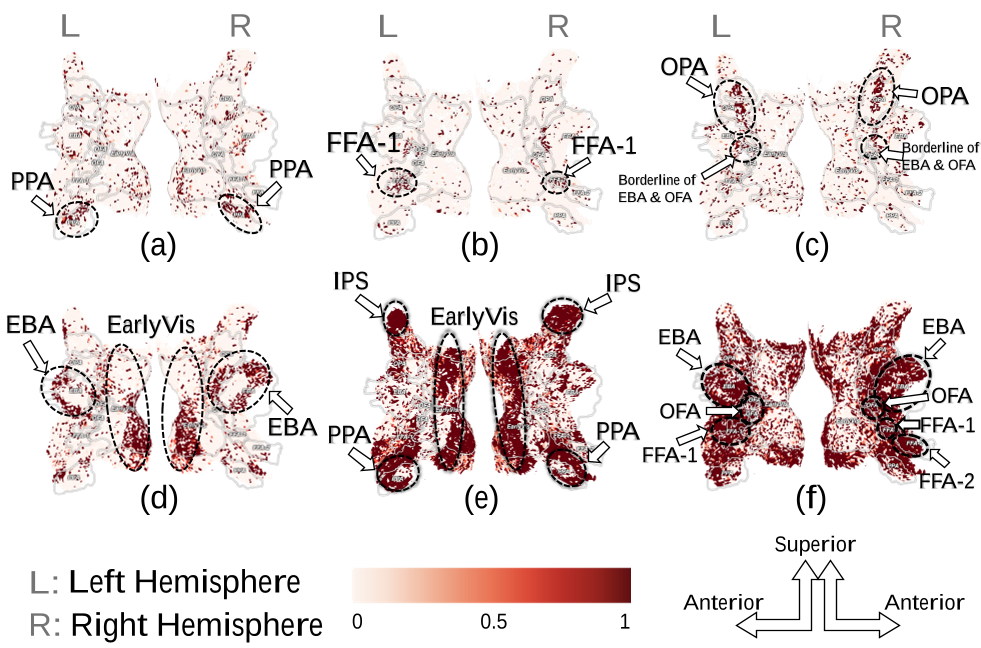 图 3:注意力模式可视化,显示了模型对特定功能区间(如 PPA、FFA)的精准聚焦。
深度洞察与总结
Takeaway:MindLLM 的成功在于它尊重了“大脑的物理结构”。通过引入解剖学先验,它跨越了生物个体差异的鸿沟。
局限性:目前的模型处理的是静态 fMRI 情况,忽略了大脑活动的动态时间维度。此外,现在的指令微调高度依赖于视觉刺激作为桥梁,未来如何解码纯粹的自发性思维(无视觉输入)仍是极具挑战的“圣杯”。
未来展望:这项技术不仅能帮助语言障碍者重新“发声”,更能让 AI 真正成为人类大脑的延伸——通过神经直接控制外部设备。