
MiniCPM-o 4.5:打破“回合制”瓶颈,端侧 9B 参数如何实现人类级实时全双工多模态交互?
Minicpm-o 4.5: Towards real-time full-duplex omni-modal interaction
本文推出了 MiniCPM-o 4.5,这是一个拥有 9B 参数、支持实时全双工(Full-duplex)多模态交互的开源大模型。它基于创新的 Omni-Flow 流式统一框架,实现了看、听、说同步进行,并能在端侧(<12GB RAM)高效运行,在多模态理解和语音生成质量上超越了更大规模的 Qwen3-Omni-30B-A3B。
TL;DR
多模态大语言模型(MLLMs)在图像、视频和语音理解上已经取得了长足进步,但它们与人类之间自然、无缝的交互依然存在一条鸿沟。这条鸿沟的本质不在于模态覆盖度(Modality Coverage),也不在于单次推理延迟(Latency),而在于交互范式(Interaction Paradigm)本身。
由清华大学自然语言处理实验室(THUNLP)与面壁智能等机构组成的 MiniCPM-o 团队,推出了最新力作 MiniCPM-o 4.5。
- 核心突破:9B 参数量,首个实现实时全双工(Full-duplex)全模态流式交互的开源模型。它能够像人一样,在说话的同时进行视觉和听觉感知,并能基于环境演进主动发起交互。
- 学术地位:在视觉-语言(VL)性能上逼近 Gemini 2.5 Flash 和 GPT-5,在全模态理解和语音生成质量上击败了参数量大其三倍的 Qwen3-Omni-30B-A3B。
- 端侧友好:得益于端到端 Token 级连续表征与
llama.cpp-omni的深度推理优化,模型在 INT4 量化下仅需 11GB 显存即可在端侧设备(如 MacBook, RTX 4090)上流畅运行,实时率(RTF)低至 0.20。
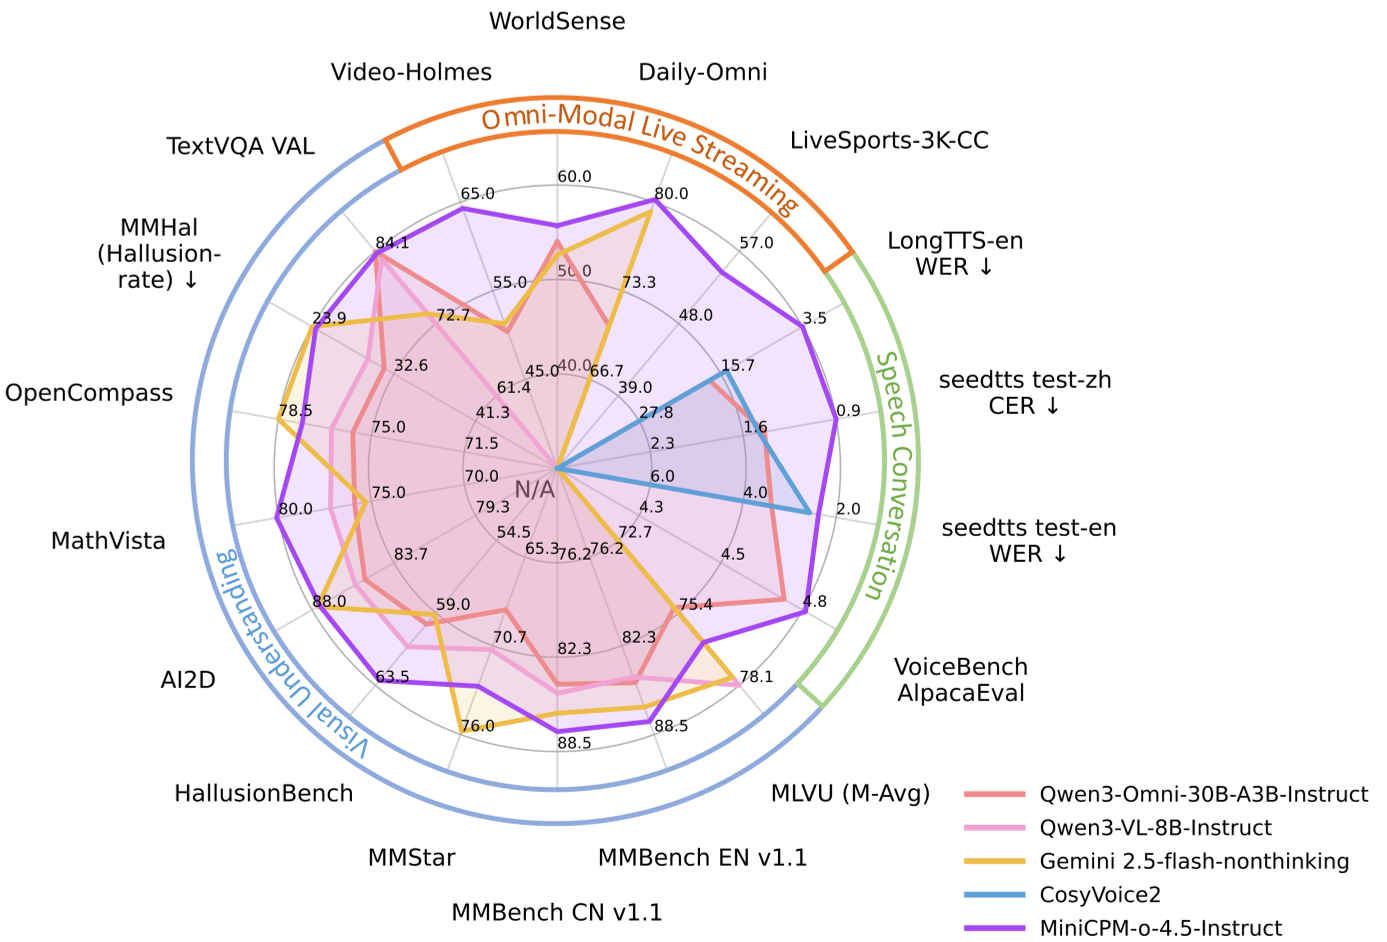 图 1:MiniCPM-o 4.5 展现了极其优秀的多模态通用能力,不仅在视觉-语言任务上逼近 Gemini 2.5 Flash,在语音理解与生成、流式交互综合维度更是超越了 Qwen3-Omni-30B-A3B。
1. 痛点深挖:“回合制”AI 错在哪里?
在审视目前市面上的主流多模态实时交互(如早期版本的 GPT-4o 级交互或各类 Voice Agent)时,我们不难发现其底层均采用**“回合制”被动响应范式(Turn-based Passive Response)**:
- 输入与输出在时间轴上串行(Blocked I/O):用户必须先说完,系统通过端点检测(VAD)截断音频,然后将音频送入 ASR(语音识别)和 LLM,最后通过 TTS(语音合成)播放。在模型生成回复的过程中,它的感知通道是被关闭的。如果用户在中途打断或环境发生了戏剧性变化,模型完全无法感知。
- 缺乏主动性(Reactive, Not Proactive):传统的 MLLMs 是“请求驱动型”的。只有当用户发出显式指令,模型才会开始干活。然而,在真实的动态环境协作(如智能驾驶助手、AR 眼镜导览、具身智能)中,AI 应该具备协同感知能力,根据外界流式输入(如看到用户要摔倒、听到警报声)主动提供提示和评论。
要打破这一瓶颈,就必须重构多模态底座的交互范式,让感知与生成在Token 级别、在统一的时间轴上并行。
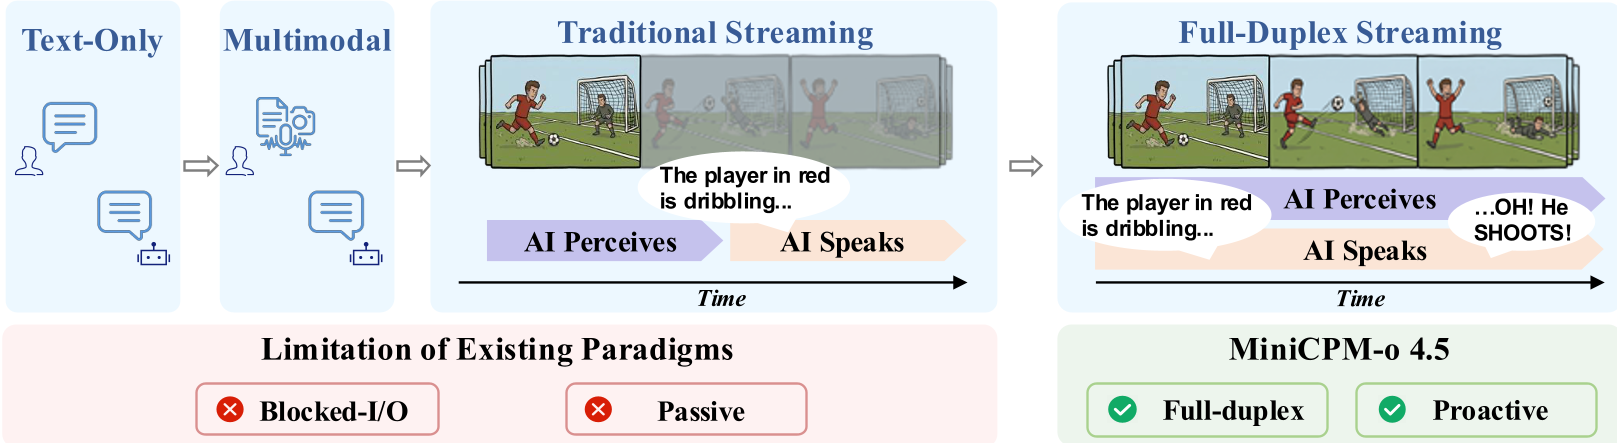 图 2:回合制交互(上)感知与响应串行。MiniCPM-o 4.5 的全双工流式交互(下)让模型在说话时持续保持视觉/听觉感知,可随时根据环境新输入调整生成内容。
2. 核心武器一:Omni-Flow 统一流式框架
如何让标准的因果语言模型(Causal LM)在“说话的同时保持倾听和观看”?MiniCPM-o 4.5 给出的答案是 Omni-Flow 框架。
该框架从通信领域的**时分复用(Time-division Multiplexing)**技术中汲取物理直觉。它将持续的交互过程切分为极其微小的、时长为 的时间窗口(Time Chunk),在每个窗口内,将环境输入与模型输出交织对齐在同一条时间轴上。
2.1 三大时间对齐流
在 Omni-Flow 视角下,多模态交互被形式化为三种并行的流(Streams):
env-visual:流式环境视觉观测。env-audio:流式声学环境(包含用户的语音输入与背景音)。out-stream:模型输出的文本与语音流。
在这种建模下,用户的“提问”不再是打断对话的特权信号,而只是环境音频流中的一部分。模型不需要依赖外部 VAD 模块来切分回合,而是每时每刻都在基于当下的环境感知,自己决定“是要继续聆听 [listen]”,还是“开始主动输出 [speak]”。
2.2 统一序列化(Unified Serialization)
对于第 个时间窗口(Chunk),其输入的视觉 Token 序列为 ,音频 Token 序列为 ,模型的输出 Token 序列为 。这三者被组合成一个组(Group):
模型通过拼接这些组来序列化整场对话历史:。在每个 Chunk 的内部,模型必须先处理新到达的感知 Token(),随后自回归地产生输出 Token 。当 足够小时,这种局部的更新就无限逼近于完全并行的全双工行为。
经过消融实验(见下表 1),研究团队发现:
- 时间粒度 最为稳健:过短的窗口(如 0.1s 或 0.2s)会导致模型在单个窗口内没有足够的上下文做出稳定的控制决策,带来性能剧烈退化。
- 显式边界(Explicit Boundary)至关重要:在各组之间插入显式的特殊分隔符(Special Tokens)能大幅降低模型区分“新观测”与“自己历史输出”的认知负担。
- 控制与内容解耦(Listen-Speak Formulation):在预测内容前先输出一个二分类的控制 Token(是否要说话),相比直接在统一空间里预测内容,其生成更稳定。
3. 核心武器二:端到端全模态架构与 TAIL 语音生成策略
在硬件和算法架构层面,MiniCPM-o 4.5 采用了全参数可微(Differentiably Connected)的端到端表征连接,总参数量约 9B。
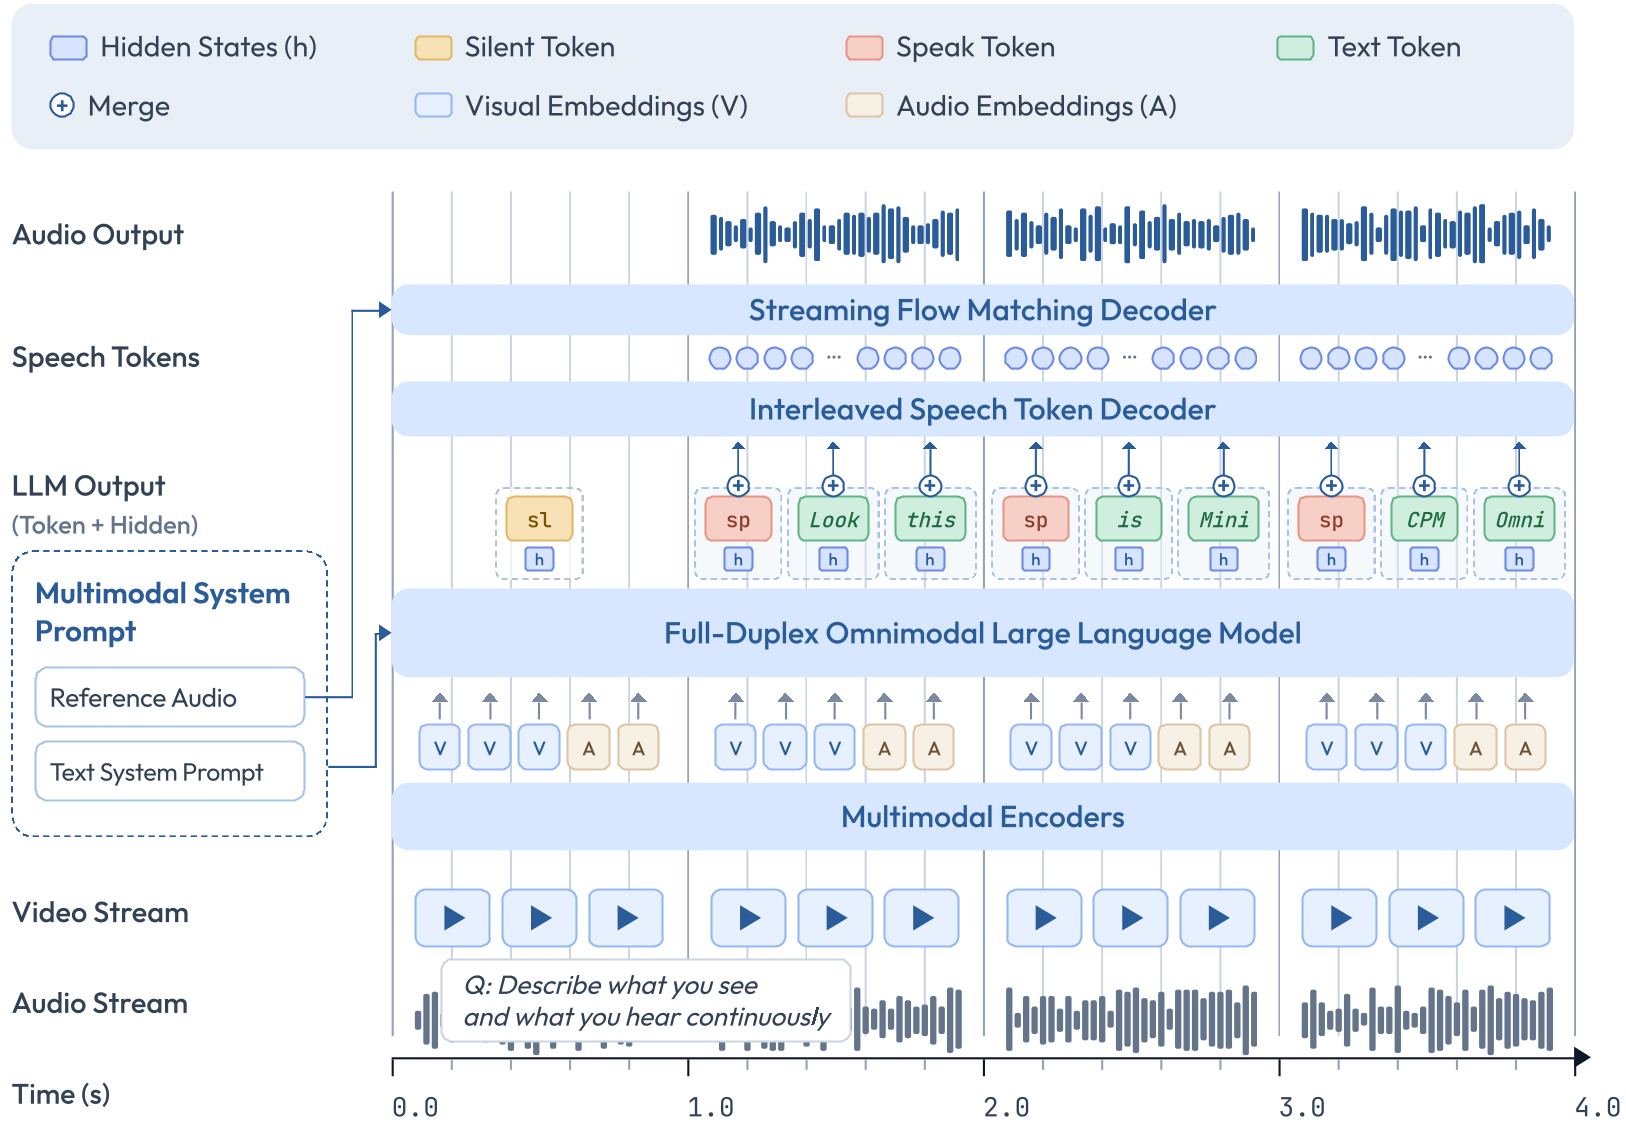 图 3:模型架构图。输入端采用 SigLIP(视觉)与 Whisper Medium(语音)进行高比例特征压缩;LLM 主干(Qwen3-8B)负责高层语义决策;输出端交由轻量化 Llama 语音 Token 解码器与 Flow-matching 波形合成器生成音频。
3.1 极简而优雅的“语义-声学”解耦设计
许多最新的全双工模型(如部分 Omni 架构)尝试让大模型直接自回归地产生高帧率的语音离散 Token(通常每秒需要生成 25 个以上的 Token)。但这会带来两个致命缺陷:一是大模型的上下文窗口被海量声学 Token 迅速塞满,二是严重损害了 LLM 原本强大的通用语言与推理能力。
MiniCPM-o 4.5 采用了极其聪明的解耦架构:
- LLM Backbone(Qwen3-8B) 只负责产生高阶的文本 Token,其生成速率极慢(每秒仅需 3-4 个,与人正常说话速度一致),这完美保留了其核心的认知和逻辑推理能力。
- Llama Speech Token Decoder(~0.3B):这是一个轻量级的语音解码器。它将 LLM 的隐状态(Hidden States,已融入了丰富的上下文、语气、指令意图信息)与文本 Token 的表征相融合,再进行高频的 S3 语音 Token(25 tokens/s)自回归生成。
- Streaming Flow-matching Decoder:最终将语音 Token 转化为连续波形。
3.2 Time-Aligned Interleaving (TAIL):解决“语速不匹配”的滞后难题
在流式全双工交互中,经常遇到一个棘手问题:文本生成速度与语音播放时间不匹配。 如果模型每秒产生的文本对应的语音朗读时间需要 1.5 秒,那么随着时间推移,播放出来的音频就会落后于当前的真实时间轴(即 Speech Lag)。用户听到的信息将是“过时的历史上下文”。
为了解决这一问题,团队提出了 Time-Aligned Interleaving (TAIL) 策略:
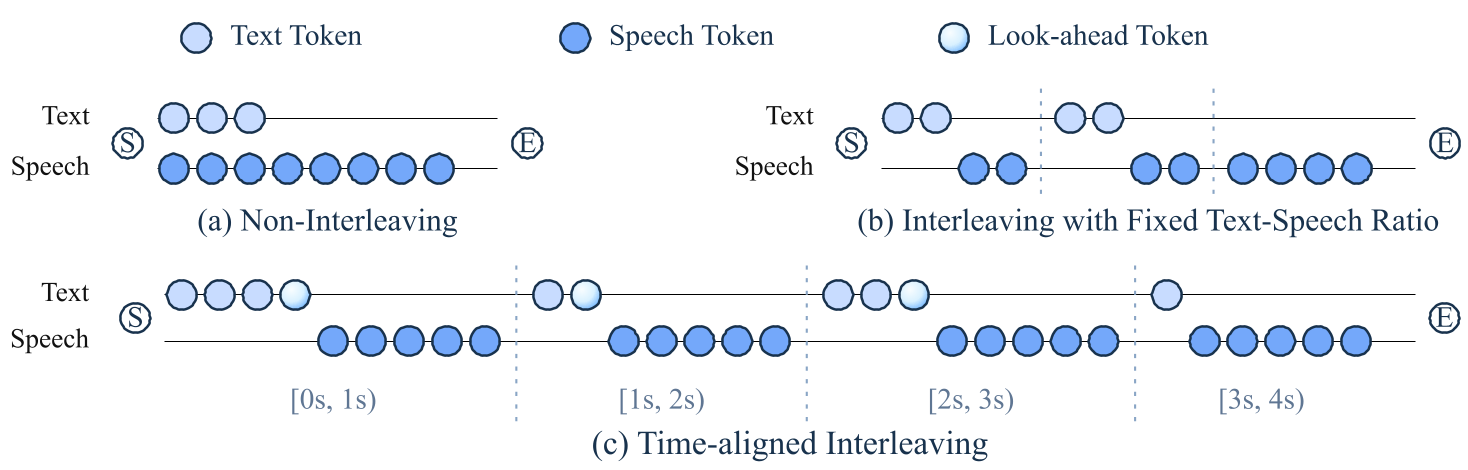 图 4:传统的 Lead-text 策略(a)与固定比例交织(b)都无法应对变长发音带来的时间偏移,导致语音严重落后于环境上下文。TAIL(c)通过监控累积的播放进度,自适应调节每个 Chunk 内生成的文本量,保持播放与时间轴严格对齐。
TAIL 的核心思想是基于全局历史累积播放进度的动态微调。 在第 个 Chunk 中,模型会估算当前已经积累的播放延迟。如果之前说得太慢,模型会在当前的 Chunk 中主动减少文本的生成量,从而“让语音播放追赶上当前的时间轴进度 ”。 此外,为了保证连贯的语音发音(例如,“the” 的发音取决于后面紧跟的单词是辅音还是元音开头),TAIL 引入了受限的前瞻机制(Look Ahead Speech Generation):允许最末尾的几个文本 Token 暂时不进行语音合成,留到下一个 Chunk 作为局部上下文,确保了发音和抑扬顿挫的连贯。
4. 训练与对齐中的黑科技:平滑长度奖励(Smooth Length Reward)
在后训练(Post-training)阶段,团队利用 RL(强化学习)来提升模型的推理和对齐能力。他们引入了 GRPO 算法,并在此基础上面临了一个经典难题:如何防止模型为了刷正确率而故意生成极其冗长的 CoT(思维链)解答,造成极高的时延和算力浪费?
如果采用类似 Kimi K1.5 的硬长度惩罚,在思考模式下很容易因为惩罚过重导致模型推理准确率下降(因为有用的中间推理步骤被粗暴抹杀了)。MiniCPM-o 4.5 提出了一种全新的**平滑长度奖励(Smooth Length Reward)**公式:
其中,缩放系数 的计算方式为:
- 为正确性指示器(Correctness Indicator)。
- 、、 是一组 Prompt 下所有采样的长度及其边界值。
- 机制巧妙地避免了去奖励那些“虽然很短但回答错误”的样本。
- 是超参数,用以在长度差距很小时降低奖励敏感度。
实验结果表明,该设计实现了极佳的“效率-性能”帕累托最优:
| 长度奖励方案 | Thinking 模式均分 | Instruct 模式均分 | Thinking 长度减少率 | Instruct 长度减少率 |
|---|---|---|---|---|
| 无长度奖励 (Baseline) | 73.5 | 70.9 | - | - |
| Kimi K1.5 风格奖励 | 73.0 | 70.1 | -50.7% | -20.2% |
| MiniCPM-o 4.5 平滑奖励 | 74.3 | 70.9 | -35.3% | -20.5% |
通过平滑的奖励曲线,模型在大幅剪枝冗余推理步骤(Thinking 模式长度缩减 35.3%)的同时,性能不仅没有下跌,反而相比 Baseline 进一步提升到了 74.3 分,避免了硬罚分带来的优化不稳定。
5. 实验战绩与推理效率评测
5.1 视觉-语言通用能力
在静态和传统的 Instruct 评测中,MiniCPM-o 4.5 充分继承了 MiniCPM-V 家族优秀的视觉底子(高分辨率 LLaVA-UHD 支持与鲁棒的 OCR 解析能力):
- OpenCompass 综合榜单:Instruct 模式下获得 77.6 分,在同等参数量级别(如 InternVL3.5-8B、Qwen3-VL-8B)中傲视群雄,甚至在 OCR 解析等多项指标上优于 Qwen3-Omni-30B-A3B,非常逼近 Gemini 2.5 Flash 的水平。
- 文档与 OCR(OmniDocBench):在英文和中文评测中分别取得 0.109 和 0.162 的低错误率,显著领先于竞品。
5.2 实时流式与全双工性能
在无文本捷径的音视频对齐评测 AVUT-Human 以及流式视觉评测 LiveSports-3K-CC(体育实时解说)上,MiniCPM-o 4.5 分别斩获 78.6 和 54.4 的极高分数。
在 LiveSports 体育流式解说中,其表现高出最强流式大模型基线 StreamingVLM(8B)多达 8.8 个百分点,这有力地验证了 Omni-Flow 框架在对齐动态时间轴、降低感知延迟方面的显著成效。
5.3 硬件部署与推理效率
为了将这个拥有 9B 参数的全双工模型塞入用户的移动端或边缘计算设备中,研究团队推出了深度优化的 llama.cpp-omni 推理框架:
| 部署框架 | Dtype | 显存占用 (Memory) | 实时率 (RTF) | 支持平台 |
|---|---|---|---|---|
| PyTorch (Baseline) | BF16 | OOM | - | - |
| PyTorch (Baseline) | INT4 | 14 GB | 1.26 | Linux |
| llama.cpp-omni (Ours) | FP16 | 19 GB | 0.27 | macOS, Win, Linux |
| llama.cpp-omni (Ours) | INT4 | 11 GB | 0.20 | macOS, Win, Linux |
实时率(Real-time Factor, RTF)衡量的是处理 1 秒音频/视频流所需的计算时间。当 RTF 低至 0.20 时,意味着模型只需要 200 毫秒就可以处理并响应 1 秒的多模态流式输入。在端侧(如 RTX 4090)下仅消耗 11GB 显存,这让全民部署实时全双工多模态 Agent 变得触手可及。
6. 局限性与未来展望
尽管 MiniCPM-o 4.5 代表了目前开源社区在全双工多模态领域的最前沿水平,但作为一项早期的流式交互探索,它依然存在一些不容忽视的局限:
- 长时间流式对齐的漂移:在极长时间(如长达数小时)的动态复杂场景交互中,模型维持音画同步、实时把握“听与说”物理边界的鲁棒性仍有待提升。
- 语言混杂与生成抖动:在流式状态下,语音解码器偶尔会出现中英文混杂的语调漂移或局部发音不准的问题。
- 主动规划(Proactive Planning)尚处于初级阶段:目前的主动提示行为依然偏向于简单的环境状态描述(如“注意到你面前有一杯水快倒了”),更深层次的多步长程规划和推理尚待发掘。
正如论文在结语中所指出的:多模态基座模型正在从“回合制文本处理工具”快速演变为“能够像人类一样与物理世界进行全双工、低延迟音视频协同交互的生命体”。 MiniCPM-o 4.5 的开源,无疑为这一前沿演进方向注入了一剂强心针。