
推理的“参数低保”:多少参数才能让 LLM 学会隐式推理?
Finding the Minimal Parameter Budget for Implicit Reasoning: A Data Complexity Driven Scaling Law for Language Models
本文通过受控合成环境研究了语言模型(LM)隐式推理所需的最小参数预算,提出了基于知识图谱搜索熵(Graph Search Entropy)的缩放法则。核心结论是:由数据复杂性决定的“最佳模型大小”是有限且稳定的,每个参数最多支持约 0.008 bits 的推理相关信息。
TL;DR
在 AI 领域,我们习惯了“大力出奇迹”,认为模型越大推理越强。然而,来自 Wang 等人的最新研究给出了一个反直觉的结论:隐式推理(Implicit Reasoning)存在一个“最小充分容量”。一旦超过这个最优规模,更大的模型不仅不会提升最终的推理准确度,反而更容易在长时间训练中过拟合。研究发现,模型参数量与数据背后的**图搜索熵(Graph Search Entropy)**成线性缩放关系,且每个参数能承载的推理信息极低,仅为约 0.008 bits。
背景定位
本文属于对 Scaling Laws 的底层逻辑修补。它不关注模型能做多大,而是探讨模型“最少需要多小”就能解决特定的逻辑链条任务,将推理能力从“玄学涌现”拉回到了“信息容量”的科学坐标系中。
痛点与动机:为什么大未必更好?
传统的 Kaplan 或 Chinchilla 缩放法则通过测试集 Loss 来衡量性能,但在涉及多步逻辑推理的任务(如:A是B的父亲,B是C的父亲 A是C的祖父)中,研究者观察到了奇特的 U 型曲线:
- 小模型:容量不足,根本学不会逻辑规则。
- 最优模型:刚好能拟合规则,推理泛化能力最强。
- 大模型:虽然能更快达到高性能,但在训练后期倾向于“记住”噪声而非逻辑,导致测试 Loss 反弹。
这种现象暗示,推理能力在预训练阶段的习得,本质上是模型在参数空间中对逻辑结构进行的某种“搜索复杂度”匹配。
核心机制:图搜索熵(Graph Search Entropy)
作者认为,知识图谱(KG)的推理复杂度可以用信息论来定义。他们引入了 图搜索熵 。
逻辑直觉
如果你在一个知识图谱上随机游走,每一步面临的选择越多(分支因子大)、逻辑链条越长,对应的熵就越高。
- 实体熵率:衡量节点跳转的不确定性。
- 关系熵率:衡量关系选择的多样性。
架构解析:为什么是 Transformer?
作者证明,单层 Transformer 配合 Key-Value 存储机制,本质上可以实现对这些稀疏逻辑基底的近似。
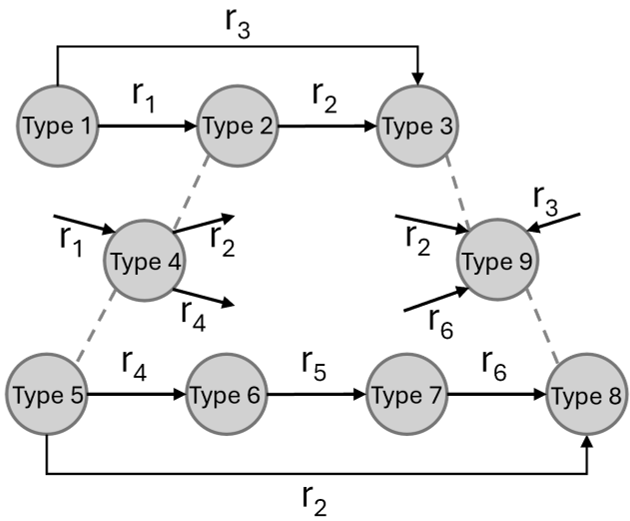 图 1:合成数据的节点类型生成,模拟了逻辑规则在图结构中的体现。
实验与结果:0.008 Bits 的残酷现实
通过对合成图谱进行消融实验(改变实体数 、关系数 、规则数 等),作者验证了最优模型大小 与 的线性关系。
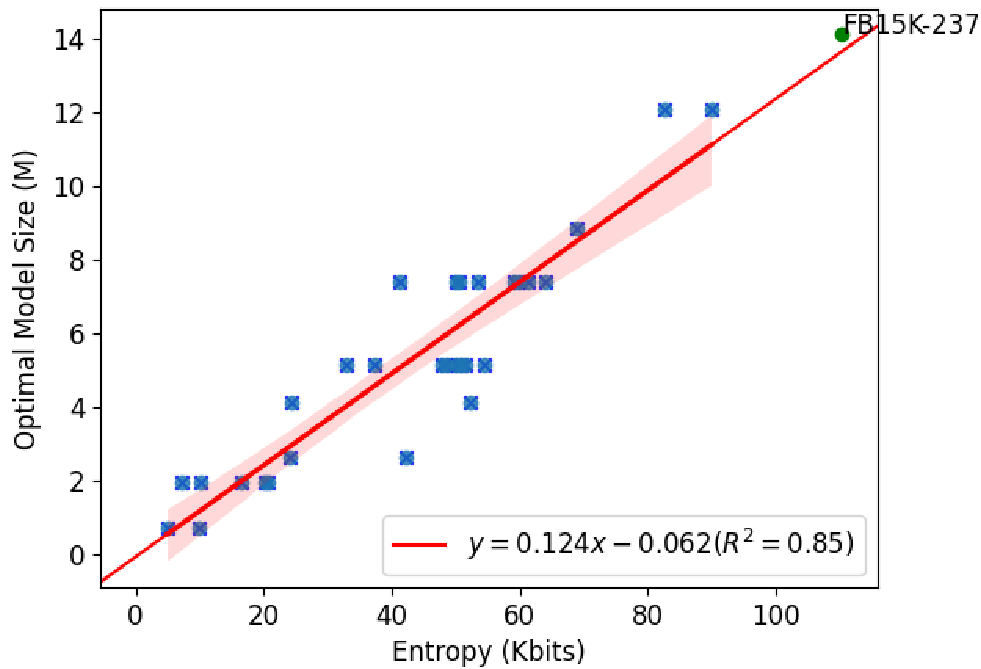 图 2:最优模型大小随图搜索熵高度线性增长。
关键发现:
- 推理比记忆更贵:之前的研究认为 1 个参数能存 2 bits 事实库,但本文发现 1 个参数只能支撑 0.008 bits 的推理。这意味着:推理任务比纯记忆任务对参数的需求高出约 250 倍。
- 真实数据验证:在 FB15K-237 真实图谱上,该缩放法则精准预测了最优模型的大小(图中绿点),证明了从合成环境推导出的理论具有泛化性。
深度洞察:对未来的启示
这项研究重新审视了“推理”的成本。
- 模型设计的平衡:如果你知道任务的知识图谱复杂度,你就可以计算出最省钱的模型规模,而不是盲目烧卡。
- 局限性:目前实验基于随机 ID 编码,剔除了自然语言中的语义语义重叠(Semantic Sharing)。在真实场景中,由于语言有冗余和先验,实际所需参数可能会比 0.008 bits/param 预测的更少。
- 未来展望:这种“基于熵的缩放”是否适用于 SSM(如 Mamba)或其他非 Transformer 架构?这将是下一个技术制高点。
总结
隐式推理不是魔法,而是对数据复杂度的参数化映射。大模型能够推理,或许仅仅是因为它们有足够的“闲置容量”来覆盖那些高熵的逻辑搜索分支。