
MiniMax-MSA:将百万长度上下文推理效率提升 14 倍的秘密
MiniMax Sparse Attention
本文提出了 MiniMax Sparse Attention (MSA),一种基于 GQA (Grouped Query Attention) 的块状稀疏注意力机制。通过轻量级的 Index Branch 实现组级别的 Top-k 块选择,在 1M 上下文下将注意力计算量降低了 28.4 倍,并在 109B 参数模型上达到了与全注意力基线相当的性能。
TL;DR
在 LLM 向 Agentic Workflow 和长文本推理演进的过程中,Softmax 注意力的二次复杂度成为了性能死穴。MiniMax 推出的 Sparse Attention (MSA) 通过一种极简的“索引-执行”双分支架构,在 109B 参数规模上不仅保住了模型精度,更在 1M 长度下实现了 14.2 倍的 Prefill 加速。该方法现已集成于 MiniMax-M3 模型并开源。
背景:为什么要动端到端的“稀疏化”?
目前解决长文本问题的方案主要分为两类:要么用线性注意力(Linear Attention)或 SSM(如 Mamba)替换全注意力,但往往面临精度损失;要么在推理阶段通过 KV Cache 剪枝(如 H2O, SnapKV)进行“打补丁”。
MSA 的核心直觉(Insight)是:动态稀疏性不应仅仅是推理时的技巧,而应在训练阶段就与模型架构深度耦合。
核心架构:Index Branch 与 Main Branch 的协作
MSA 的设计遵循奥卡姆剃刀原则,其流程非常直观:
- Index Branch(索引分支):这是个极其轻量级的模块。它为每个 GQA 组生成一个索引 Head,通过简单的点积打分和块级别的 Max-pooling,从海量的 Key 块中挑出最重要的 Top- 个。
- Main Branch(主分支):标准的 GQA 计算,但只作用于被选中的块。
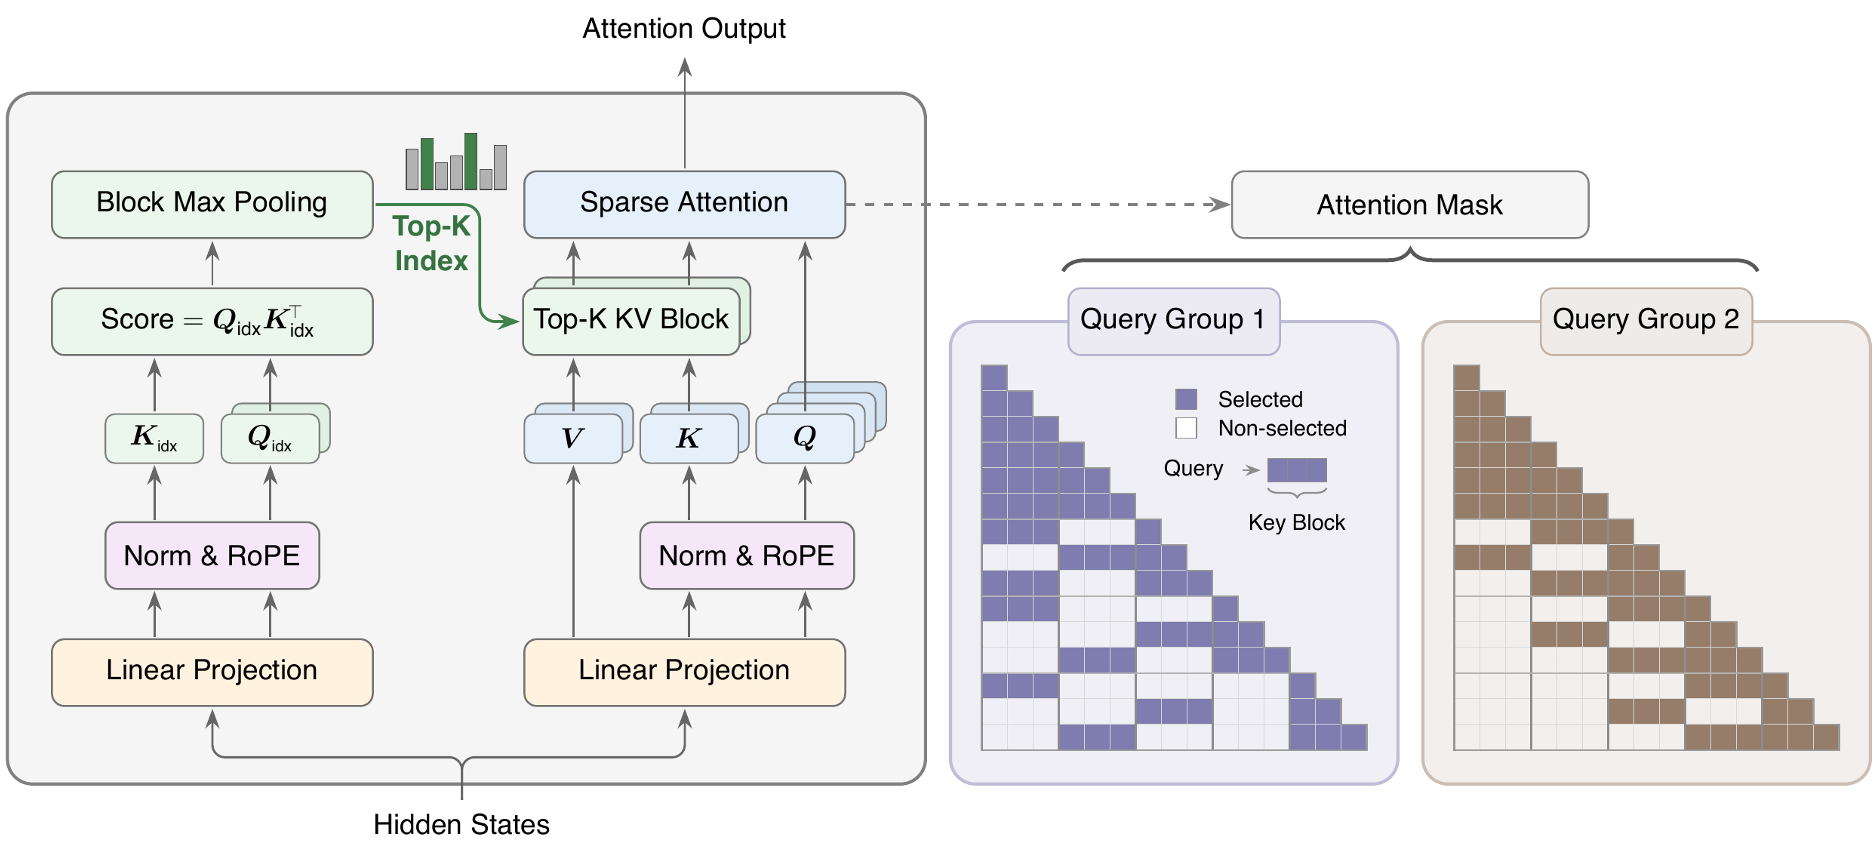 图 1:MSA 的整体架构。左侧为轻量化 Index Branch,右侧为稀疏执行的 Main Branch。
训练的稳定性保障
稀疏选择本身是不可导的。MSA 巧妙地使用了 KL 散度对齐损失(KL Alignment Loss),让 Index Branch 的预测分布去逼近 Main Branch 的实际权重。
- 梯度分离(Gradient Detach):防止 KL 损失干扰 Backbone 的特征表达。
- 强制局部块(Forced Local Block):确保当前块永远被选中,维持训练初期稳定性。
软硬件协同:把稀疏性压榨成真实的“墙上时间”
如果算子写得不好,理论上的稀疏度(FLOPs 减少)往往无法转化为实际的吞吐提升。论文提出了一套针对 GPU 优化的内核设计:
- KV-outer 迭代顺序:不同于传统的 Q-outer(Query 主导),MSA 采用 KV 块作为外层循环,利用共享内存聚合所有选择该 KV 块的 Queries。这极大提高了 Tensor Core 的利用率。
- Exp-free Top-k:在索引阶段直接对原始分数排序,避开了耗时的 Softmax 指数运算。
实验战绩:109B 模型的无损替换
作者在 109B MoE 模型上进行了 3T Tokens 的超大规模实验,对比了全注意力(Full Attention)和 MSA:
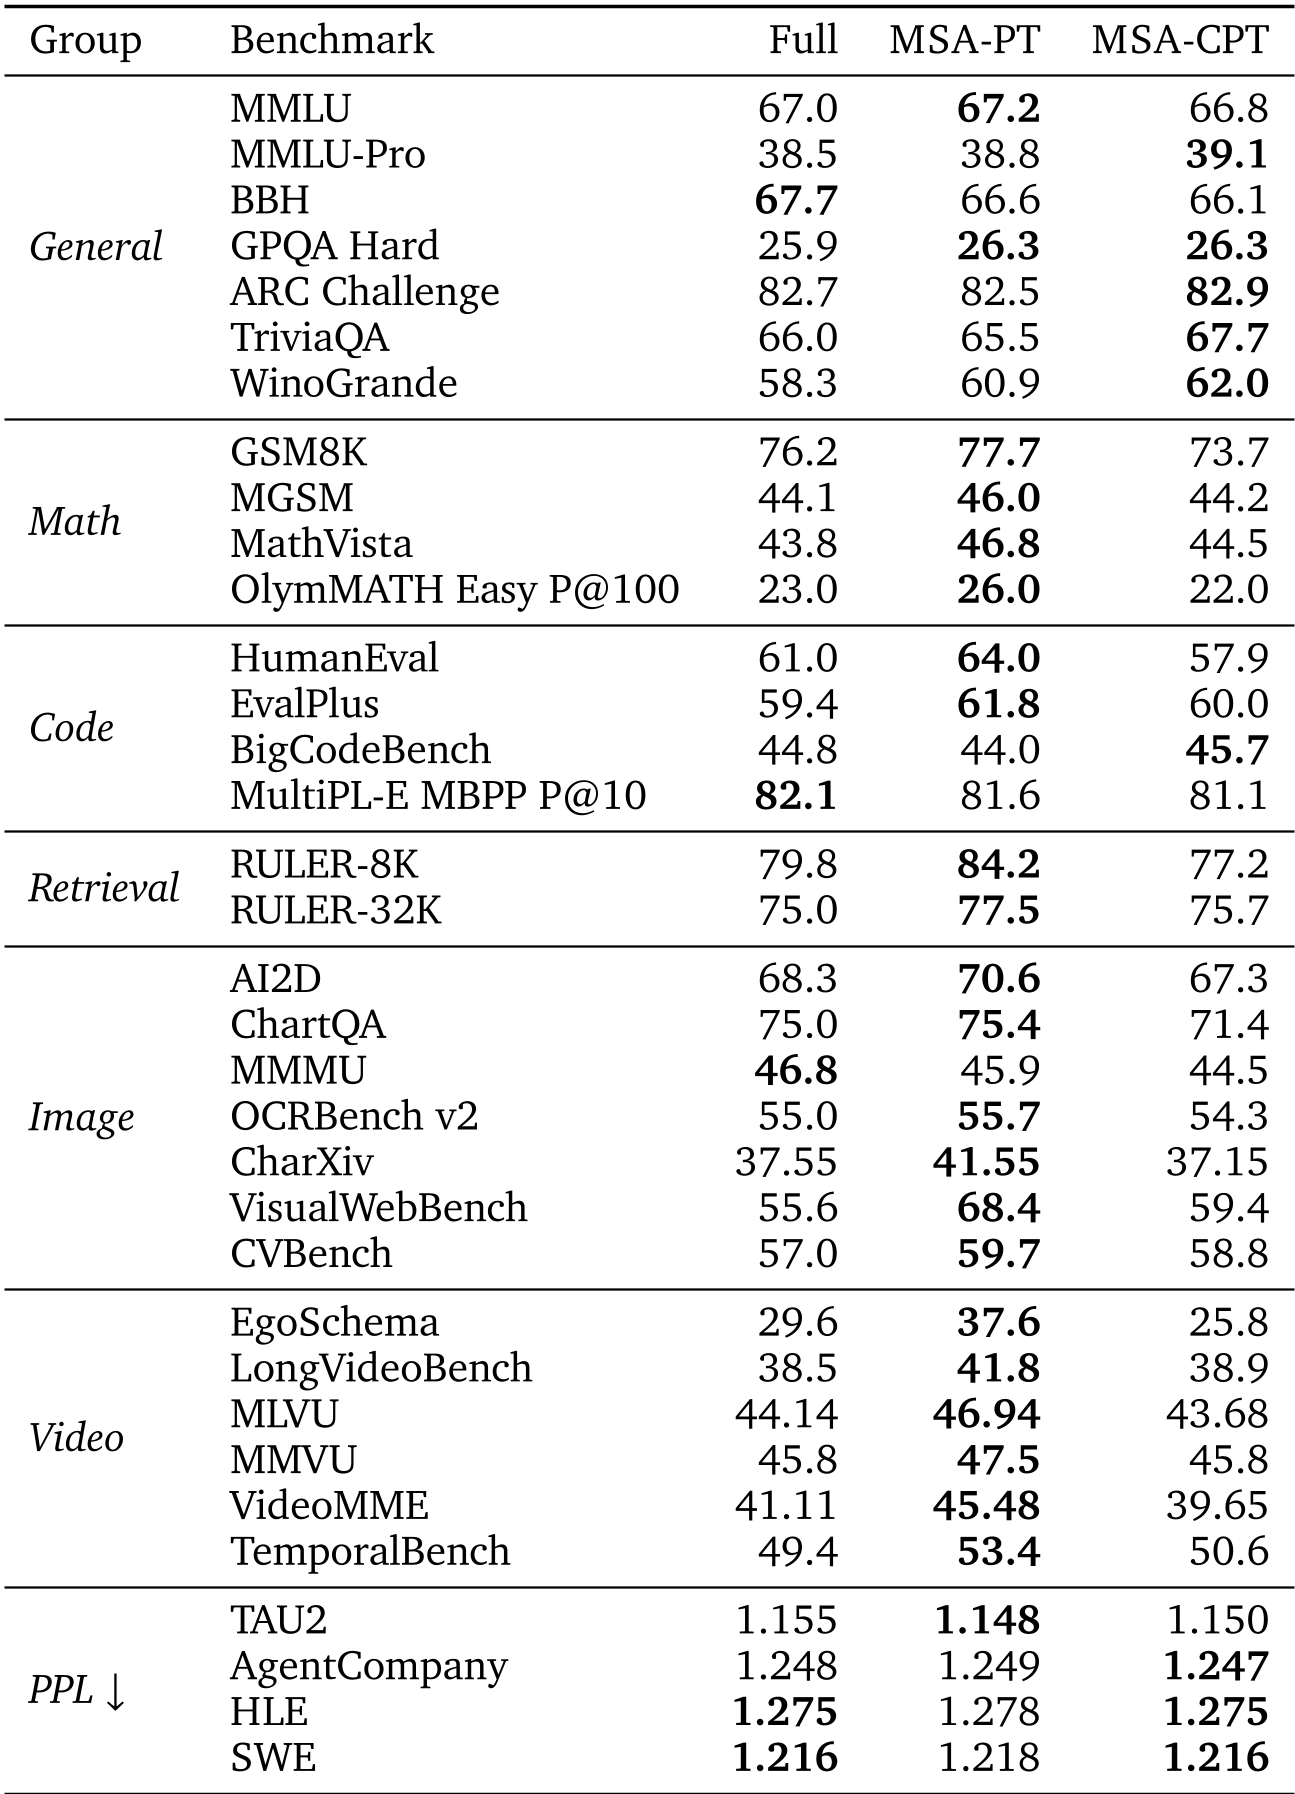 表:在 MMLU、GSM8K 以及视频理解等多项榜单上,MSA-PT(从头训练)表现出了极强的竞争力。
在推理效率方面,随着 context length 增加,MSA 的优势呈线性扩展。在 1M 长度下,相对于 GQA 基线,其计算量降至 1/28,实际测得 Prefill 加速达 14.2x。
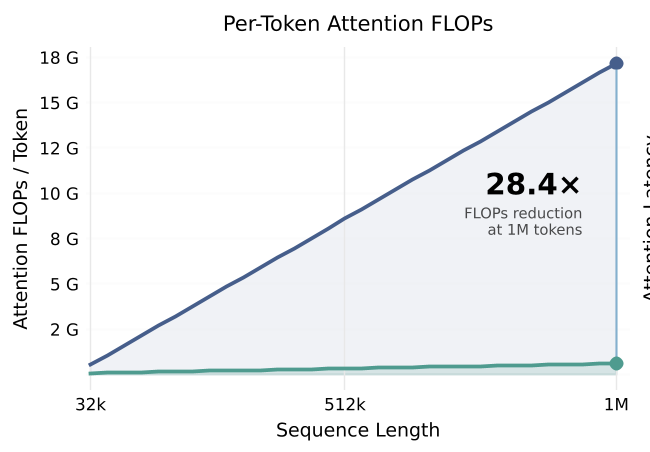 图:理论 FLOPs 降低与实际推理速度提升的对比。
深度洞察
- 注意力汇聚(Attention Sink)的自然回归:可视化显示,即使不强行指定,Index Branch 也会在大规模训练后自动学会锁定第一个 Token(Sink)和局部对角线。
- 组内共享(Group-shared)的平衡点:MSA 在每个 GQA 组内共享索引,而在组间保持独立。这种设计在“硬件友好性”和“注意力多样性”之间找到了极佳的平衡。
总结
MSA 证明了我们不需要抛弃 Softmax,也能搞定百万级上下文。它的成功在于:极其精简的索引设计 + 针对性的 KL 监督 + 软硬协同的 Kernel 实现。对于追求长文本能力的 LLM 厂商而言,这种架构不仅易于部署,且在原生多模态任务中表现稳健。
局限性:虽然 1M 长度下表现优异,但在更极端的语境下(如全量代码库检索),索引器的准确性仍有待进一步通过更复杂的检索函数来验证。