
MOBILEGYM:突破移动智能体训练瓶颈,打造轻量级高并行模拟生态
MobileGym: A Verifiable and Highly Parallel Simulation Platform for Mobile GUI Agent Research
本文推出了 MOBILEGYM,这是一个基于浏览器托管的轻量级、全可控移动 GUI Agent 模拟平台。该平台通过结构化的 JSON 状态表示实现了高保真交互与确定性状态校验,并配合 MOBILEGYM-BENCH(包含 416 个任务模板)为手机操作智能体的在线强化学习(RL)提供了极低成本且高度可并行的环境。
TL;DR
中科院自动化所与北大等团队联合推出了 MOBILEGYM,这是一个专为移动 GUI Agent 设计的轻量级、可验证且高度并行的模拟平台。它抛弃了沉重的安卓模拟器镜像,采用浏览器托管方案,将应用状态结构化为 JSON,实现了 3 秒冷启动、单服务器支持 400+ 并行实例 以及 100% 确定性的结果校验。实验证明,在此环境中训练的智能体在真机上表现出了极高的策略迁移成功率(95.1%)。
痛点深挖:沉重的模拟器与不可控的真实世界
在移动 GUI Agent 的研究坐标系中,研究者长期在大规模训练的“扩展性”与真实任务的“验证性”之间挣扎:
- AndroidWorld (模拟器路线):虽然可控,但内存开销极大(单实例 >4.5GB),且难以模拟真实 App(如支付宝、微信)的私有后台。
- MobileBench-OL (真机路线):虽然贴近真实,但环境难以重置,操作涉及真实金钱或隐私,且由于 App 版本漂移和网络延迟,实验几乎无法复现。
- VLM 裁判的局限:依赖多模态模型来判断任务是否成功不仅贵,而且错误率高(本文审计发现误判率达 10.2%),无法作为 RL 的稳定奖励信号。
核心机制:以“交互保真度”为核心的状态模型
MOBILEGYM 的天才之处在于它不试图 1:1 复刻安卓内核,而是通过 Interaction Fidelity(交互保真度) 模拟 Agent 看到的界面和操作响应。
1. 分层状态模型 (Layered State Model)
作者将环境状态拆解为:
- World Data:海量的、只读的公共实体(如商品信息、帖子)。
- Runtime Overlay:Agent 操作引发的增量状态修改(如用户资料变更、设置开关)。
- OS Runtime:任务栈、键盘、通知等系统级中间态。 这种设计使得状态快照极小(JSON 格式),实现了毫秒级的快照保存与分叉(Fork),完美适配 GRPO 等需要多路并行采样的新型强化学习算法。
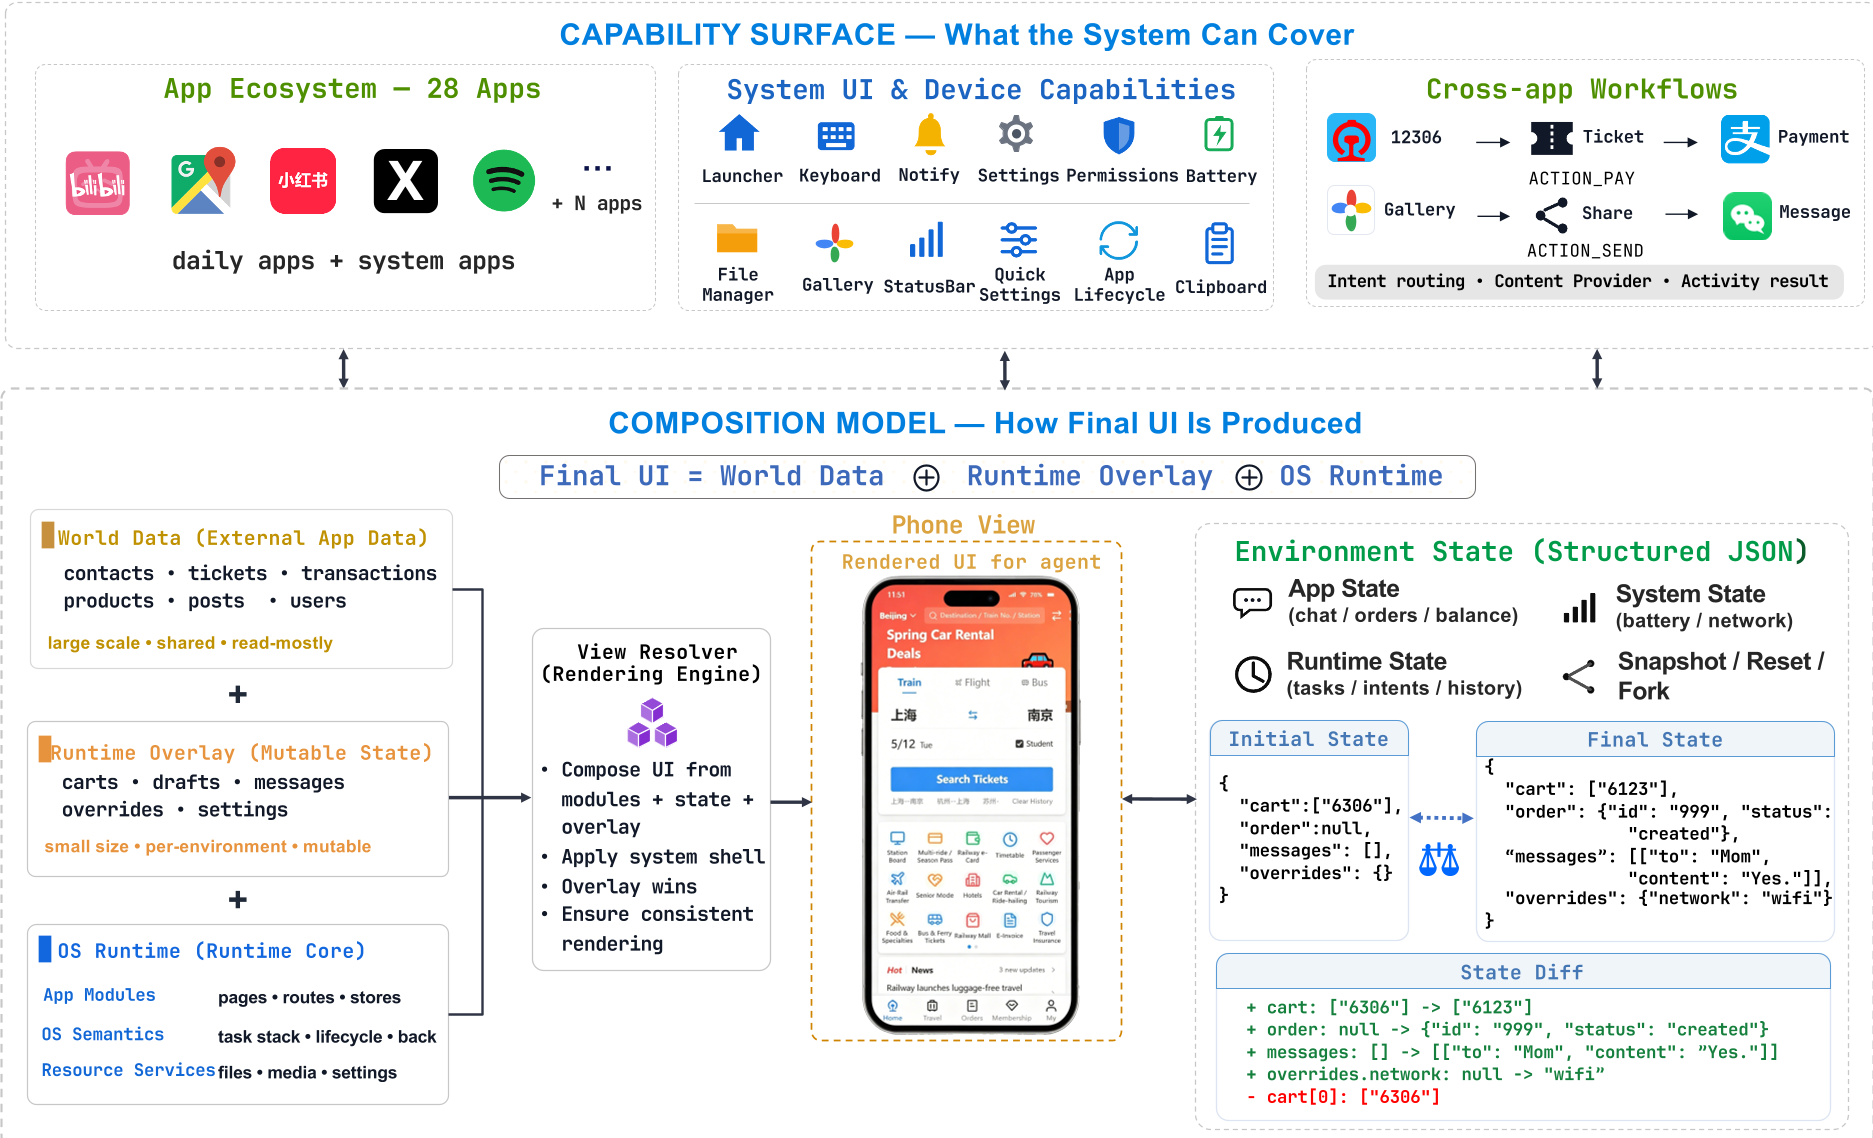 图 1:MOBILEGYM 的系统架构与分层状态模型
2. AnswerSheet 协议:消灭自由文本匹配的伪成功
传统的查询任务裁判通常在 Agent 生成的文本中搜索关键词,但这容易导致“伪成功”(Agent 猜对了答案但没真正操作)。MOBILEGYM 引入了 AnswerSheet 协议,强制 Agent 在 GUI 表单中填写特定类型的字段(数字、选择、日期)。裁判直接校验 JSON 中的字段状态,实现了绝对的确定性。
实验与结果:从模拟驱动真实世界的跨越解析
SOTA 对比与难度分级
研究团队构建了包含 416 个任务模板的 MOBILEGYM-BENCH,并基于 8 个参考模型(包括 Gemini 3.1 Pro 和 AutoGLM)的表现对任务进行了 4 级难度划分(L1-L4)。
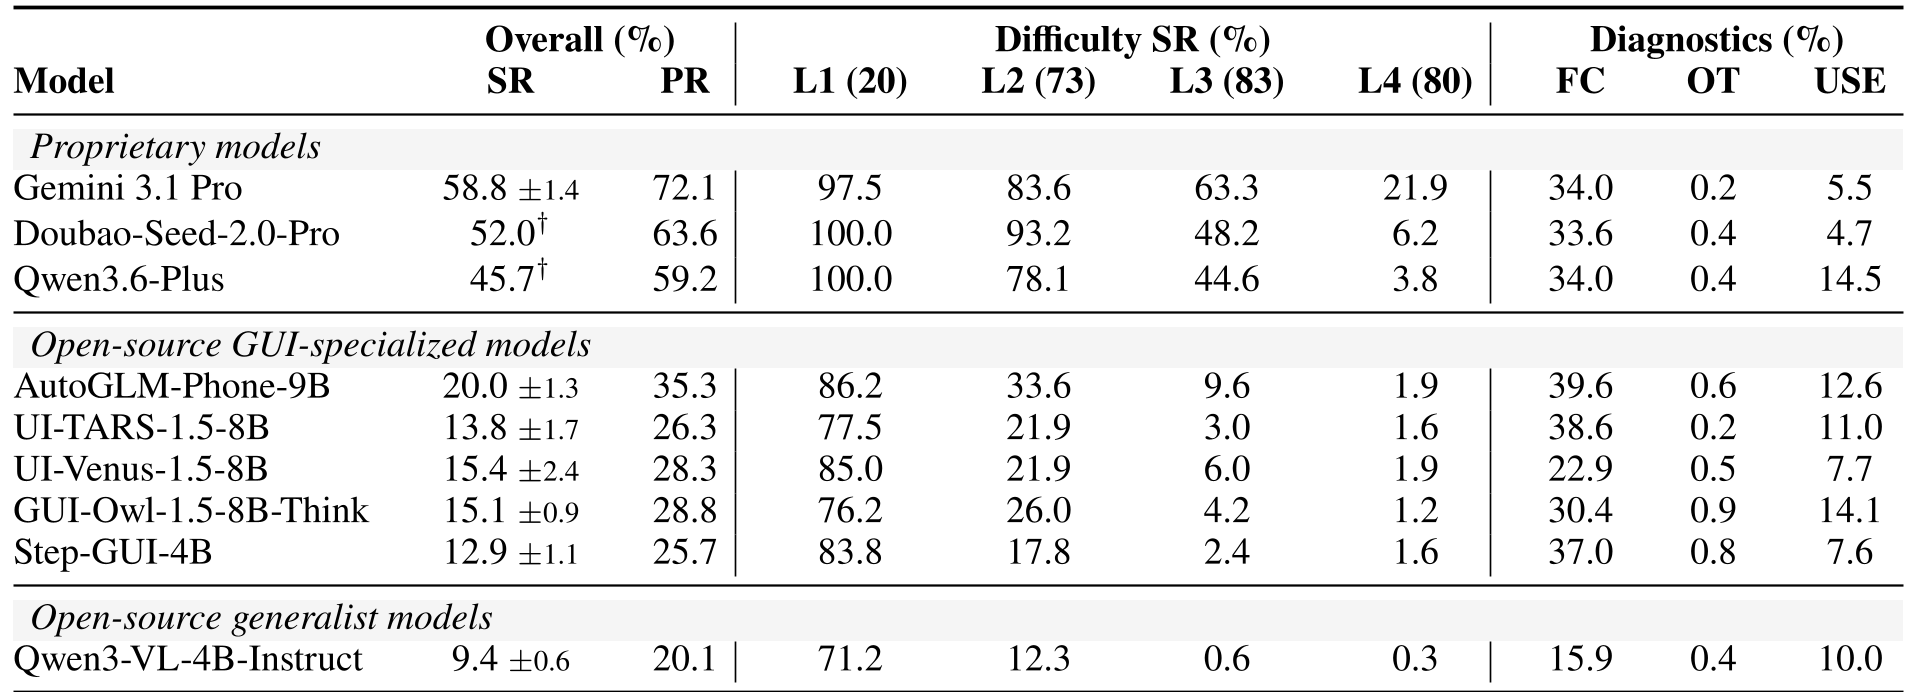 表 1:各主流模型在 MOBILEGYM-BENCH 上的性能表现。可以看到,顶级闭源模型在 L4 难度下依然面临巨大挑战(SR 仅 ~22%)。
Sim-to-Real 的惊人一致性
为了验证模拟器是否有意义,作者通过 GRPO 算法在云端利用 96 个并行环境训练 Qwen3-VL-4B 模型。结果显示:
- 性能飞跃:在测试集上获得了 12.8% 的显著提升。
- 真机迁移:在真机 Redmi Note 12 Turbo 上测试时,模拟环境中的训练增益被保留了 95.1%。这意味着在 MOBILEGYM 中学到的策略(如注意到界面上的必填星号)能直接应用到真实 App 中。
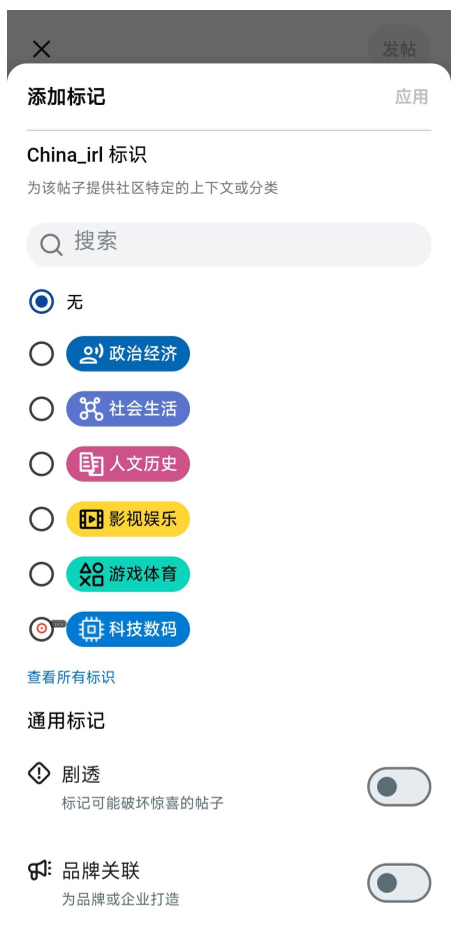 图 2:Case Study 显示,基础模型在真机上会反复点击灰色不可用的“发布”按钮,而训练后的模型由于在模拟器中刷过了类似逻辑,能敏锐识别出需要先填“标签”这一前置条件。
深度洞察与总结
核心价值: MOBILEGYM 的开源为 GUI Agent 社区提供了一台“廉价且高速的粒子加速器”。它通过剥离沉重的安卓内核(AOSP),仅保留交互语义(FSM),成功地将强化学习的训练门槛从原本需要上百台虚拟机的“云端巨兽”降级为普通服务器、甚至单机即可运行的科研项目。
局限性:
- 视觉细节偏差:虽然语义一致,但模拟界面的像素级细节(如阴影、特定动效)与真机仍有细微差异。
- App 覆盖度:目前仅覆盖 28 个应用的部分核心功能,扩展复杂应用的全部长尾功能仍需人工或 LLM 辅助开发。
总结: MOBILEGYM 证明了在 GUI Agent 研究中,“交互保真”比“物理还原”更重要。它不仅是一个基准测试集,更是一个高效的生产力工具,为未来构建具备自主进化能力的手机智能体(Self-improving Agents)打造了最坚实的数字底座。