
深度综述:Model-based RL 的演进逻辑——从显式动力学到隐式规划
Model-based Reinforcement Learning: A Survey
本文是关于模型强化学习 (Model-based RL) 的全面综述。文章系统化地梳理了该领域的两大核心支柱:动力学模型学习 (Dynamics Model Learning) 和规划与学习的集成 (Integration of Planning and Learning),旨在通过整合前人工作为 MDP 优化提供统一的技术框架。
TL;DR
如果说 Model-free RL 像是在黑暗中靠肌肉记忆摸索的探险者,那么 Model-based RL 就是随身携带地图与手电筒的智者。本文解析了 Moerland 等人的重磅综述,深入探讨了 AI 如何通过“脑内模拟”提升决策效率,并剖析了将模型嵌入神经网络(隐式模型)的未来趋势。
背景定位:为何我们要关注 Model-based RL?
在深度强化学习领域,Model-free 方法(如 DQN, PPO)虽大放异彩,但在现实世界(如机器人控制、自动驾驶)中往往面临样本利用率极低和缺乏安全性保障的难题。Model-based RL 的核心直觉在于:利用一个动力学模型 (Dynamics Model) 来模拟环境响应,通过在“脑海”中进行成千上万次的试错(规划),从而减少在昂贵且危险的现实环境中的交互。
核心挑战:构建完美的“数字孪生”
想要在脑内完美模拟世界并不容易,论文指出了动力学模型学习必须跨过的几道坎:
- 随机性 (Stochasticity):环境并非总是确定性的。
- 不确定性 (Uncertainty):由于数据有限,模型在未见过的区域会产生“幻觉”。
- 多步预测飘移 (Multi-step Prediction):一步错步步错,微小的单步误差在长距离规划下会迅速溃散。
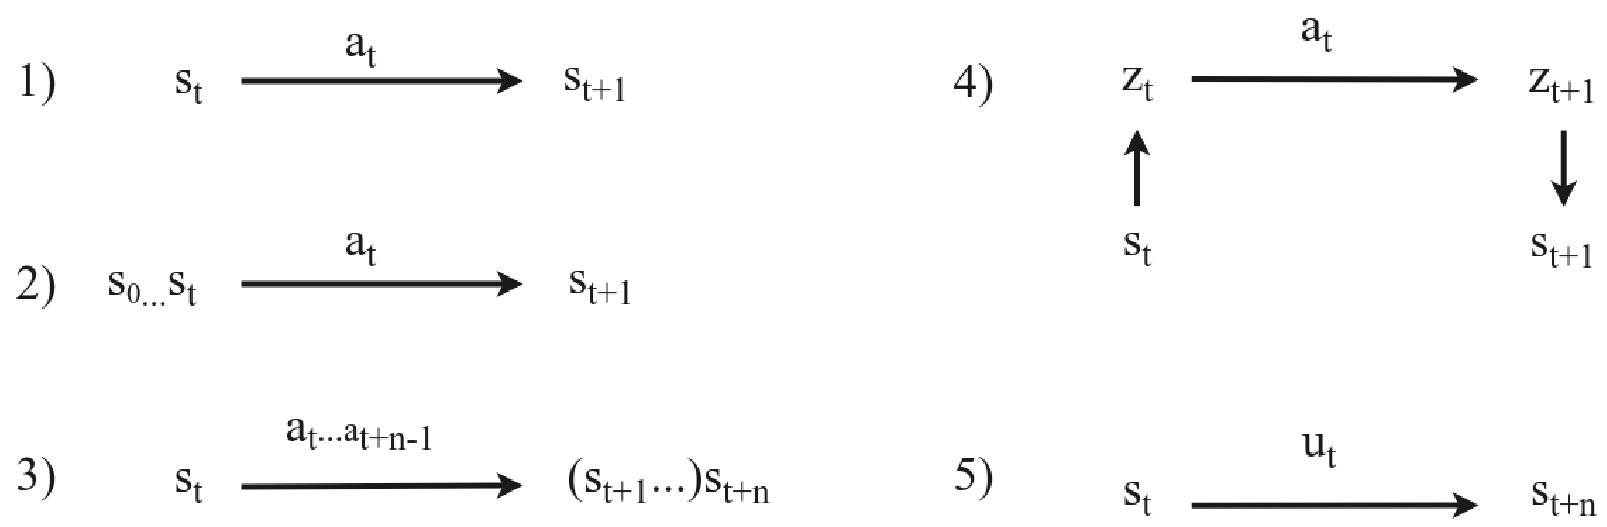
为了解决这些问题,文中提到了多种高级技术,如利用变分推理 (Variational Inference) 处理随机性,以及通过状态抽象 (State Abstraction) 将原始像素压缩到潜在空间进行高效规划。
集成艺术:规划与学习如何“合体”?
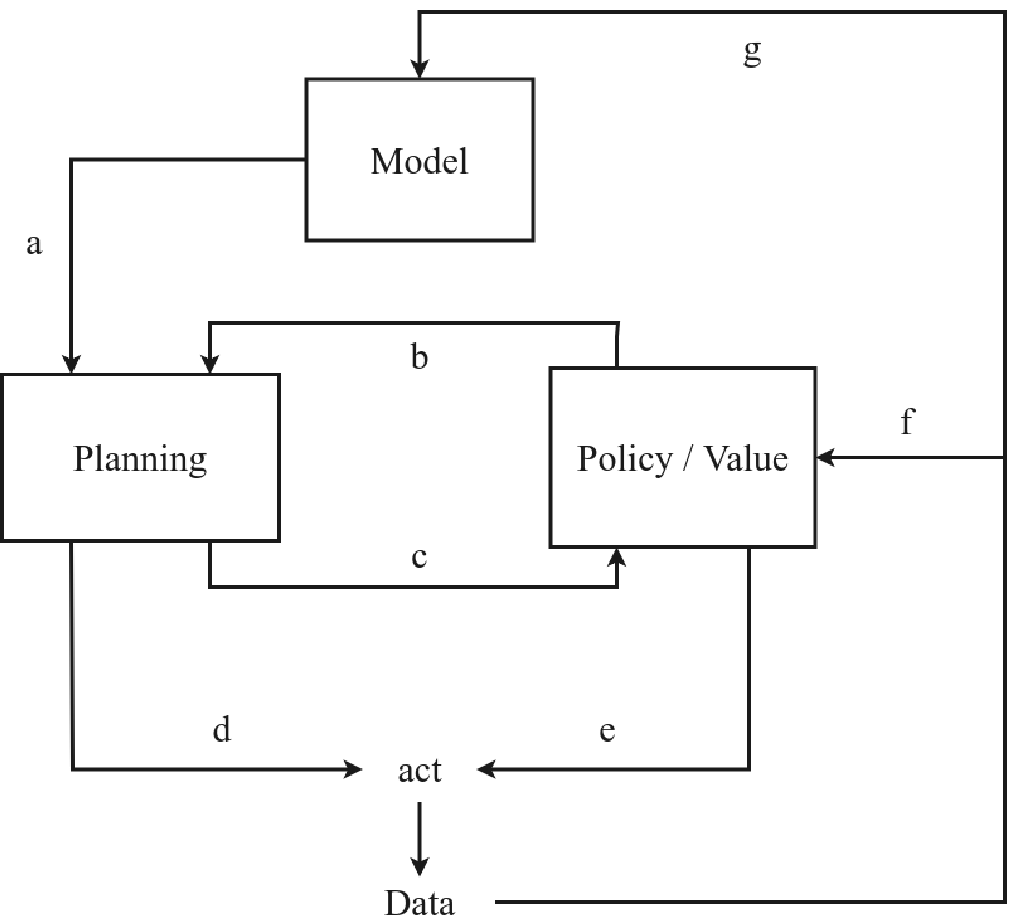
有了模型后,如何将其与学习算法集成?作者提出了一个系统化的思维导图:
- 何时规划? 是每一步都停下来思考,还是收集一轮数据后再集中“闭关”?
- 如何规划? 是像 Dyna 一样在前人路线上随机采样,还是像 AlphaZero 这样利用 MCTS 进行深度前瞻?
- 如何反馈? 规划出的好主意,是直接用于行动,还是用来训练那个“大脑”(策略网络)?
深度洞察:从显式到隐式的跨越
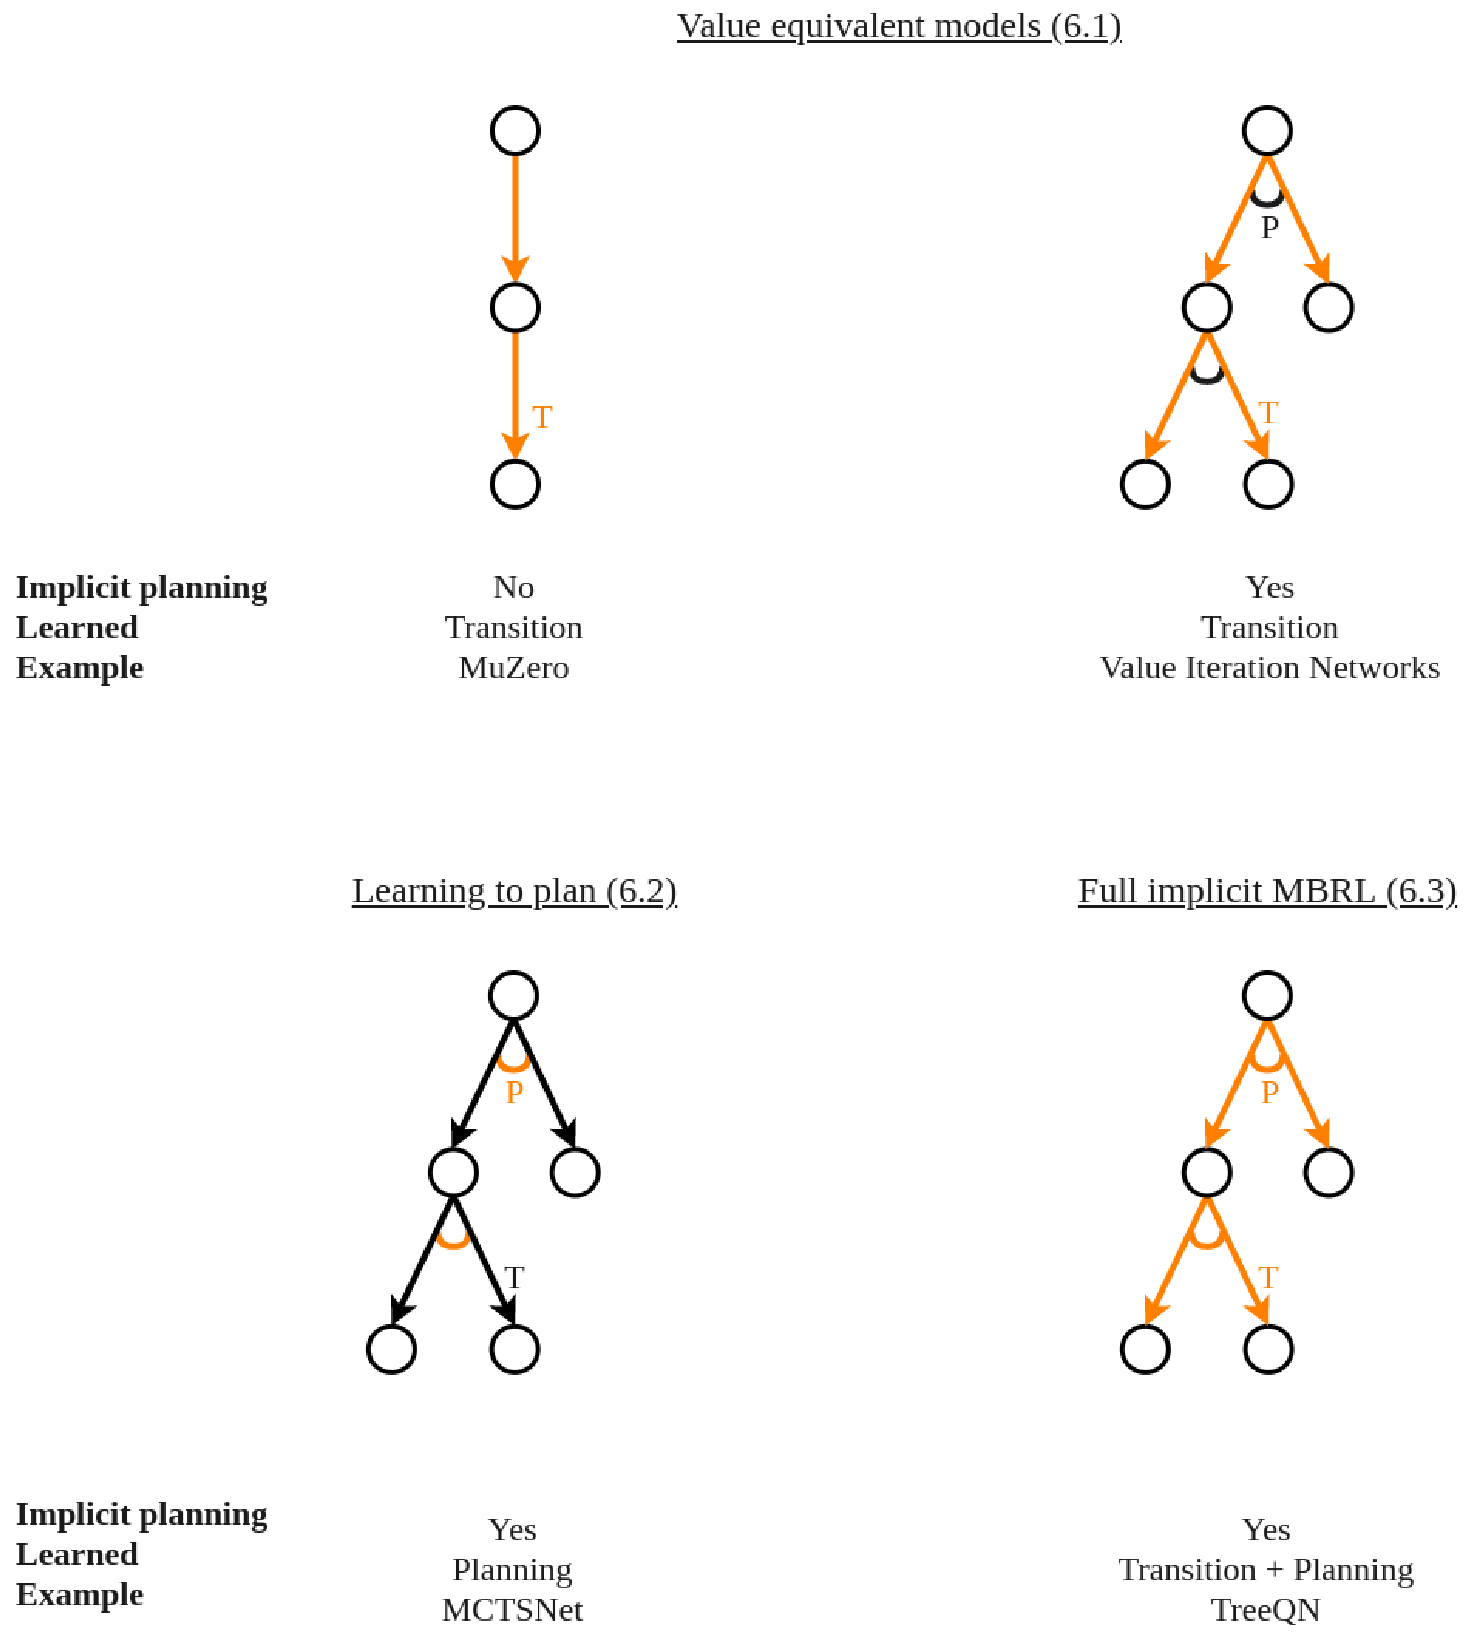
最令人兴奋的部分是作者对 隐式模型 (Implicit Model-based RL) 的归纳。如 Value Iteration Networks (VIN) 和 MuZero,它们不再强求模型必须能还原真实的图像细节,而是学习“对预测价值有用的特征”。这种值等价 (Value Equivalence) 原则打破了传统黑盒模型的束缚,极大提升了算法在复杂任务上的 asymptotic performance。
总结与未来启示 (Takeaways)
Model-based RL 的核心魅力在于它提供了解决 RL 问题的“第二曲线”:
- 数据效率 (Data Efficiency):用计算力换样本量。
- 深度探索 (Deep Exploration):基于不确定性的有目的探索,而非无头苍蝇般的随机扰动 (Jittering)。
- 双系统理论 (Dual Process Theory):像人类一样结合“快思考”(策略网络)与“慢思考”(前瞻规划)。
虽然 Model-based RL 带来了额外的超参数计算负担,但随着我们对模型不确定性估计(如 Bootstrap Ensembles)和分层强化学习 (HRL) 理解的加深,这种能“未雨绸缪”的 AI 必将在自动决策领域大放异彩。