
Mo’ Models, Mo’ Problems:异质多智能体系统不能把模型池越大越好
Mo' Models, Mo' Problems: How to best select model pools when designing Multi-Agent Systems
本文研究 Multi-Agent Systems 中候选模型池的选择问题,系统评估 23 个模型、8 种选择策略以及 Routing、Majority vote、LLM-as-a-Judge 三类聚合架构。论文发现 oracle 上的“更多模型更好”并不能在实际多智能体系统中稳定兑现,扩大候选池经常使性能低于池内最佳单模型;相对收益最稳的策略是在单一模型家族内部选择候选。
TL;DR
这篇论文把 Multi-Agent Systems 的设计问题从“用什么聚合架构”进一步收窄到“先选哪些模型进池”。作者评测 23 个开源模型,覆盖 6 个架构家族、2B 到 1.6T 参数、dense 与 Mixture-of-Experts、reasoning 与非 reasoning,并构造 15.5k 题校准集,在 HLE、GPQA-Diamond 和 FrontierScience-Olympiad 三类科学推理基准上比较 8 种候选选择策略。核心结论很尖锐:oracle 显示候选池越大越好,但 achieved 性能经常低于池内最佳单模型;最稳的相对增益来自单一模型家族内部,而不是把尽可能多的异质模型强行组装在一起。
背景定位
这项工作属于实证分析与系统设计诊断型论文,不是提出新 router 或新 judge 的方法型工作。它的贡献不在于刷新某个榜单,而在于给异质 MAS 工程实践补上一个常被忽略的变量:候选模型池 C 的构成。论文把自己放在经典 ensemble learning 与 LLM routing、majority vote、LLM-as-a-Judge 之间,指出现有研究大量关注系统结构如何变复杂,却很少回答“哪些模型应该进入这个结构”。这种问题意识使其更像一篇面向系统失败机制的测量论文,而不是单纯追逐更高 accuracy。
问题与动机
如果只看 oracle,异质模型池似乎天然应该更强:候选越多,某个模型在某道题上答对的概率越高,理论上限越高。论文第 4.2 节和 Figure 4 显示,随着 k 增大,oracle 性能普遍上升,按 Accuracy 或 Accuracy 与 diversity 组合选择时潜力最高。但作者真正问的是:这个理论上限能否被具体架构兑现?这正是异质 MAS 的痛点所在。
失效机制并不抽象。对 before-generation routing 而言,一个 router 要想学到“哪个模型更适合哪类题”,前提是候选模型之间存在可识别的任务互补性;但论文发现,领域 specialization 并不总转化为可识别专长,Figure 3 和附录 A.6 显示,同为 Llama-3.1-8B-Base 微调出来的物理和化学 specialist 在科学推理子域上并没有稳定胜过普通 Llama,反而 generalist 在物理、化学问题上也更强。于是 router 很难从“强模型堆叠”中获得清晰专家信号。
对 after-generation Majority vote 和 LLM-as-a-Judge 而言,问题又不同。系统先让多个模型生成答案,再折叠成一个最终答案。若候选模型的 solution diversity 过高,答案空间会被污染:正确回答可能被大量相近但错误、或者风格迥异的回答淹没。论文第 5 节把这一点概括为“There can be too much diversity”。这不是效果不够好的笼统抱怨,而是一个具体的聚合失败:oracle 假设每题都能挑选正确答案,但真实架构没有上帝视角,只能从已生成答案集合中聚合。
核心章节:模型池选择才是异质 MAS 的隐藏架构超参
现象与度量方式:做对的题高度重叠,做错的题却分散
论文的起点不是设计复杂 MAS,而是先问:模型卡信息是否足以预测候选池表现?作者把可预先获得的信息归为 size、release date、architectural family 与 domain specialization;把需要评测后才能获得的信息归为 accuracy、correct-answer diversity 与 error diversity。这里的 correct-answer diversity 用 pass@1 成功题集合的 Jaccard distance 表示:令 为模型 i 在校准集上做对的题目集合, 为模型 j 做对的题目集合,则
这个式子的作用是把“两个模型做对的是同一批题,还是各做对各的题”变成可排序的成对距离。它承担论文论证链中的关键角色:如果不同强模型总在同一批题上成功,那么把它们放进同一个池子里并不会带来太多新的正确覆盖;反过来,只有当 与 重叠较低时,候选池才可能提供互补成功。若把分子中的交集强制置零,距离接近 1,表示两个模型几乎从不共同答对,这正是理想中的互补 expert;但论文 Figure 2 显示现实并非如此,更准确的模型做对的题目更相似,相关系数 ,而它们的错误题集合相关性只有 。这意味着“正确能力”高度同质,而“失败模式”更分散,给聚合策略带来不对称难度。
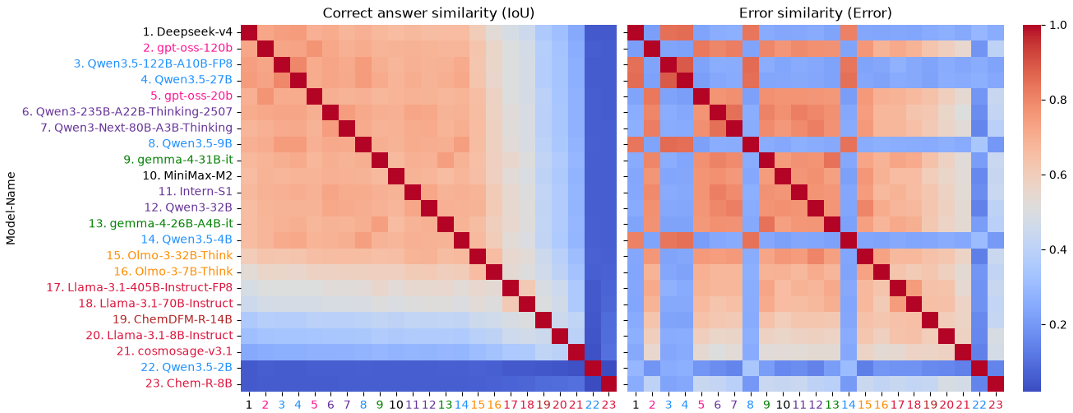
误差多样性则通过 pass@1 错误答案在多选题上的成对距离估计,论文只使用 MCQ 子集以减少错误答案文本不一致造成的聚类噪声。这个设计选择很重要:它不是把所有错误当成等价错误,而是试图把“同样不知道答案”与“以相似方式答错”区分开。Figure 2 右侧和附录 A.5 显示,Deepseek-v4 与 Qwen3.5 在错误侧更像同一家族,而 gemma、gpt-oss、OLMo3、Qwen3、MiniMax 的错误模式彼此不同。换言之,错误多样性更像 architecture family 的指纹,而不是简单的参数大小函数。size 与 accuracy 有中等相关 ,但与 correct answer similarity 只有弱相关 。所以“大模型更准”大体成立,但“大模型覆盖不同题目”并不成立,这直接削弱了仅靠 size 或 model card 信息构造候选池的可行性。
实验设计与控制变量:八种候选选择与三类聚合机制
论文的实验框架可以拆成三层。第一层是候选生成:给定模型全集 ,按 size、family、LLM chosen、accuracy、IoU diversity、error diversity、accuracy 与 diversity 联合优化、以及 5 个 random subsets 基线,得到排序后的 。第二层是 oracle 上限:对任意子集 C,不经过真实聚合器,而假设每题都能选出正确模型,得到
其中 是测试题目集合, 是模型 m 对题 q 的生成答案, 是标准答案,方括号表示答案等价的指示值, 由 judge 判定。这个式子在论文中的作用是定义理论天花板:它告诉读者“如果有一个完美选择器,这个候选池最多能好多少”。它的边界也很关键:Oracle 假设每题独立选择且不受聚合架构限制,因此不能与真实 MAS 等价。若把式中的 换成单一固定模型,式子就退化为普通 pass@1;论文正是通过保留 来把 potential 与 actual 分开。Figure 4 显示,按 Accuracy 或 LLM chosen 组合出的池子在 oracle 上最有吸引力,而按 IoU 或 Error diversity 的 oracle 提升相对有限,这说明单纯最大化正确覆盖并不自动等于最大潜在 accuracy。
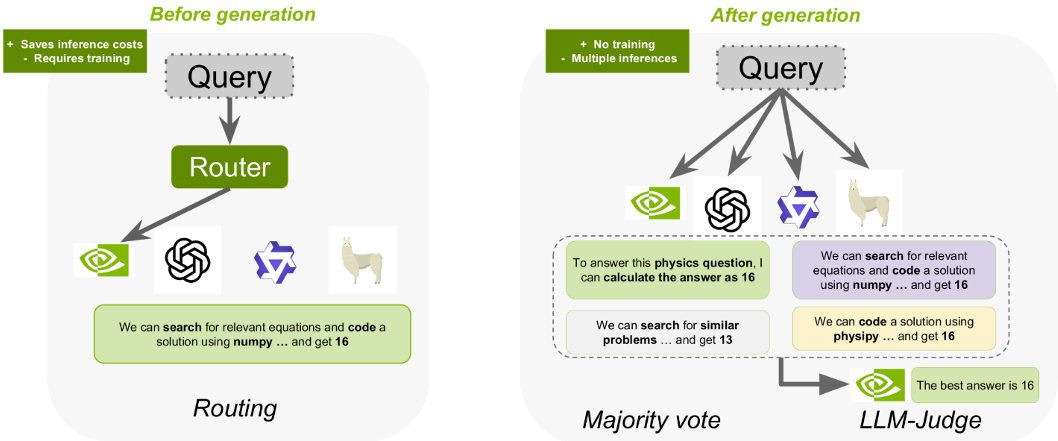
第三层是 achieved MAS。论文实现三种系统:Routing 作为 before-generation 架构,借鉴 AvengersPro 训练简单 clustering router;Majority vote 使用 E5-Large-V2 嵌入,每题每模型生成 5 个答案,再用 agglomerative clustering 聚合,cosine distance threshold 为 0.15;LLM Judge 实现 GenSelect,用 gpt-oss-120b 进行 tournament-style 选择。为了把增益写成可比量,论文报告相对池内最佳模型的差值:
这里 根据架构不同而定义:routing 使用最佳模型 pass@1,majority vote 使用最佳模型的 majority@5,LLM judge 使用 judge 在单模型最佳生成上的平均。这个式子比绝对 accuracy 更适合回答工程问题:一个 MAS 是否真的超过系统中已经存在的某个强模型?如果 为负,增加模型数与聚合复杂度不仅没有收益,反而引入系统不稳定性。论文 Figure 1 与正文第 3 节共同展示了这种架构对照:
实验控制还包括训练分布检查。校准集来自 AOPS、Turing、Scale、Stack-Overflow 的相对均衡子集,附录 A.4 的 Figure 8 显示训练子集与三个测试基准的相对模型性能相关性超过 0.9,p 值小于 量级。这排除了一个常见质疑:候选模型排序是否只是因为训练集和测试集分布差异过大而失效。作者还验证 judge 质量,附录 A.2 显示 gpt-oss-120b 与人工评分一致率为 93%,Cohen’s kappa 为 0.63,且 judge 更倾向于判正确而非判错误,因此绝对 accuracy 可能偏高,但相对排序应仍有一定可用性。
归因分析与反例:为什么高 Oracle 潜力反而无法兑现
最有反直觉的发现是,高 oracle potential 与 achieved performance 可以严重脱节。论文第 4.3 节的 Figure 5 显示,对大多数 intentional groupings,随着 k 增大,相对单模型最佳的性能下降;很多精心选择的异质池甚至不如 5 个 random baseline。原因并不在“模型太少”,而在“模型太杂”。异质池提高了某题至少一个模型答对的概率,但也提高了错误答案的语义多样性。对 majority vote 来说,这会让聚类中心更难对应正确答案;对 LLM-as-a-Judge 来说,tournament-style 选择必须面对更多风格、推理链和错误方式,judge 的稳定判断能力反而被放大压力消耗。
论文进一步指出,真正偶尔稳定带来正向 的是同一家族池。形式化地,若架构家族标签为 t,则家族池可写作
其中 表示从全体候选模型 中取出的同一家族子集, 是模型家族标签。这个简单定义的深层作用是:同族模型具有相近输出格式、相近 reasoning mode、相近失败模式,因此 before-generation router 更容易学到边界,after-generation aggregator 也更容易稳定折叠答案。论文发现 Gemma4 家族在 HLE 上相对表现最好,OLMo3 家族在 Majority vote 上也有改善;但在其他家族上结果高度波动。若把 扩展到包含不同 backbone 或不同 post-training 风格, 不再受同族约束保护,负增益概率上升。这个反例说明,heterogeneity 不是自动资产,它可能是噪声源。
实验与证据
论文的主结果不是单点 SOTA,而是一组系统级对照。Table 1 列出 23 个模型的参数、年份与属性,正文和附录给出了关键统计量:
论文第 3 节、4.1 节、4.3 节和附录 A.2、A.4 报告了以下量化锚点:
| 指标 | 数值 | 论文含义 |
|---|---|---|
| 候选模型池规模 | 23 个模型,6 个架构家族 | 覆盖 2024 到 2026 年发布,从 2B 到 1.6T 参数 |
| 每题生成数 | 5 次 | 用于 pass@1、majority vote 与 judge 评估 |
| 校准集规模 | 15.5k 题 | 其中约 24.9% 为多选题,用于 router 训练与模型排序 |
| 正确题集合相关 | 更准模型做对的题高度重叠 | |
| 错误题集合相关 | 失败模式比成功模式更分散 | |
| 参数量与准确率相关 | size 可部分预测能力,但不足以保证互补 | |
| HLE 同模型 best pass@1 | 29.4% | 最佳单模型基准 |
| HLE 同模型 majority@5 | 32.2% | 同一最佳模型扩展采样数后的提升 |
| HLE 同模型 judge@5 | 36.5% | 同一最佳模型在 judge 架构中的提升 |
这张表说明同质系统内部确实存在提升空间:把同一个 best model 从 pass@1 扩展到 majority@5,HLE 从 29.4% 到 32.2%;再交给 judge 选择 5 个生成,可到 36.5%。但这个提升来自“同模型多生成”,而不是“异模型堆叠”。Figure 5 的核心趋势与此一致:在 HLE 上,多数异质分组相对 为负,只有同一家族系统偶尔给出正增益。论文第 4.3 节提到,在 FrontierScience-Olympiad 和 GPQA 上,Accuracy 与 Accuracy-optimised 指标相关分组只出现约 2% 和不到 1% 的小幅 MAS gain,说明即使找到少数正向设置,幅度也有限。
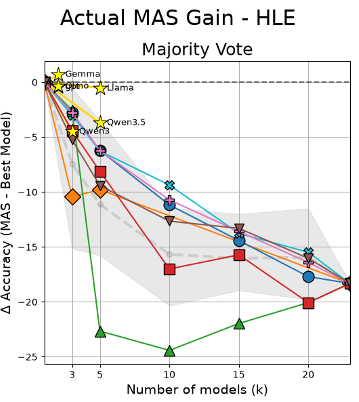
拆解性证据主要来自三处。第一,Figure 4 与 Figure 5 直接构成 oracle 与 achieved 的配对分析:前者证明候选扩大提高理论上限,后者证明同一池子在真实架构中往往无法兑现。第二,附录 A.3 检查 Majority vote 的聚类阈值,使用 0.10、0.15、0.20 三个 cosine distance threshold;Figure 6 与 Figure 7 显示整体模式相似,但 Accuracy、Acc×Error、Acc×IoU 等分组在更宽松阈值下出现小 gains。这说明论文结论不是阈值 0.15 的人造产物,但阈值确实会影响异质池的边际表现。第三,Figure 3、11、12 对 specialist 与 generalist 做控制比较:从同一 base model 微调出的物理和化学 specialist 并未在对应领域稳定超越 generalist,且 specialist 独有答对的题目分布较平均,没有强领域绑定。这削弱了“domain specialization 自动提供互补性”的假设。
证据质量方面,论文最强的是跨数据集一致性:作者主要在 HLE 展示主图,但指出 GPQA 与 FS 的模式大体保留,并在附录 B.1、B.2 给出完整结果。较弱的部分在于异质 MAS 架构仍偏简单:routing 只选择一个 backbone,majority vote 只选一种 embedding 与聚类方式,judge 只用一个 LLM。论文自己也承认 LLM judge 的高 k 表现可能受 context length 影响,并且家族分组受每家族模型数量限制,无法测完所有 k。因此“更多模型通常变差”这一结论应理解为:在当前三类简洁架构、当前 23 个候选、科学推理任务与 judge 设置下,异质池扩大不稳定;它不等价于任何更复杂架构都无法管理异质性。
深度洞察与总结
论文的核心贡献是把 model pool selection 从工程默认项提升为 MAS 研究的可测变量。它没有给出一个万能选择器,而是给出一个更保守的设计原则:在没有充分评测候选模型行为之前,不要假设异质性会自动带来互补性。对 before-generation routing,互补性必须来自可识别任务边界,而不是来自不同模型名称;对 after-generation vote 与 judge,answer diversity 需要控制在聚合器能识别正确中心的范围内。这也是论文标题 Mo’ Models, Mo’ Problems 的技术含义:模型数量增加,系统问题并不线性减少,反而可能指数增加。
局限性需要具体指出。首先,模型选择策略依赖 calibration set 和 judge,而 judge 是 gpt-oss-120b,且作者承认该 judge 更可能判正确,因此绝对 accuracy 与相对排序都可能受 judge 偏差影响。其次,论文只选择科学推理任务,没有覆盖数学、代码、长上下文或工具增强任务;作者说明科学推理任务单模型 accuracy 更低、MAS overhead 更明显,但这个选择也可能放大异质池不稳定的影响。再次,候选模型池只有 23 个,并且同家族规模有限,导致 family 策略不能扩展到足够大的 k。最后,论文没有启用 tool use 或 retrieval,因为不同模型的 sandbox 与工具偏好会干扰比较;但真实 MAS 部署中工具使用极常见,这使结论的迁移边界仍需后续验证。
未来最有价值的方向不是简单扩大模型数量,而是设计“为异质性而生”的聚合器。可能的具体路线包括:用 embedding 或 NLI 训练 answer-cluster 一致性模型,以显式估计 majority vote 的鲁棒性;用同族但不同 reasoning budget 的模型构造受控 diversity,避免跨架构风格污染;为 router 引入 annotated expertise 或 fine-tuned specialist,而不是只从 model card 和通用 benchmark 推断;以及在 judge 架构中把 per-model best generation 与 cross-model pairwise ranking 分离,降低 tournament 中的长上下文损失。这项工作真正留下的不是“异质 MAS 无用”,而是“异质 MAS 的成功条件必须被测量和报告”。