
MIA:解耦环境接口与任务逻辑,开启强化学习微调的高效迁移新时代
Modular Interface Adapters for Cross-Environment Reinforcement Fine-Tuning Transfer
本文提出了 Modular Interface Adapters (MIA),一个用于强化学习微调 (RFT) 的参数高效迁移框架。该方法通过解耦环境特定的接口与任务级策略表征,实现了在异构环境间的快速策略迁移,在 continuous control 和机器人任务中刷新了 SOTA 效率。
TL;DR
在强化学习(RL)部署中,从模拟器到现实世界(Sim-to-Real)的跨越往往意味着巨大的环境差异。本文提出的 Modular Interface Adapters (MIA) 框架,通过引入轻量级的“接口适配器”,在不触动核心策略模型的前提下,仅需更新不到 0.5% 的参数,便能实现比传统方法快 5 倍的环境适应速度。
背景定位:RFT 的下一站是“无缝迁移”
强化学习微调 (Reinforcement Fine-Tuning, RFT) 已经成为提升模型决策能力的核心手段。然而,当我们的代理(Agent)从一个完美的仿真环境切换到充满噪声且动力学特性各异的现实环境时,其性能往往会断崖式下跌。目前的方案要么太“重”(全量重训),要么太“脆”(零样本迁移)。MIA 的出现,提供了一个优雅的折中点:模块化适配。
痛点深挖:为何迁移如此之难?
作者指出,问题的根源在于现有策略网络将“如何感知环境”(Observation)、“如何理解任务”(Logic)和“如何执行动作”(Action)这三者紧紧耦合在一起。
- 环境变了,逻辑却没变:当你给机器人换个摄像头或换个摩擦力更大的地面,它的“走路逻辑”其实没变,但它的“视觉输入”和“足端反馈”全变了。
- 参数冗余与遗忘:为了应对上述微小变化而重修数亿参数的任务模型,不仅效率极低,还会导致原本学好的技能在微调中丢失。
核心方法论:MIA 的解耦艺术
1. 架构三剑客
MIA 将策略 拆解为三个模块:
- 观测适配器 (Observation Adapter, ):将环境特定的原始信号编码进一个共享的隐空间 。
- 任务策略 (Task Policy, ):固定的核心,只在隐空间内进行逻辑推理。
- 动作适配器 (Action Adapter, ):将隐空间的指令翻译成当前环境下具体的控制参数。
2. 低秩适配器设计
为了极致的参数效率,MIA 采用了类似于 LoRA 的低秩设计。公式如下: 由于 bottleneck 维度 ,这使得在迁移时,我们只需要训练极少量的权重。
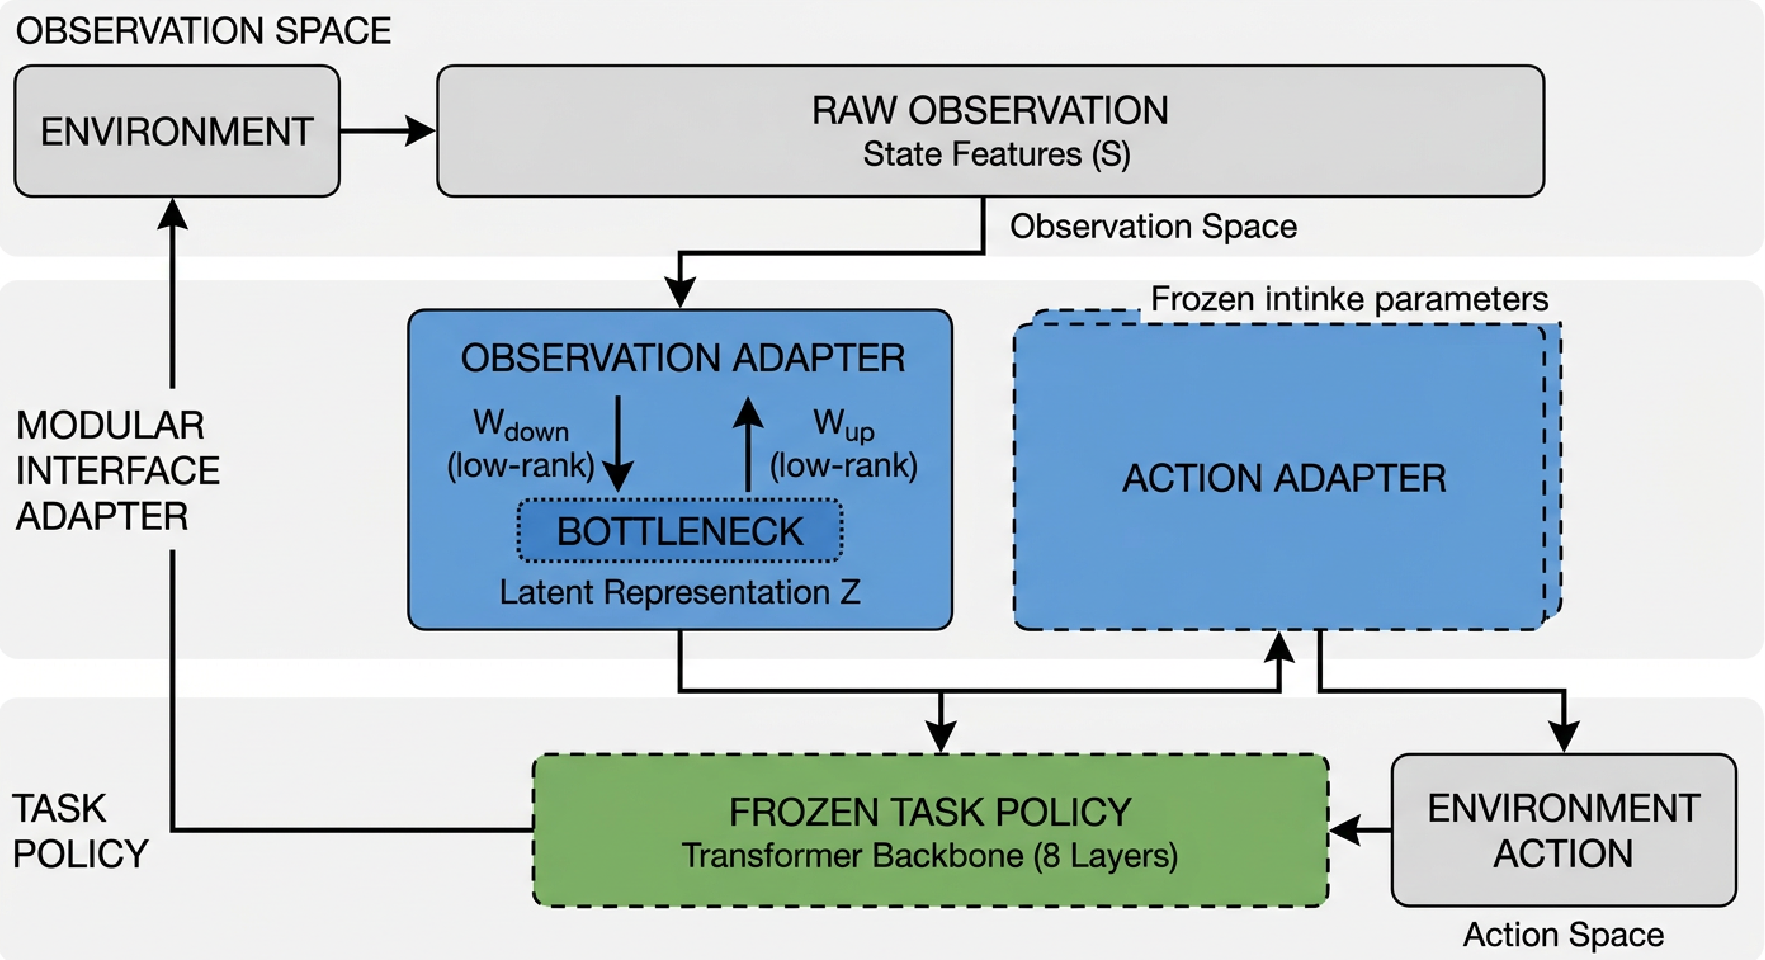 图 1:MIA 架构图。可以看到核心 Task Policy 被冻结,变化的只有两侧的适配器。
3. 三阶段训练流程
- 阶段 1 (Source Training):在源环境中训练出扎实的任务模型。
- 阶段 2 (Meta-Learning):利用元学习寻找适配器的最佳初始参数,提升“学习如何学习”的能力。
- 阶段 3 (Target Adaptation):在目标环境通过极少量样本微调适配器。
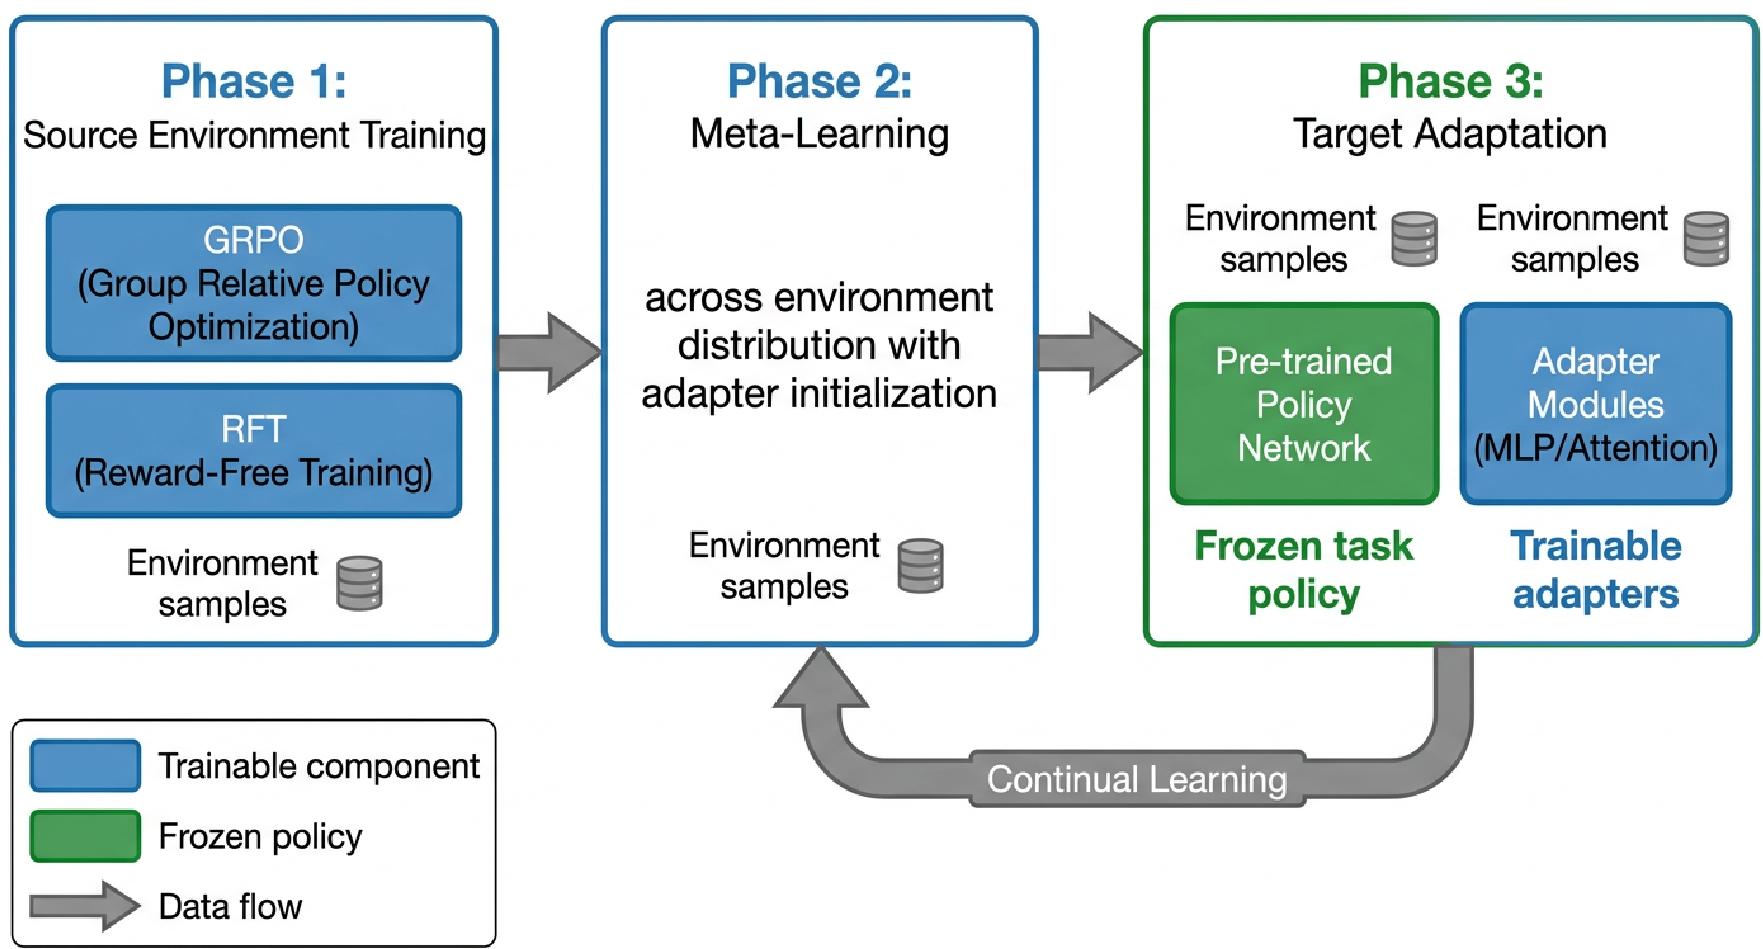 图 2:MIA 的迭代训练与适配逻辑。
实验战绩:以小博大的胜利
在 MuJoCo 连续控制和 A1 四足机器人实验中,MIA 展现了惊人的效率:
- 参数极度精简:相比全量微调 (Full FT) 100% 的参数更新,MIA 仅用了 0.45% 的参数更新量。
- 性能毫不妥协:在多项任务中达到了 Full FT 约 87% ~ 92% 的水平,远超传统的 Feature Extraction 或 MAML。
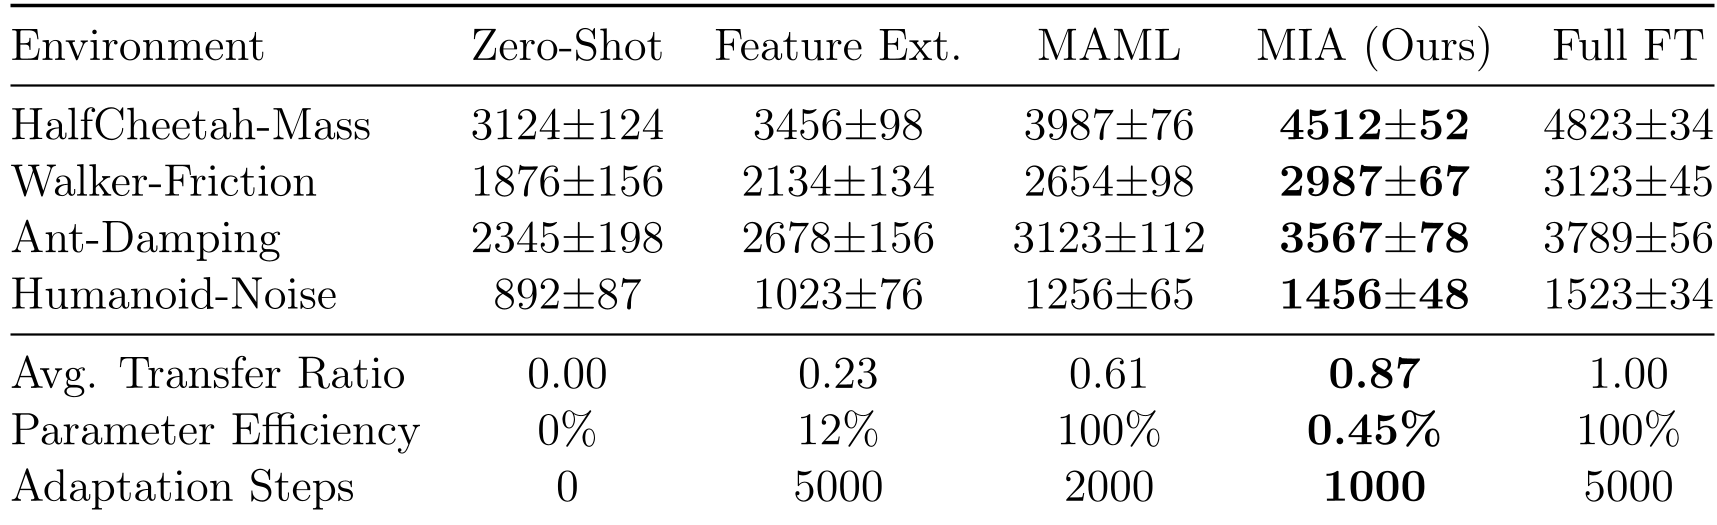 表 1:在不同环境(质量变化、摩擦力变化、噪声注入等)下的性能表现。MIA 在迁移率和步骤数上均表现优异。
深度洞察:为什么这很重要?
- 适配器的可组合性:MIA 最让人兴奋的特性是其“线性插值”。如果你有一个针对“草地”的适配器和一个针对“冰面”的适配器,通过简单的权重线性加权,你就能瞬间得到一个针对“湿滑泥地”的适配器。这为构建持续学习 (Continual Learning) 的智能体库打下了基础。
- 观测 vs 动作:消融实验显示,观测适配器对性能的贡献远大于动作适配器(0.34 vs 0.71 的迁移比下降)。这说明在跨环境迁移中,如何“把新的输入对齐到旧的认知”比“调整输出习惯”更关键。
局限性与展望
尽管 MIA 表现卓越,但它依赖于“任务逻辑一致”的假设。如果目标环境的任务奖励函数发生了根本性改变(例如从前行变为旋转),单纯靠接口转换可能不足以修补性能损失。未来的研究方向可能会集中在自适应秩选择 (Adaptive Rank Selection) 和任务边界自动发现上。
总结
MIA 不仅仅是一个技术改进,它代表了一种模块化智能模型的哲学:在一个动荡多变的世界里,保持核心认知的稳定,通过动态调整“感官接口”来实现生存。这对于日益庞大的基座模型在细分场景的低成本落地具有重要的指导意义。