
[Nature BME 2026] BioMedAgent:从通用模型到“AI 数据科学家”的自我演进之路
Empowering AI data scientists using a multi-agent LLM framework with self-evolving capabilities for autonomous, tool-aware biomedical data analyses
本文推出了 BioMedAgent,一个具有自我演进能力的多智能体 LLM 框架,专门用于自主和工具感知的生物医学数据分析。通过集成 67 种专业生物信息学工具并利用交互式探索(IE)和记忆检索(MR)算法,该框架在 BioMed-AQA 基准测试中达到了 77% 的成功率,显著优于传统的 LLM 智能体。
TL;DR
生物医学研究正处于数据爆炸时代,但复杂的计算分析始终是临床医生的“拦路虎”。这篇来自中科院计算所、澳门科技大学等多家机构的研究论文提出了一种名为 BioMedAgent 的多智能体框架。它不仅能听懂自然语言指令,还能自主学习使用专业生物信息学工具,并像人类科学家一样通过“记忆”不断进化。在 BioMed-AQA 基准测试中,它以 77% 的成功率碾压了 ChatGPT-4o。
痛点深挖:为什么 LLM 做不好生物医学分析?
尽管 GPT-4 等大模型在文本处理上表现惊人,但在生物医学数据分析中常显得“笨手笨脚”:
- 工具盲区:许多生物信息学工具(如 BWA, GATK)需要特定的 Linux 环境和复杂的参数配置,LLM 很难凭空写出完美的代码。
- 缺乏后劲:传统的 Agent 往往是“一次性”的,处理完一个任务后不会总结经验,下次遇到类似问题依然可能犯同样的错。
- 推理断层:面对跨组学(Cross-omics)这种需要多步规划的任务,模型容易在中间步骤产生幻觉(Hallucination)。
核心机制:BioMedAgent 是如何工作的?
BioMedAgent 并非单一的模型,而是一个协同工作的“实验室”。如图 1a 所示,它主要包含三个阶段:规划(Planning)、编码(Coding)和执行(Execution)。
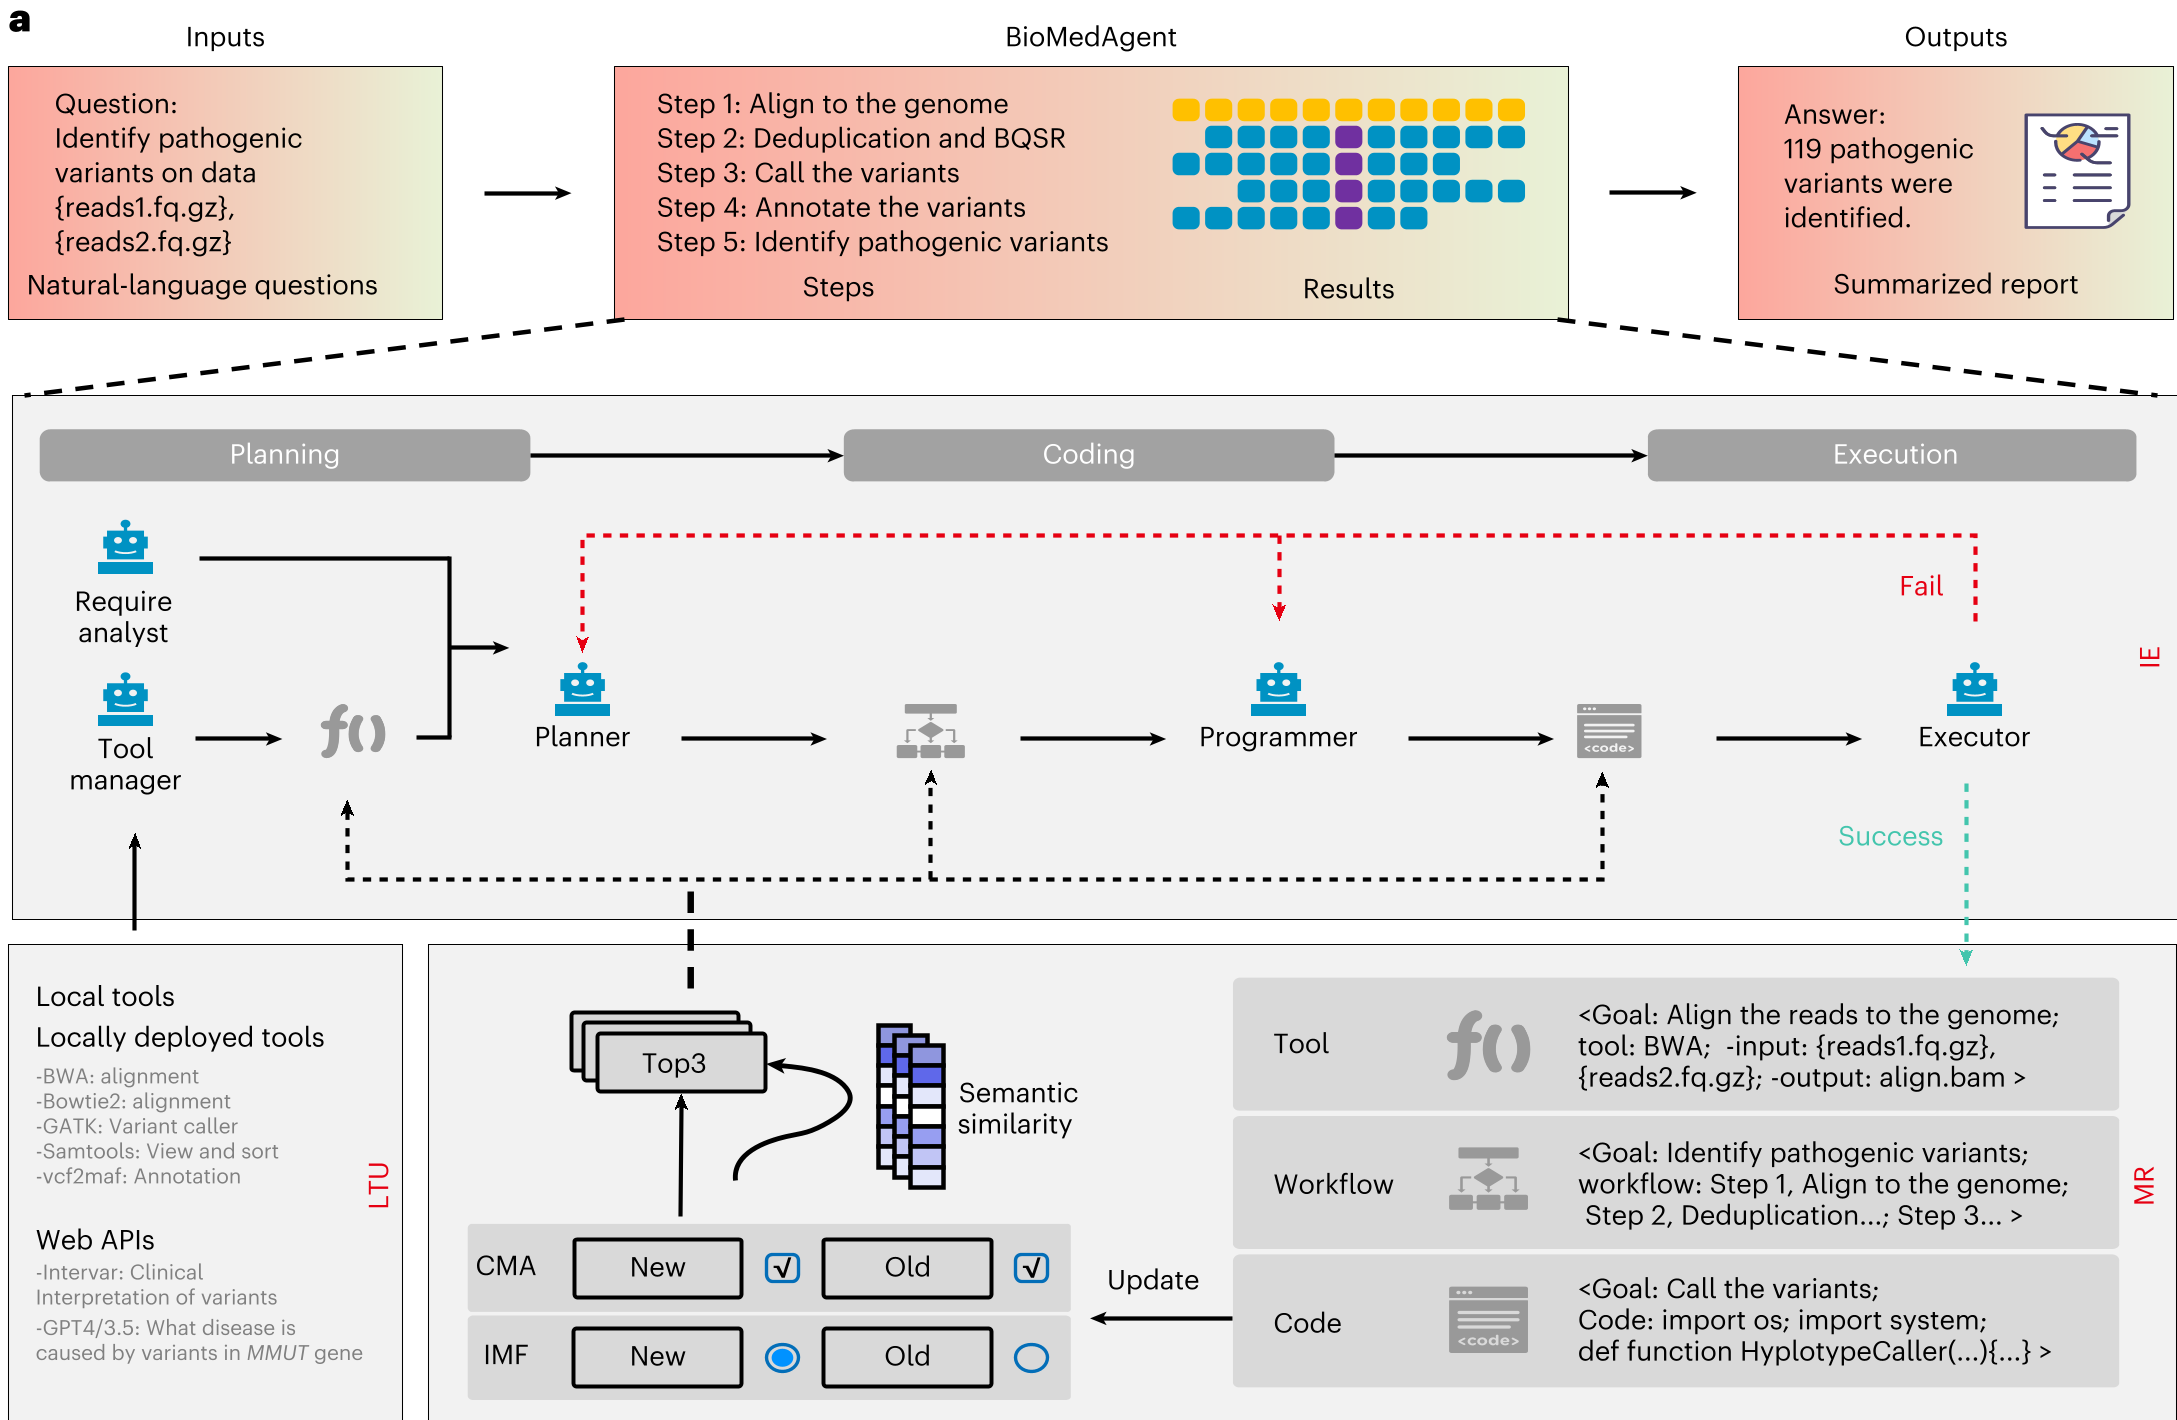
1. 工具管理器 (Tool Manager)
这是该框架的“武器库”。它通过学习工具文档,将 67 种专业生物信息学工具容器化。当用户输入“鉴定 pathogenic variants”时,工具管理器会进行两轮检索,精准锁定最适合的工具(如 Mutect2)。
2. 交互式探索 (Interactive Exploration, IE)
这是其代码修复的核心。当执行阶段报错时,执行智能体会将错误反馈给编码智能体,通过多轮讨论寻找逻辑漏洞。实验显示,IE 能够将成功率从 28% 提升至 52%。
3. 自我演进与记忆检索 (Memory Retrieval, MR)
这是最吸引人的部分。BioMedAgent 拥有三类记忆:
- 工具记忆:记录哪些工具好用。
- 规划记忆:将成功的工作流转化为可复用的“模板”。
- 编码记忆:保存经过验证的代码片段。
作者提出了 IMF (Iterative Memory Forgetting) 策略,模拟人类的遗忘,仅保留多个解法中最简洁、最高效的那一个,从而确保存储的高质量。
实验战绩:全方位的跨越
为了严谨评估,作者发布了 BioMed-AQA 基准,涵盖了组学、精准医疗、机器学习等五大领域。

在与 OpenAI 官方智能体的对比中,BioMedAgent 优势巨大:
- 组学分析 (O) 成功率:BioMedAgent (94%) vs ChatGPT-4o (不足 40%)。
- 跨领域鲁棒性:在外部基准 BixBench 上,其表现同样稳定,证明了它不是在“背题”,而是学会了“方法”。
深度洞察:为什么 IMF 策略优于 CMA?
研究发现,简单地堆砌记忆(CMA 策略)会导致性能在第二轮出现反常下降。这是因为过多的冗余信息干扰了检索。而通过 IMF(迭代忘记),系统在每一轮迭代后不仅存储量更小,检索效率和任务成功率反而更高。这种“减法”思维对于构建长期运行的 AI 系统至关重要。
实战案例:从文献复现到跨组学发现
论文展示了 BioMedAgent 在处理真实世界科研任务中的潜力:
- 癌症血栓预测:它仅凭自然语言,就完美复现了 Nature Medicine 上的一项研究,构建了基于液体活检 ctDNA 的预测模型,得到的 C-index (0.74) 与原著一致。
- 跨组学挖掘:它自主串联了 Bulk RNA-seq 和单细胞 RNA-seq(scRNA-seq)数据,锁定了 ABCC3 等肺癌相关的关键细胞来源标记物。
深度总结与局限
BioMedAgent 成功地将 Tool-aware (工具感知) 和 Self-evolving (自我演进) 结合在了一起。它不仅是一个助手,更像是一个能够从每一次分析任务中吸取教训、不断打磨技能的数字科学家。
局限性 (Limitations):尽管性能优异,BioMedAgent 依然无法完全摆脱大模型的“幻觉”底色,且对于工具基础设施的可靠性依赖较强。未来的进化方向可能是引入“负面经验”学习,让模型学会“避坑”。
这项工作标志着生物信息学正从“专家驱动”转向“AI 自驱动”的新阶段。对于那些被复杂代码困扰的生物医学研究者来说,BioMedAgent 带来的不仅是效率,更是科研范式的变革。