
多任务学习的高维博弈:基于多目标优化的帕累托最优解
Multi-Task Learning as Multi-Objective Optimization
本文提出了将多任务学习(MTL)重新定义为多目标优化(MOO)的框架,旨在寻找帕累托最优(Pareto Optimal)解。核心方法是引入了多梯度下降算法(MGDA)的变体,通过 Frank-Wolfe 算法高效求解多任务梯度冲突,并在大规模深度学习任务中实现了 SOTA 性能。
TL;DR
在多任务学习(MTL)中,不同任务往往像是在争夺食物的竞争者,盲目地将它们的损失函数加在一起(线性加权)往往会导致“两败俱伤”。Intel Labs 的这篇论文将 MTL 视为一个多目标优化问题,通过寻找帕累托最优解(Pareto Optimal Solution),确保在不损害任何一个任务的前提下,实现整体性能的最大化。
痛点深挖:线性加权的陷阱
长期以来,学术界处理 MTL 的标准套路是:。
这种方法存在两个致命缺陷:
- 任务冲突:当任务 A 要求参数向左走,任务 B 要求向右走时,线性加权只会得到一个平庸的折中(甚至原地不动)。
- 超参数地狱:寻找最优权重 需要极其昂贵的 Grid Search。
作者指出,真正的 MTL 目标应当是:找到一个解,使得如果你想进一步优化任务 A,就必然会牺牲任务 B。这种状态被称为“帕累托驻点”。
核心机制:MGDA-UB 与 Frank-Wolfe
1. 从几何角度理解梯度更新
MGDA 的核心在于:寻找一个更新方向,使得该方向与所有任务的梯度夹角都小于 90 度。这意味着沿着这个方向走,所有任务的 Loss 都会下降。如果没有这样的方向,说明当前达到帕累托最优。
2. MGDA-UB:效率的飞跃
原始 MGDA 每次更新都需要计算每个任务对所有共享参数的梯度。对于现代深层网络,这意味着 (任务数)次反向传播,极其缓慢。 作者提出了 MGDA-UB (Upper Bound):
- Insight:与其在数百万维的全参数空间找平衡,不如在**共享表示层(Shared Representation)**的输出端找平衡。
- 数学直觉:通过链式法则推导出梯度的范数上界,仅需一次反向传播获取表示层的梯度,计算开销从线性能耗降至几乎可以忽略。
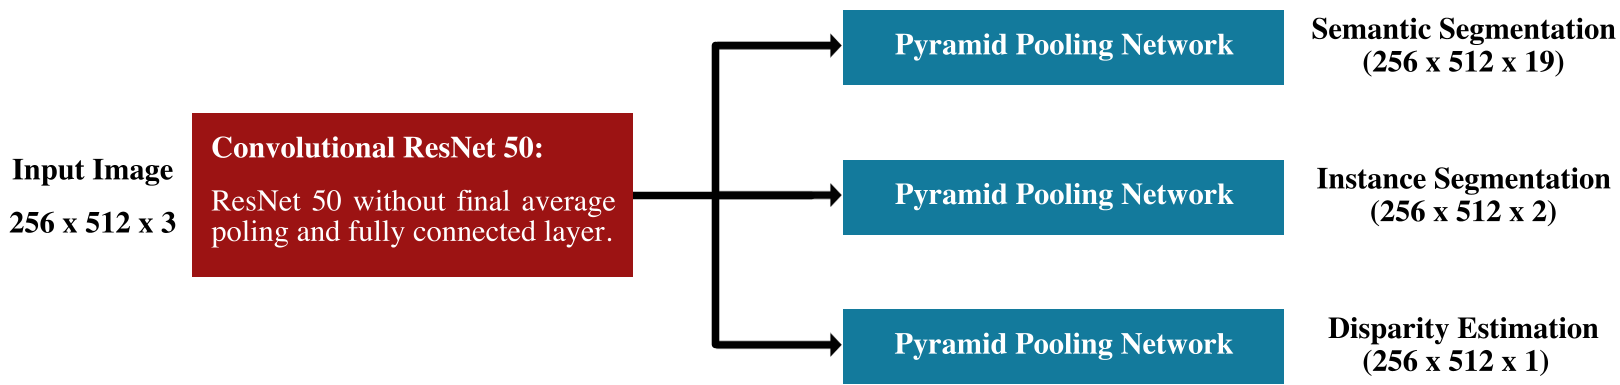 上图展示了典型的 Encoder-Decoder 架构,MGDA-UB 正是在 Encoder 顶部的 Z 层进行梯度冲突协调。
实验战绩
消灭“负迁移”
在 MultiMNIST 实验中(识别重叠数字),传统方法因为两个数字争夺模型容量,准确率总是低于单任务模型。而本文方法(Ours)首次实现了与单任务训练完全持平的性能(如下散点图所示)。
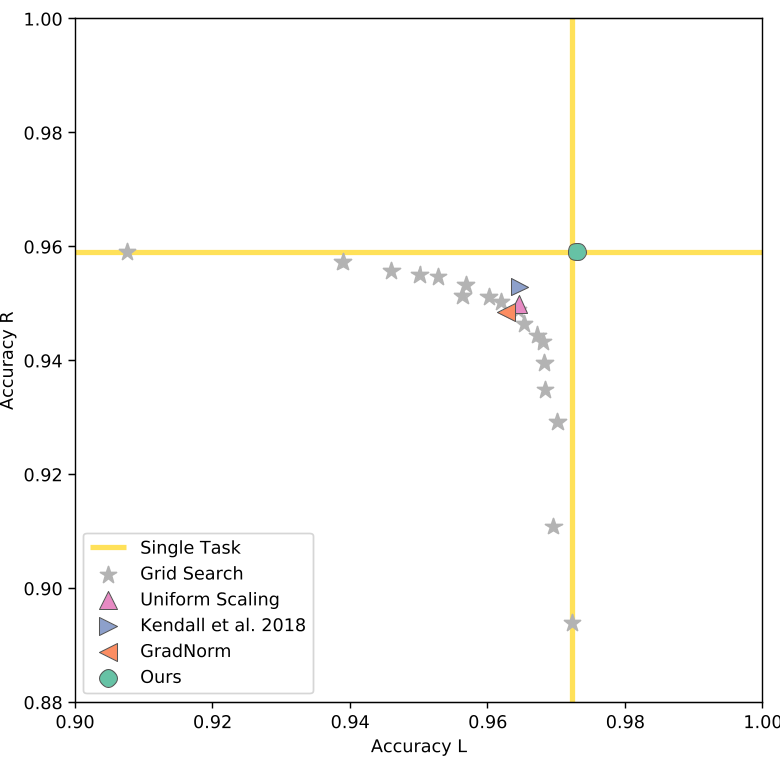 散点图显示:当任务 L 和任务 R 冲突时,只有本文方法(红色点)稳居右上角的最高性能区。
场景理解的全面超越
在 Cityscapes 自动驾驶数据集上(语义分割、实例分割、深度估计),该方法不仅在精度上优于 GradNorm 等知名基线,更由于使用了 UB 近似,训练时间相比不加近似版本缩短了近一半。
深度洞察
该工作最具启发意义的地方在于其对**Inductive Bias(归纳偏置)**的利用。作者不仅从工程上解决了计算效率问题,还从理论上证明了:只要共享表示层的雅可比矩阵是满秩的(即任务间不是线性相关的),这种近似就能保证找到帕累托驻点。
局限性:尽管该方法解决了梯度方向的冲突,但它默认所有任务同等重要。在实际产品中,某些主任务可能需要更高的优先级,如何在帕累托前沿上进行受控的方向偏置,仍是值得探索的方向。
结论
MTL as MOO 的思路正逐渐成为复杂系统优化的主流。如果你正在处理多个具有竞争性的目标(如推荐系统中的点击率与时长、自动驾驶中的多传感器融合),这篇论文提供的 MGDA 框架及其高效实现是不可多得的工业级利器。