
彻底告别辅助模型:通过自蒸馏实现 3 倍速多多标记预测
Multi-Token Prediction via Self-Distillation
本文提出了一种通过“学生自强(Student-Forced)”在线蒸馏实现的多多标记预测(Multi-Token Prediction, MTP)方法。该方法能将标准的自回归语言模型转化为无需辅助验证模型或复杂推理管线的独立多多标记生成模型,在保持高精度的同时显著提升推理速度。
TL;DR
大语言模型的推理速度一直是部署中的瓶颈。传统的加速手段(如投机采样)往往需要额外维护一个“小模型”作为助手。马里兰大学等机构的研究者提出了一种新方案:通过在线自蒸馏(Online Self-Distillation),让模型自己学会一次吐出多个 Token。实验证明,该方法能让 Llama-3.1 等模型在几乎不损失精度的情况下,推理速度直接翻 3 倍。
背景:为什么多多标记预测(MTP)这么难?
在大模型的标准训练中,我们使用次标记预测(Next-Token Prediction, NTP)。如果我们要模型预测接下来的两个词,在离线训练下,模型往往会独立地预测第一个词和第二个词。
这会产生一个经典悖论:假设语料中有“管理员喂熊猫竹子”和“管理员喂狮子肉”。如果多标记预测模型在“管理员喂”之后同时预测后两个词,它可能会给“熊猫”和“狮子”各 50% 概率,给“竹子”和“肉”各 50% 概率。结果模型有可能会输出“管理员喂熊猫肉”——这在联合分布上是完全错误的。
为了解决这个连贯性问题,作者提出:不能只看 Ground Truth,必须看模型生成的 Token 片段在逻辑上是否自洽。
核心方法:学生自强(Student-Forced)在线蒸馏
作者提出的核心公式不再是简单的交叉熵,而是一个强化学习风格的奖励机制:
- 学生生成(Rollout):学生模型通过一次前向传播生成 个 Token(使用 Greedy Search)。
- 教师打分(Critic):使用一个冻结的、更强的教师模型(通常是预训练好的基座本身),根据链式法则计算这 个 Token 序列的联合概率分布。
- 在线反馈:学生模型根据教师模型给出的“硬性奖励”(Hard Teacher Feedback)调整参数,让自己的分布向教师认可的高概率序列靠拢。
架构与掩码设计
为了在训练中并行处理,作者引入了特殊的 <MTP> 掩码 Token 和块状注意力机制(Blocked Attention)。
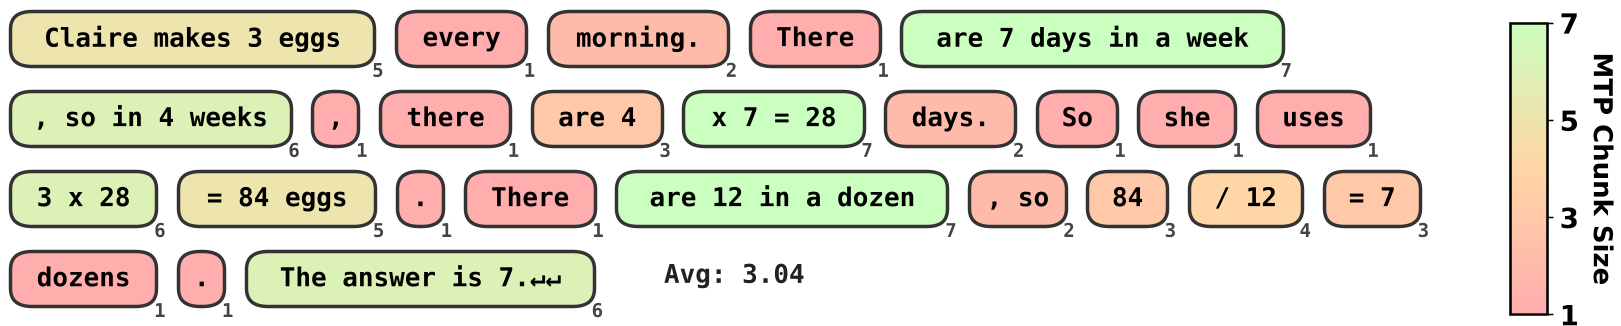 图 1:MTP 模型在 GSM8K 上的推理示例,不同颜色的块代表单次前向传播生成的 Token 簇,平均每步生成 3.04 个 Token。
这种设计的巧妙之处在于:模型在推理时不需要更改任何代码逻辑,只需在 prompt 后面塞进几个 mask tokens,它就能利用学到的权重直接填空。
推理策略:自适应置信度采样(ConfAdapt)
固定每次输出 个 Token 可能会牺牲精度,因为有些词很难猜。作者发现,模型的自信度(熵)与生成质量高度正相关。
因此,他们开发了 ConfAdapt 策略:
- 设置一个阈值 (如 90%)。
- 只有当模型对当前 Token 的预测概率超过 时,才接受这一个 Token 并继续看下一个同时生成的预测。
- 一旦置信度不足,立即截断。
这种“能快则快,该慢则慢”的策略,让模型在数学推理等严谨任务中依然稳健。
实验战绩:3 倍速与极低损耗
研究者在 Llama-3.1-8B 和 Qwen3-4B 上进行了测试。
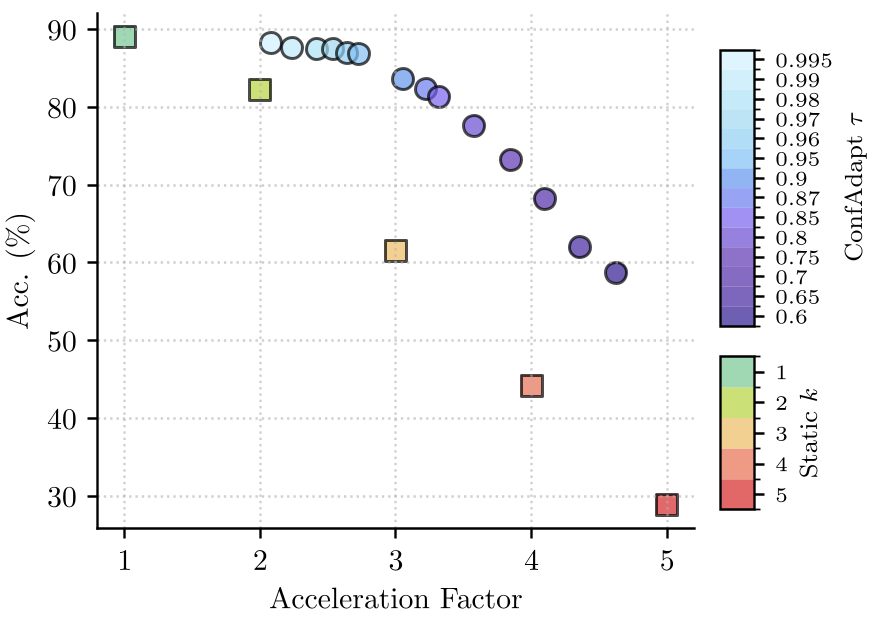 图 2:精度 vs 加速比。ConfAdapt 策略(蓝色/紫色线)明显优于固定 值的 Static 策略。
- 加速比:在 GSM8K 任务上,通过 ConfAdapt 实现了 3.3x 的加速。
- 精度表现:Llama-3.1-8B 的准确率下降不到 3%,在某些配置下甚至能维持原状。
- 吞吐量性能:与目前最强的投机采样加速器 EAGLE-3 相比,该方法在低并发下表现更佳,且系统复杂度极低。
深度洞察
该工作最具启发性的一点在于:推理加速不一定要靠“堆外挂”,也可以靠“修内功”。
传统观点认为,Transformer 并行生成多个 Token 会导致分布偏移,导致模型“发疯”。但本文通过在线策略训练,证明了模型参数有足够的容量去学习如何“一次看多步”。这为未来边缘侧设备的部署提供了一个极其诱人的方向——你只需要换一个权重文件,不需要改任何推理引擎代码,就能获得数倍的加速。
局限性
当然,目前该方法在极其发散的长文本生成(如创意写作)中表现略逊于确定性强的数学逻辑推理。这可能是因为高熵任务中,教师模型的反馈也相对模糊,导致学生模型难以协同。
总结
通过自蒸馏将多多标记预测作为“第一等公民”进行训练,是 LLM 后训练阶段(Post-training)的一个重要里程碑。它打破了传统 NTP 推理的单行线思维,利用模型自身的冗余性换取了宝贵的推理延迟。