
[EMNLP 2024] MultiDocFusion:工业级 RAG 的破局者,深度解析层次化分块的力量
MultiDocFusion: Hierarchical and Multimodal Chunking Pipeline for Enhanced RAG on Long Industrial Documents
本文提出了 MultiDocFusion,一种专为长篇工业文档设计的检索增强生成(RAG)多模态分块流水线。该方法通过结合视觉版面分析、OCR 和基于 LLM 的文档层级解析(DSHP-LLM),实现了在多个工业基准数据集上检索精度提升 8–15%,QA 评分提升 2–3% 的 SOTA 表现。
TL;DR
在处理长篇且复杂的工业文档(如 PDF 扫描件、多页合规报告)时,传统的“暴力分块”往往会导致关键信息支离破碎。MultiDocFusion 提出了一种多模态分块流水线,通过视觉解析和指令微调的 LLM 显式重建文档的“层级骨架”,将检索精度提升了高达 15%。
背景定位:这是 RAG 领域中针对长文档结构化处理的 SOTA 级工作,填补了现有方法在视觉版面与逻辑层级融合方面的空白。
痛点深挖:为什么你的 RAG 在长文档上会失效?
现有方法(如 Length Chunking 或 Semantic Chunking)在处理简单小说或新闻时尚可,但面对工业文档时会面临三大挑战:
- 语义碎片化:传统的固定长度切分会把“1.2.1 节”的内容与其父级“1.2 节”的背景信息强行切断。
- 视觉细节丢失:表格、图片、侧边注释的物理位置蕴含逻辑关系,纯文本解析会丢失这些信号。
- 结构盲目性:PDF 中的标题通常只靠字号区分,OCR 出来的文本流失去了这些层级属性,导致模型检索时“只见森林,不见树木”。
方法论详解:MultiDocFusion 的四步炼金术
MultiDocFusion 的核心逻辑是将视觉(Vision)、**文本(OCR)与逻辑推理(LLM Hierarchy)**进行深度耦合。
1. 架构解析 (Architecture)
整个流水线分为四个精密耦合的步骤,如下图所示:
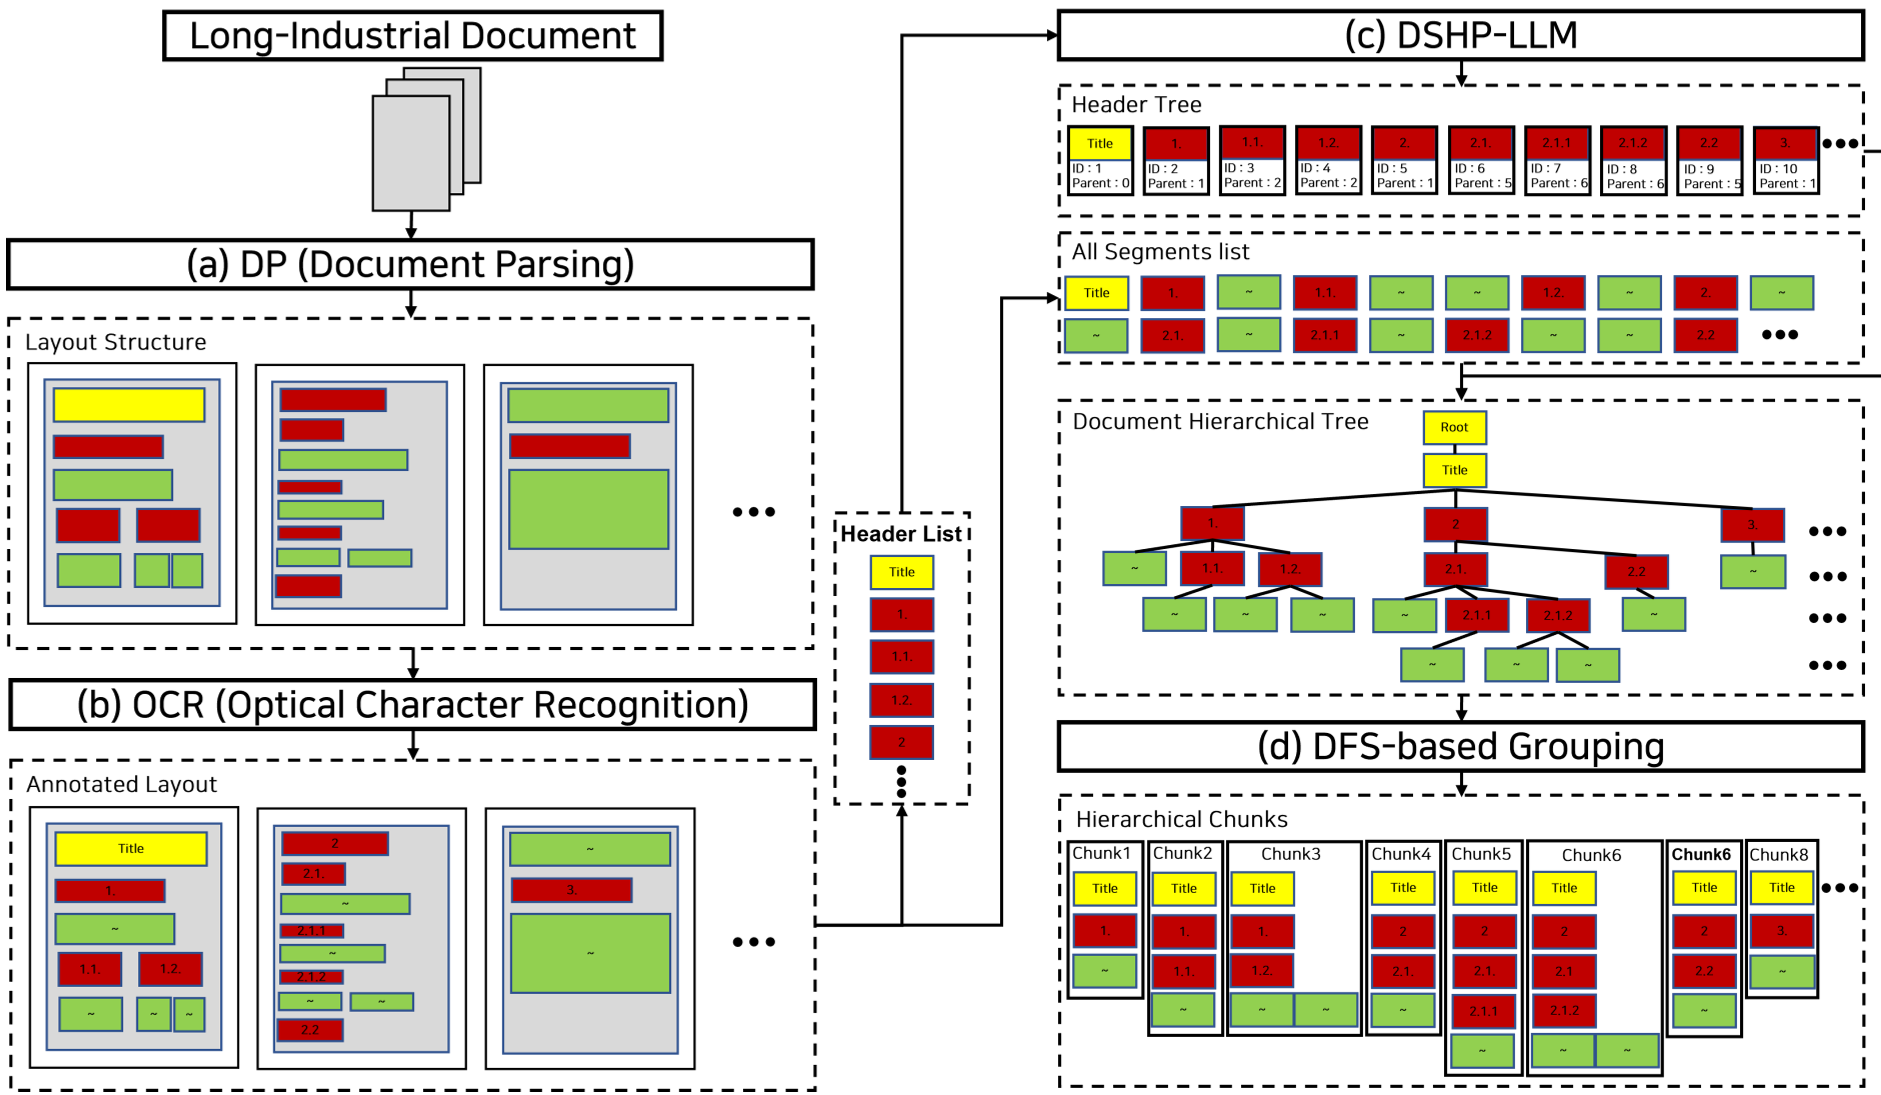
- (a) DP (Document Parsing):利用视觉模型(如 DETR, VGT)识别标题、正文块、表格等视觉区域。
- (b) OCR:精准提取这些特定区域内的文本,减少无关区域的噪音干扰。
- (c) DSHP-LLM:这是本文的“灵魂”。作者微调了一个 LLM(如 Mistral-8B),专门负责根据标题列表判断父子关系。例如,它能识别出“1.1”是“1”的孩子,甚至在缺乏数字编号时也能通过语义判断。
- (d) DFS-based Grouping:利用深度优先搜索(DFS)将父标题信息前缀注入到每一个子分块中,生成类似 Markdown 的结构化 Chunk。
2. DSHP-LLM:让模型学会看“目录”
传统的 GPT-4 在没有微调的情况下解析复杂层级的能力有限。作者通过在 DocHieNet 和 HRDH 数据集上进行指令微调(Instruction Tuning),使 DSHP-LLM 在层级解析指标 TEDS 上远超通用模型。
实验与结果:全线碾压的实战表现
核心战绩
在针对法律合同的 CUAD 和金融报告的 DUDE 数据集上,MultiDocFusion 展现了统治级表现:
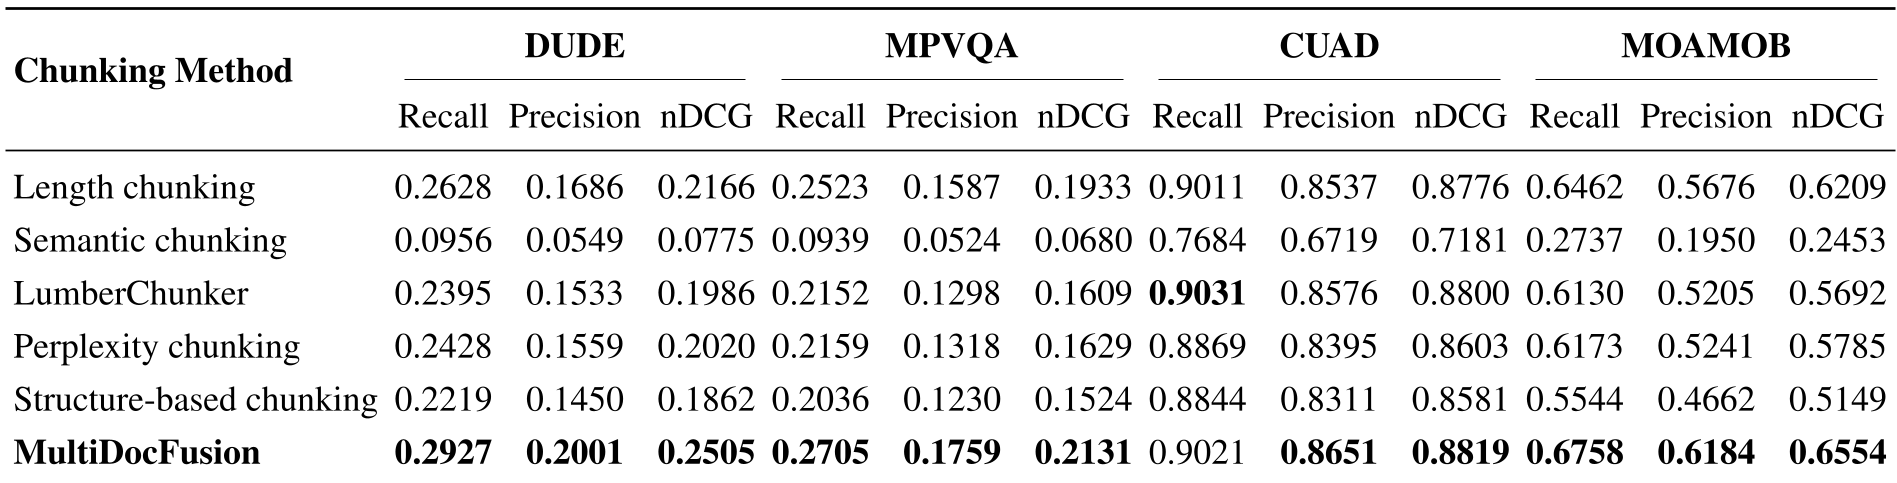
- Precision (精度):在多数据集上相比基线提升 8-15%。
- QA 质量 (ANLS):通过给模型提供具备“结构背景”的 Chunk,问答准确度提升显著。
鲁棒性分析
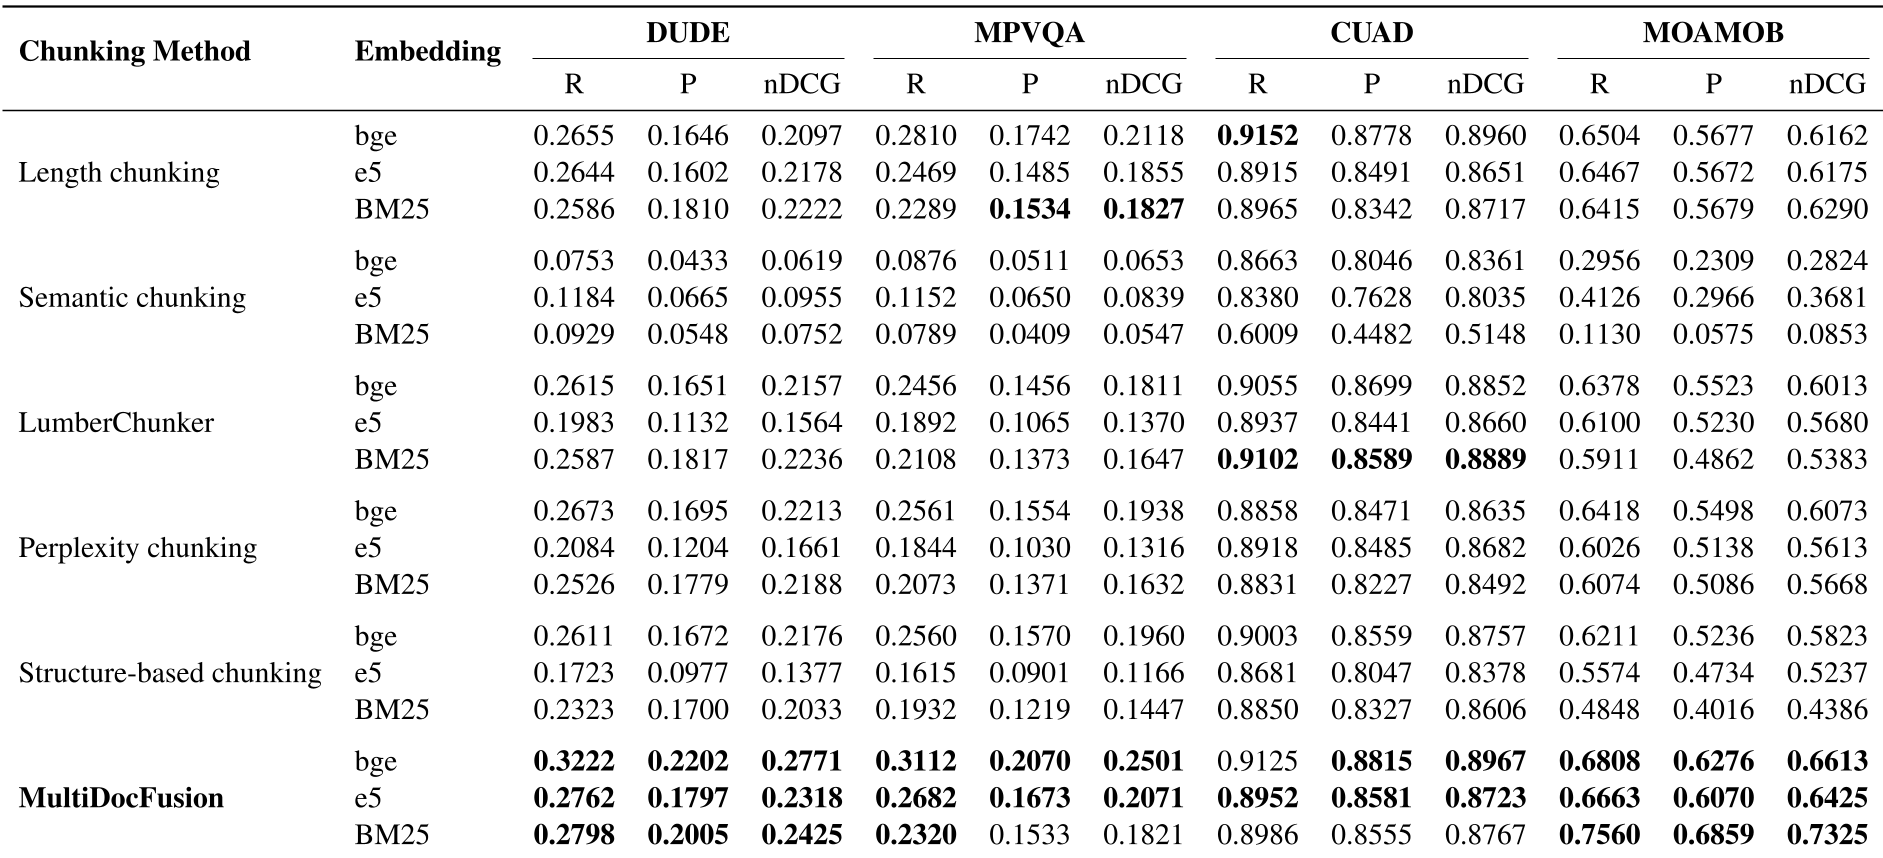
值得注意的是,无论后端使用什么 Embedding 模型(BGE, E5, BM25),MultiDocFusion 的表现始终优于传统方法。这意味着其优势来源于分块的质量而非后续检索器的调优。
深度洞察:为什么这很重要?
- Context Injection 的直觉:该方法本质上是在分块阶段就进行了“上下文预处理”。既然检索是寻找最相关的块,那么让每个块都自带“身份证明”(父级标题信息),自然能显著降低检索时的歧义。
- 结构化是未来:随着长上下文 LLM 的普及,挑战不再是“塞不塞得下”,而是“如何检索得准”。MultiDocFusion 证明了视觉与逻辑结构的融合是解决这一问题的钥匙。
局限性与风险
- 计算开销:由于在子块中重复了父块信息,索引体积会有所增加。
- 误差传递:若第一阶段的视觉解析(DP)出错,会影响后续所有阶段。
总结 (Conclusion)
MultiDocFusion 为长文档 RAG 提供了一个极其务实且高效的工业级范式:先视觉解析,再逻辑建树,最后层级分块。对于正在开发企业级知识库、财务审计或法律研究工具的开发者来说,这种“结构感知”的思维方式极具借鉴价值。