
MIRAGE:视网膜影像基础模型的“真”多模态突破
Multimodal foundation model and benchmark for comprehensive retinal OCT image analysis
本文推出了 MIRAGE,这是首个针对三维光学相干断层扫描(OCT)和扫描激光眼底镜(SLO)图像深度分析的多模态基础模型(Foundation Model)。该模型采用多模态掩码自编码器(MultiMAE)预训练架构,在包含 19 个任务的广泛基准测试中,其分类和分割性能多项指标达到了 SOTA 水平。
TL;DR
眼科 AI 正在经历从“专用模型”到“基础模型”的代际更迭。维也纳医科大学的研究团队推出的 MIRAGE,通过配对的 OCT(断层扫描)与 SLO(平面扫描)数据进行多模态掩码自编码预训练,一举打破了单模态基础模型的局限。MIRAGE 不仅在疾病分类上刷写了 SOTA,更在分割任务——这个传统基础模型的弱点上,展示了统治级的泛化能力。
核心速览
- 地位:首个真正基于配对多模态视网膜影像的通用基础模型。
- 突破:解决了基础模型在分割任务(Segmentation)中表现乏力的顽疾,平均 Dice 分数大幅领先通用模型 DINOv2 和医疗专用模型 MedSAM。
- 架构:基于 Vision Transformer (ViT),支持 Linear Probing (线性探测) 实现极低成本的任务迁移。
动机与直觉:为什么要搞“多模态配对”?
在临床实践中,医生看病从来不只看一张图。OCT 提供视网膜的 3D 横切面(看层间病变),而 SLO 提供 2D 的俯视图(看病灶分布)。
现有的所谓“多模态”模型存在两大硬伤:
- “动物园式”模型:虽然号称支持多种模态,但实际上每种模态都有独立的编码器(Encoder),它们之间并不“沟通”。
- 忽略空间对齐:许多模型只是把不同模态丢进大池子乱炖,完全浪费了“同一只眼、同一瞬间、两种视角”提供的物理一致性约束。
MIRAGE 的直觉(Insight):如果让模型在预训练阶段就练习“根据受损的 OCT 片段去还原对应的 SLO 细节,并预测其解剖分层”,模型就能被迫理解视网膜的深层物理结构,而非仅仅学习像素级的统计特征。
架构解析:MultiMAE 与解剖伪标签的化学反应
MIRAGE 的训练流程堪称优雅。它利用了 MultiMAE 架构,将输入的 OCT、SLO 以及由算法生成的视网膜层伪标签(Layers)全部打碎成 Patch,并进行极高比例的掩码遮盖(Masking)。
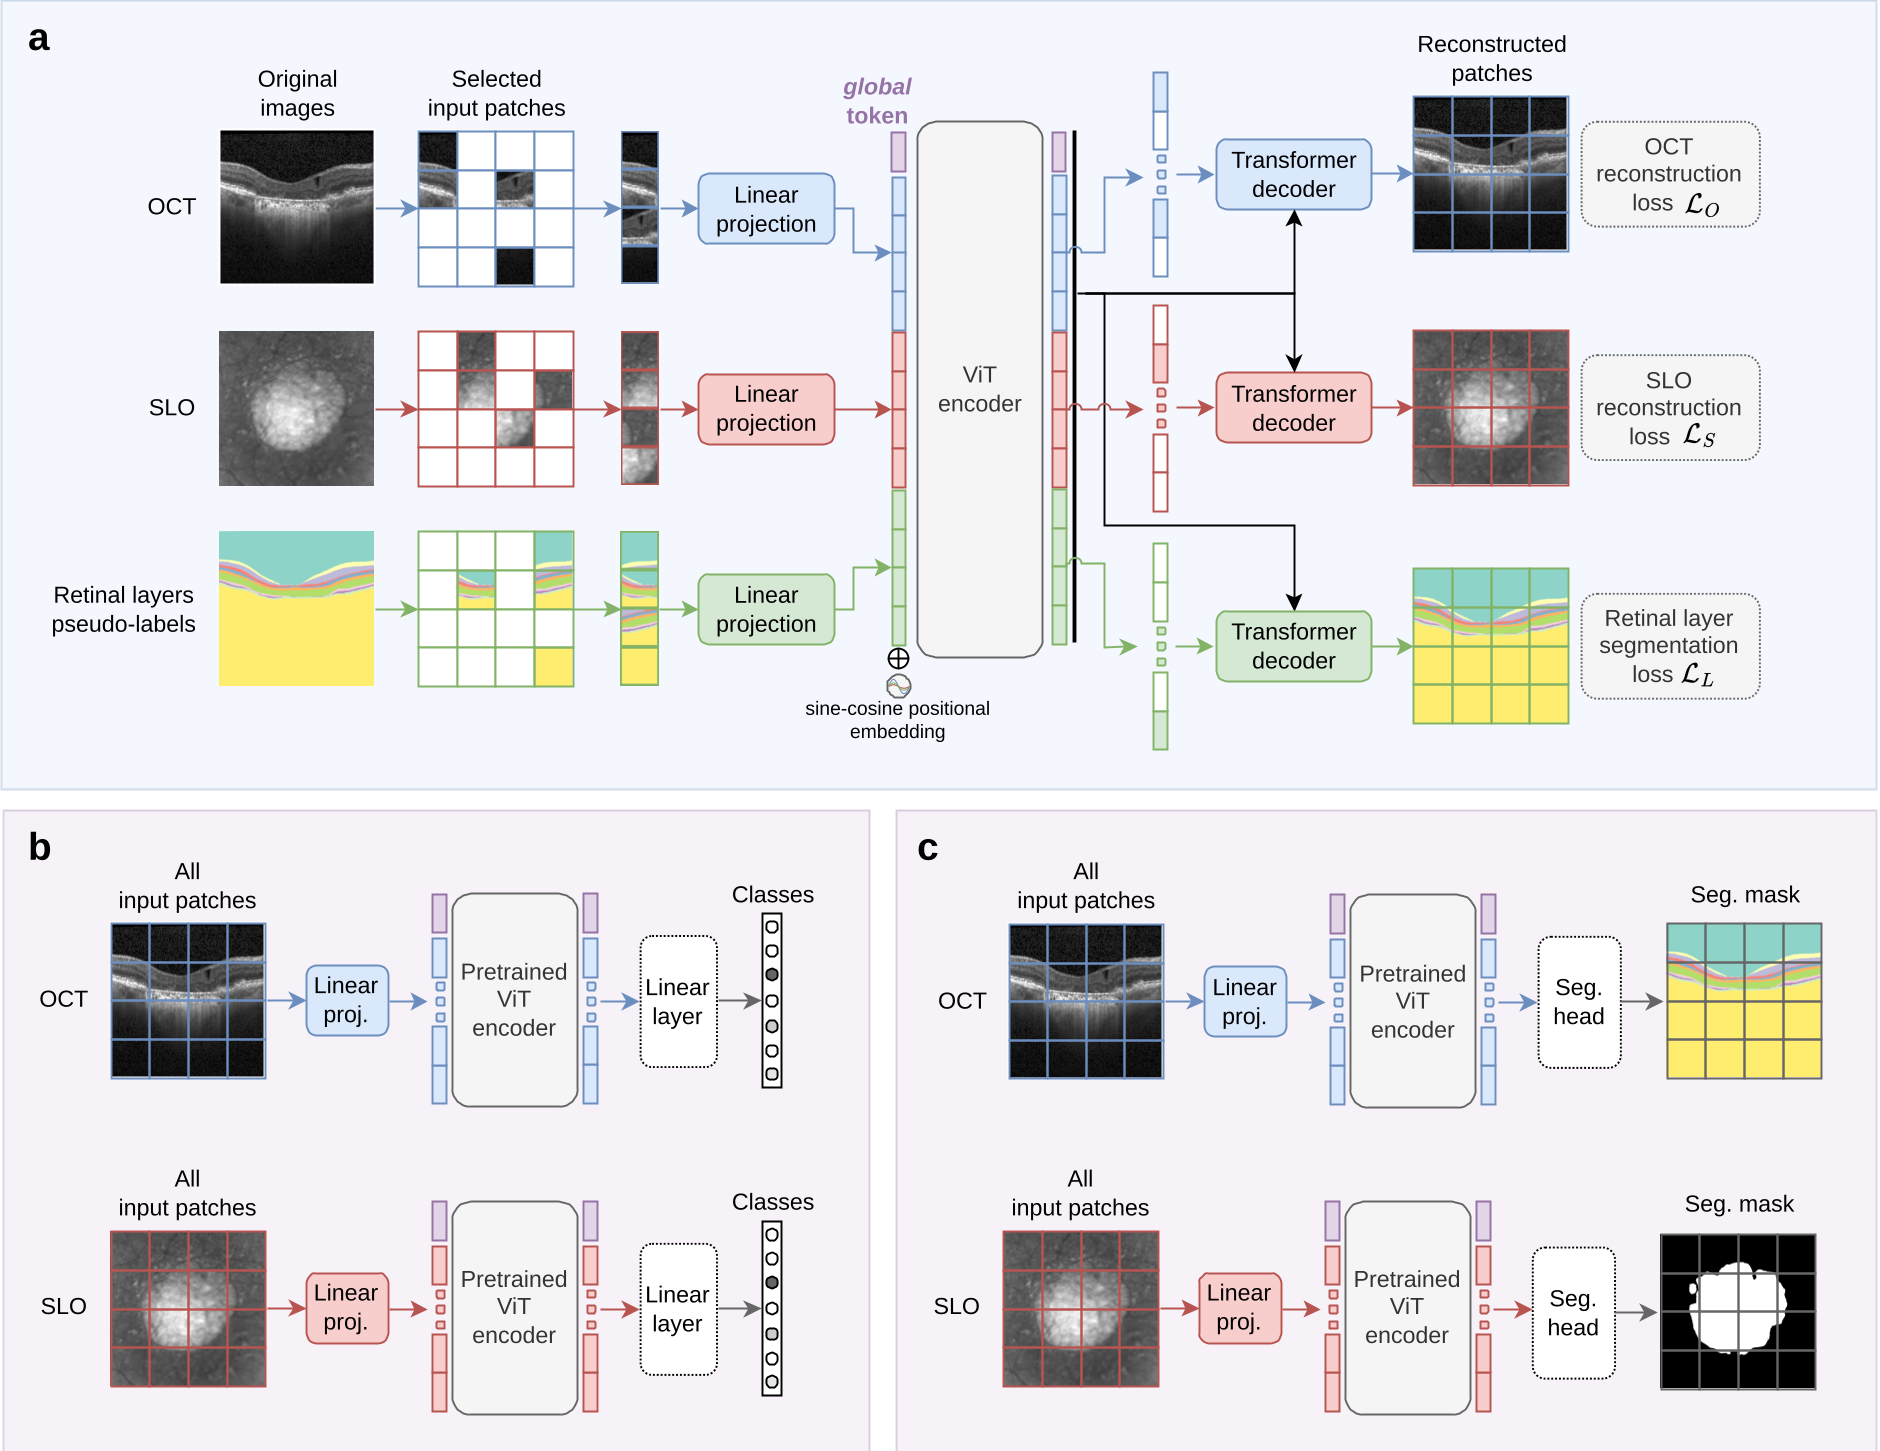 图 1:MIRAGE 预训练流程。解码器通过交叉注意力机制(Cross-Attention)从可见的 Patch 中重构三种模态。
关键技术点:
- 解剖引导 (Anatomy-guided):通过引入视网膜解剖层伪标签,模型在预训练阶段就具备了“解剖常识”。
- 共享编码器 (Shared Encoder):无论推理时输入的是 OCT 还是 SLO,都走同一个 ViT 编码器,实现特征空间的真正融合。
实验战绩:全能选手的压制力
研究者在包含 16 个数据集、19 个任务的超级基准上进行了测试,涵盖了从黄斑变性 (AMD) 诊断到复杂的视网膜病灶分割。
1. 诊断任务:不仅是准,而且更稳
在 11 个分类数据集上,MIRAGE 的平均 AUROC 达到 95.59%。特别是在小样本和跨设备场景下,MIRAGE 展示了极强的泛化能力。在 Duke iAMD 数据集上,其精度接近完美(99.52%)。
2. 分割任务:降维打击
这是 MIRAGE 最惊人的表现。传统的分割霸主如 nnU-Net 虽然在单一数据集上很强,但遇到“跨数据集”(换了医院的产品或设备)就表现崩盘。
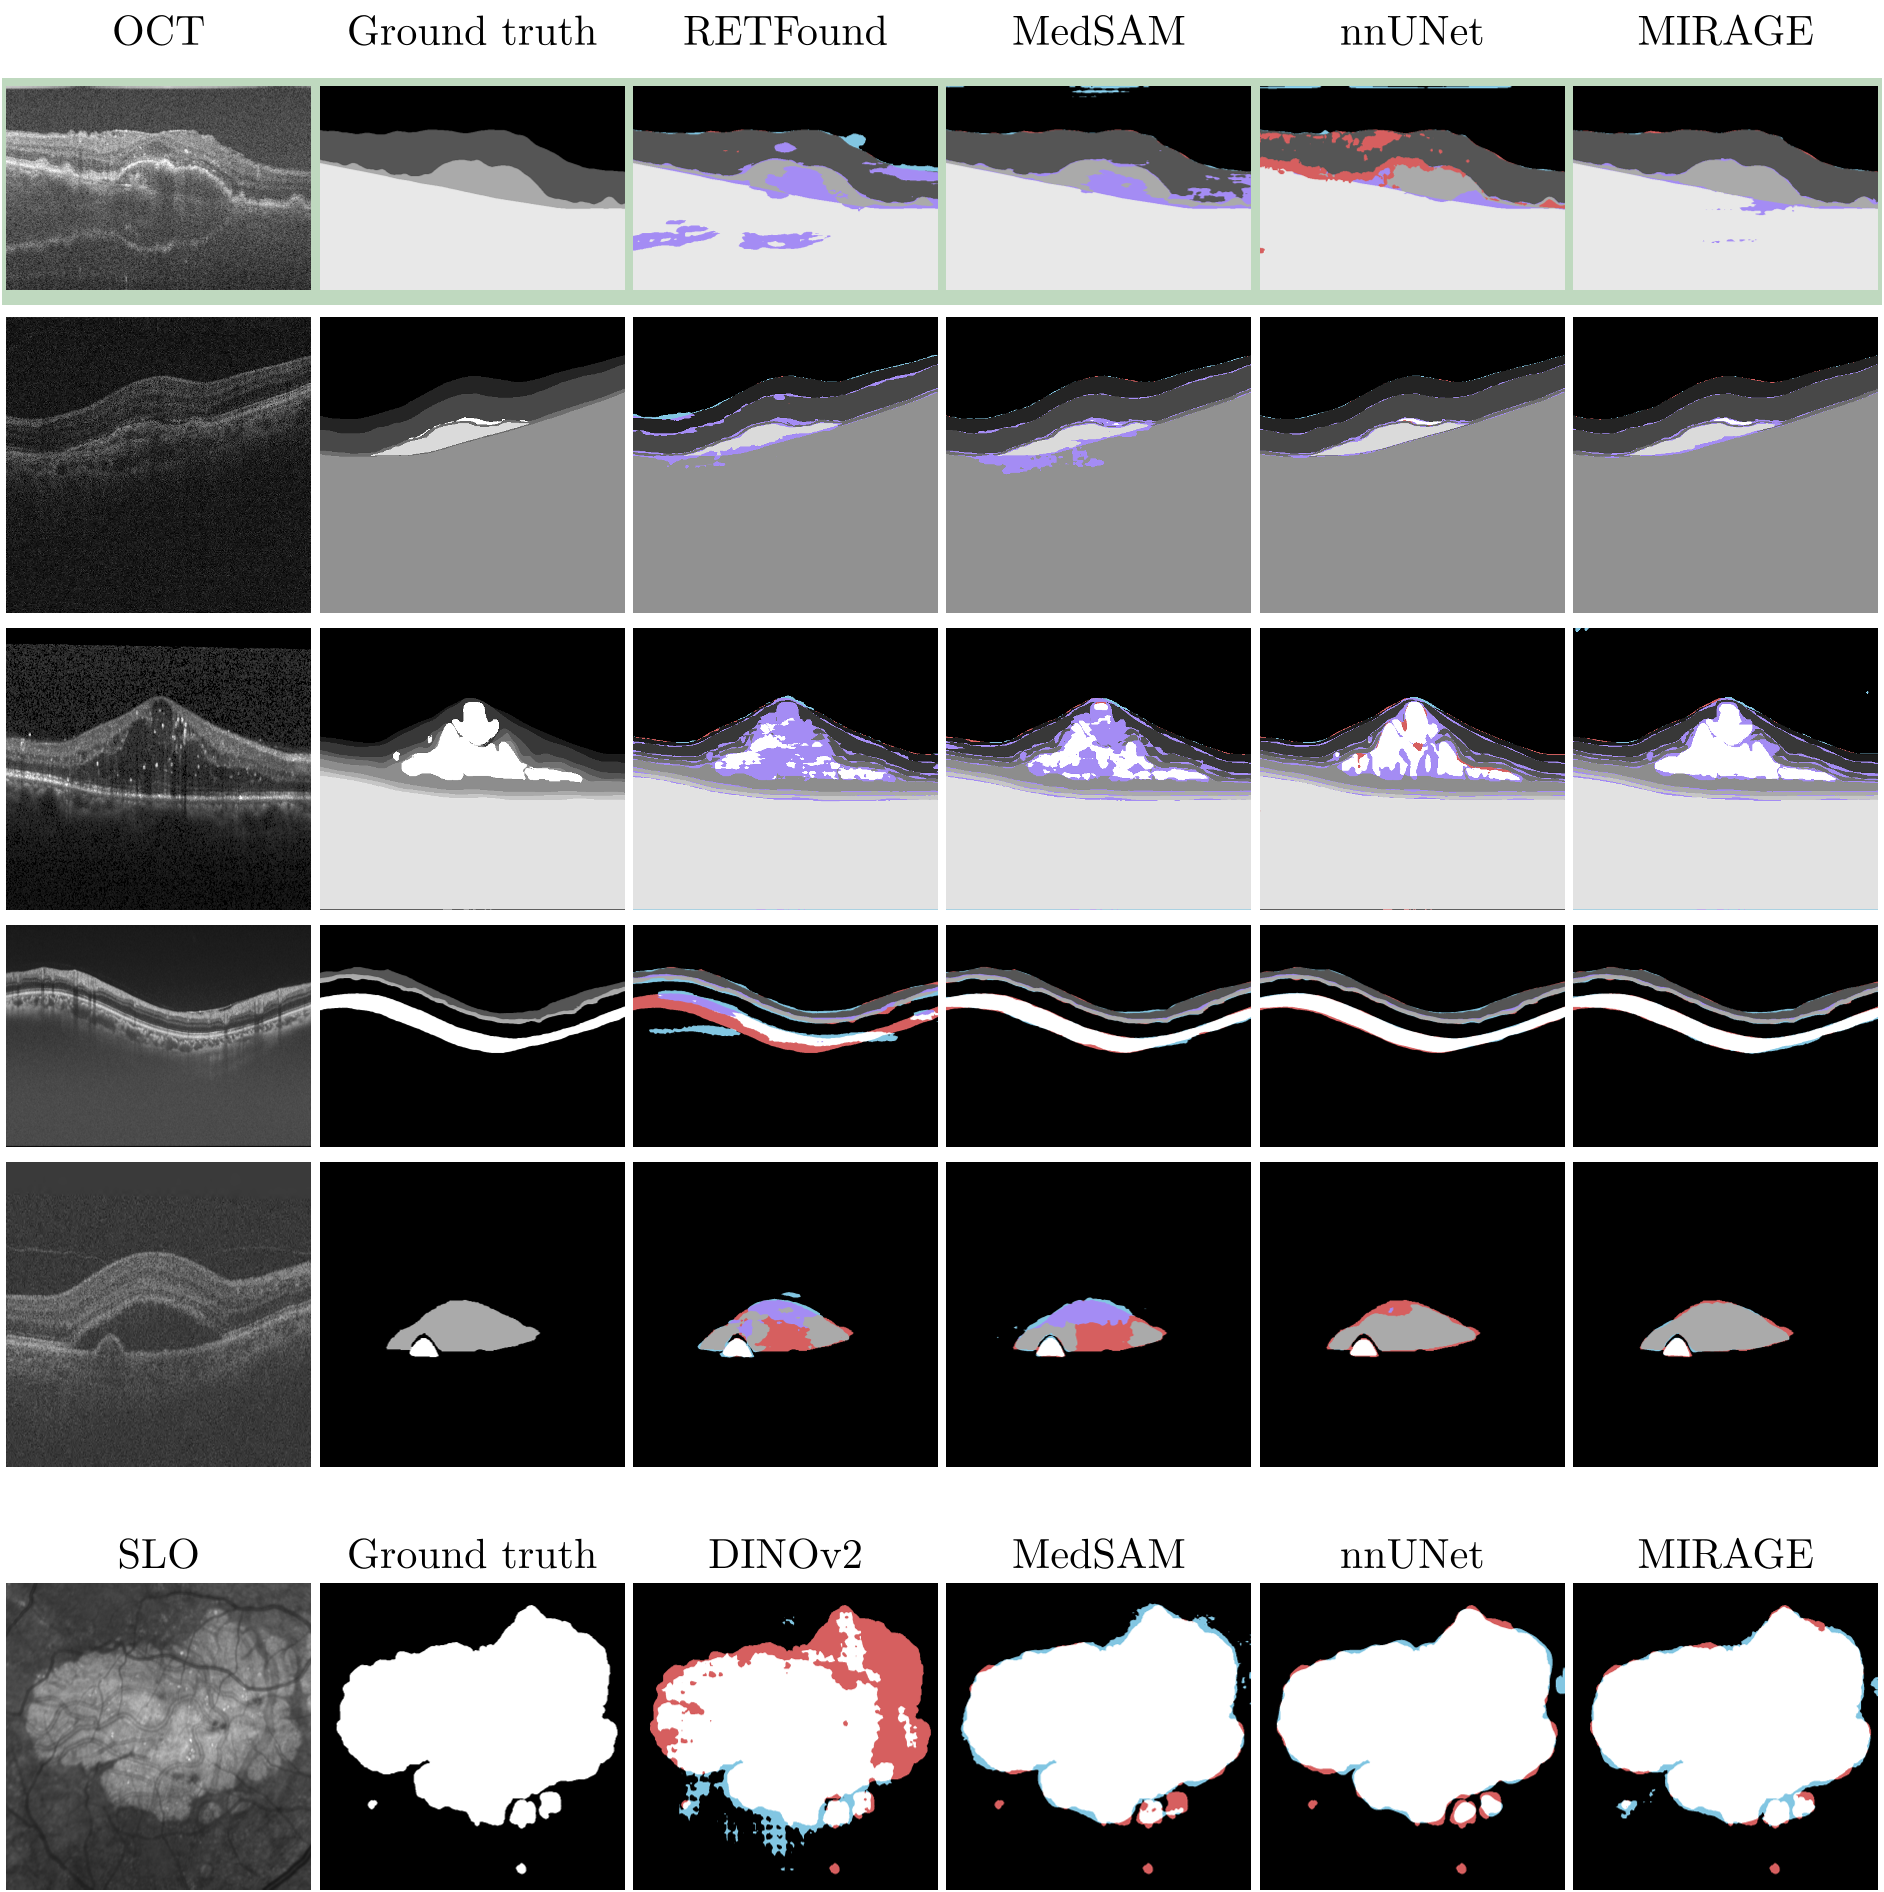 图 2:分割效果对比。第一行(绿色背景)展示了在“跨数据集”任务中,MIRAGE 能精确还原解剖层,而 nnU-Net 和 RETFound 则出现了严重的解剖逻辑错误。
在对比中,MIRAGE 的跨数据集 Dice 分数达到 91.06%,而曾经被寄予厚望的 MedSAM 仅为 75.77%,nnU-Net 甚至低至 61.21%——这证明了 基础模型在吸收海量未标注数据后,产生的 Inductive Bias(归纳偏置)远比单纯靠全监督微调更具通用性。
深度洞察与总结
MIRAGE 的成功揭示了医疗 AI 未来发展的几个趋势:
- 配对数据的魔力:非配对的单一模态堆砌不再是王道。医疗影像中天然存在的配对(如 CT-PET, OCT-SLO)蕴含着物理法则,是训练通用编码器的金矿。
- 伪标签(Pseudo-labeling)的复兴:利用传统算法(如基于图论的分割)生成的“不完美标签”作为预训练的辅助信号,能显著加速模型对解剖结构的理解。
- 计算效率的平衡:研究表明,尽管 ViT-Large 效果更好,但 MIRAGE-Base 版本在保持高性能的同时,推理开销大幅降低,更适合在医疗终端设备部署。
局限性:目前模型主要处理 2D 中央切片,如何将这种多模态优势延伸到完整的 3D OCT 体数据,并引入彩色底照(CFP)等更多维度的配对信息,将是下一步的重点。
结论:MIRAGE 不仅仅是一个更好的视网膜影像识别工具,它为构建“数字眼科医生”通向更复杂推理任务(如 Vision-Language 结合,看图写诊断报告)打下了坚实的底层特征空间。