
MIMRL:基于互信息的解耦学习,发掘多模态情感分析中的“互补”密码
Multimodal Sentiment Analysis With Mutual Information-Based Disentangled Representation Learning
本文提出了 MIMRL,一个基于互信息(Mutual Information, MI)的解耦多模态表示学习框架。该框架通过定量分析将多模态特征细分为模态不变(Invariant)、模态特定(Specific)和模态互补(Complementary)信息,并在 CMU-MOSI 和 CMU-MOSEI 等四个主流情感分析与抑郁检测基准上达到了 SOTA 性能。
TL;DR
在多模态情感分析(MSA)领域,如何平衡文本、语音和视觉三大信号一直是核心难题。本文提出了 MIMRL (Mutual Information-based Disentangled Multimodal Representation Learning) 框架,首次利用互信息(MI)及其变体(CMI),在特征提取阶段精确“解耦”并定量调节模态间的不变性、特定性与互补性。实验证明,该方法在多个数据集上刷新了 SOTA,并深刻揭示了不同任务中各模态信息的贡献占比。
1. 痛点:为什么“对齐”和“融合”还不够?
传统的多模态模型通常关注于:
- 模态对齐(Alignment):试图找到不同模态见的共同点(Invariant)。
- 简单拼接(Fusion):通过 Attention 或 Tensor Fusion 将特征堆叠。
但作者指出,现有的方法存在两个致命缺失:
- 忽视了“互补性”(Complementarity):有些预测信号(如讽刺语境)单靠文字或单靠语调都无法判断,只有二者结合产生的“化学反应”才是关键。
- 缺乏定量控制:我们知道模态特定特征(Specific)很重要,但由于缺乏量化手段,无法根据任务(如 BERT vs. GloVe 特征)动态调整这些成分的权重。
2. 核心机制:三位一体的信息解耦
MIMRL 的核心在于将特征提取阶段的目标函数精细化。它不仅提取特征,还通过互信息估算器确保每种信息“各司其职”:
- Modality-Invariant (MI):通过计算 提取跨模态的共性语义。
- Modality-Specific (MS):利用条件互信息(CMI)剔除冗余,保留各模态独特的贡献。
- Modality-Complementary (MC):捕捉两个或多个模态结合后产生的、独立模态不具备的预测能力。
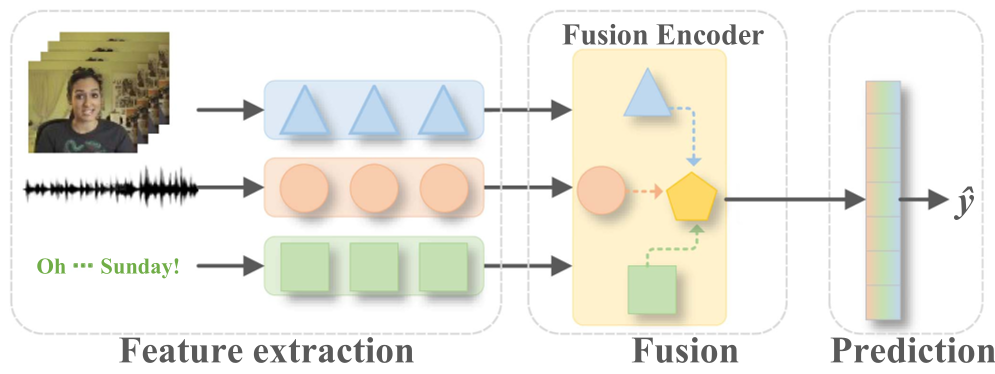 图 1:MIMRL 整体框架,展示了从特征提取到基于 MI 的双阶段优化流程。
为了实现高效计算,作者采用了 NWJ (Nguyen-Wainwright-Jordan) 变分下界 来估计高维向量间的互补信息。
3. 实验发现:BERT 改变了游戏规则
在实验中,作者获得了一个非常有洞察力的结论:当使用不同级别的特征提取器时,最佳的信息配比会发生剧变。
- GloVe 时代:模态不变信息(Invariant)和互补信息(Complementary)占据主导。
- BERT 时代:由于预训练大模型的强大捕捉力,文本特定的信息(Text-Specific)占比飙升至 50% 以上,而模态间的共性(Invariant)反而变得不那么重要了。
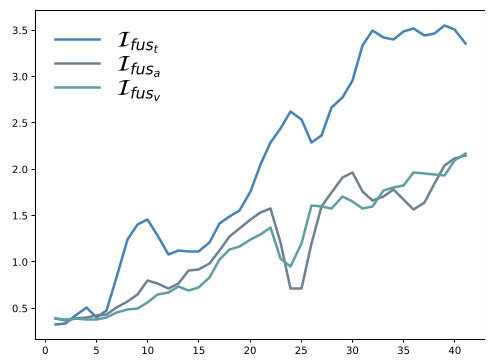 图 2:不同特征(G: GloVe, B: BERT)下,三类信息的分布占比可视化。
4. 关键战绩:全线 SOTA
MIMRL 在 CMU-MOSI 和 CMU-MOSEI 上表现卓越。值得注意的是,该框架具有极强的可插拔性:无论是底层的融合器换成 TFN、MulT 还是最新的 CubeMLP,加入 MIMRL 的信息约束后,性能均能得到显著提升。
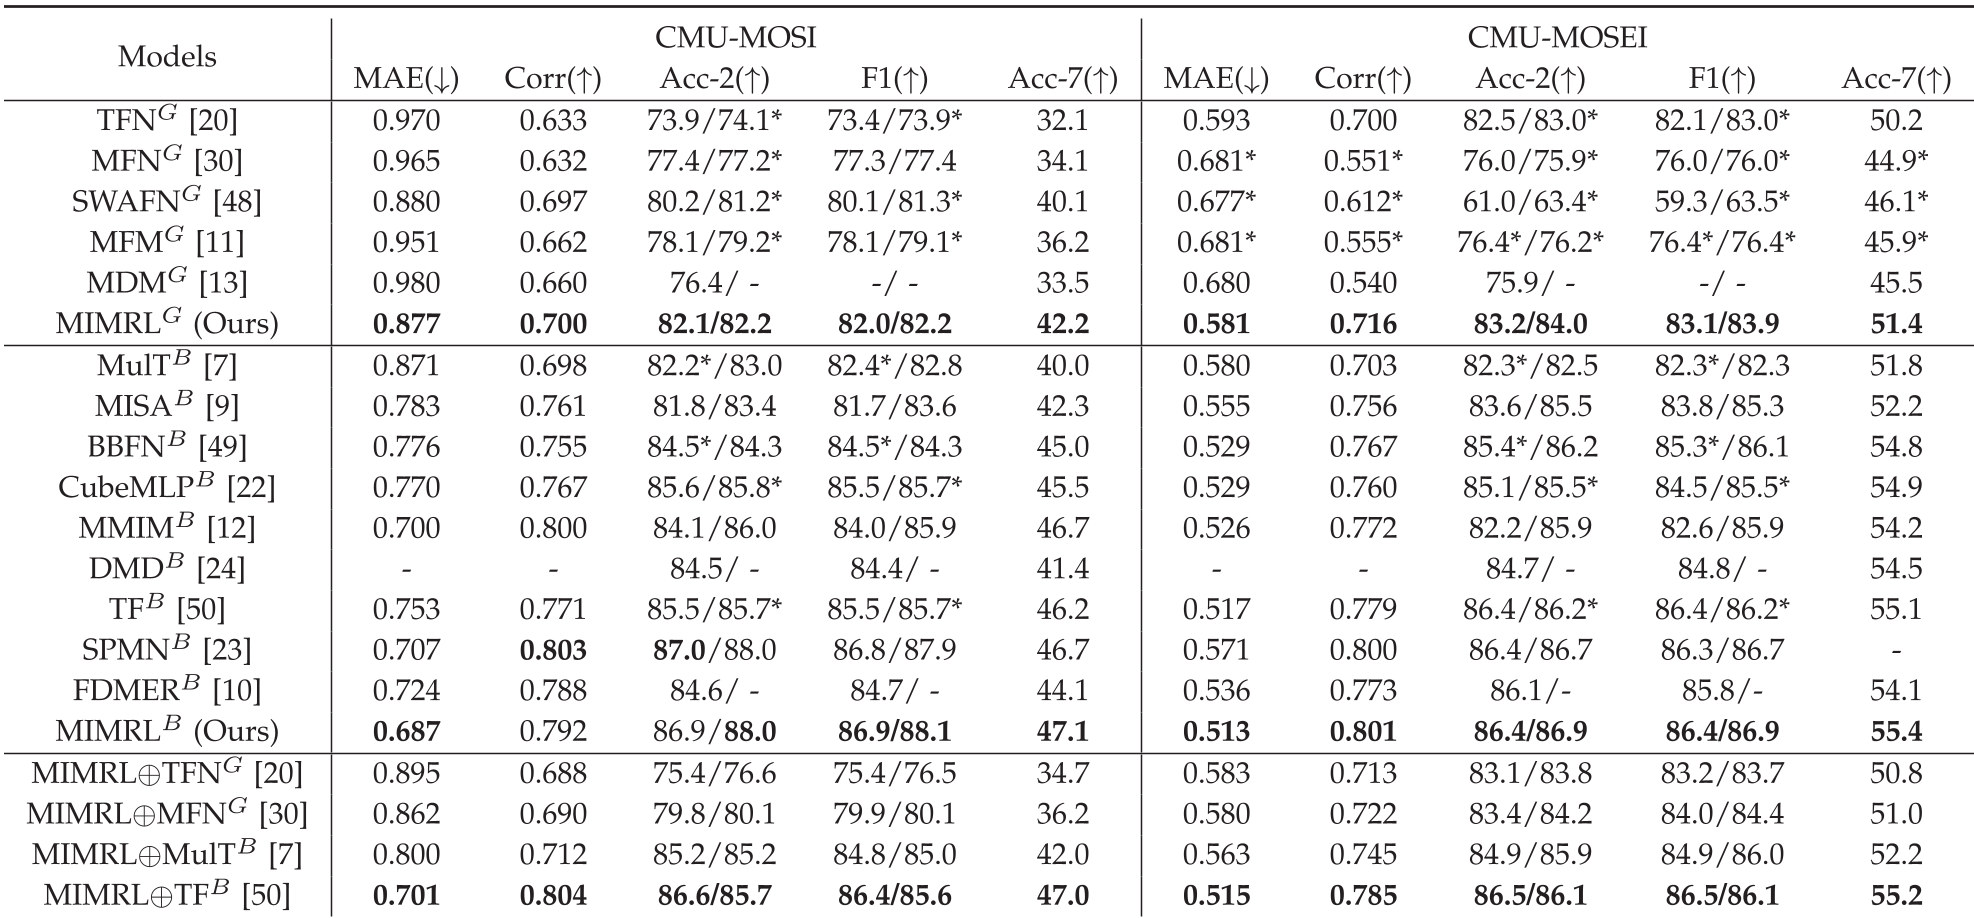 表 1:在 CMU-MOSI/MOSEI 数据集上,MIMRL 与各基线模型的性能对比。
5. 深度洞察与总结
MIMRL 的成功说明了:多模态融合不应仅仅是特征的几何变换,更应当是信息量的动态博弈。
- 局限性:目前的超参数()仍需手动调优以寻找最佳占比,这在工业级的大规模应用中可能存在效率瓶颈。
- 未来启示:这一解耦思路可以自然延伸到多模态大模型(LMM)的训练中。通过显式地约束不同模态生成的“信息量”,或许能有效缓解多模态模型中常见的“模态塌缩(Modality Collapse)”现象。
这项研究为我们提供了一个清晰的视角:在追求更强的 Backbone 之外,回归信息论本质,精细化管理多源信号,依然是通往强人工智能的重要蹊径。