
MatterChat:当原子图遇到大模型,开启材料发现的多模态新纪元
nature machine intelligence Article
本文推出了 MatterChat,一种面向无机材料科学的多模态大语言模型(LLM)。该模型通过轻量级的 Bridging Module 成功将预训练的材料原子图编码器(如 CHGNet, MACE)与 Mistral-7B 对齐,在材料属性预测和科学推理任务中达到 SOTA 水平。
TL;DR
本文介绍了一种名为 MatterChat 的多模态大语言模型,它将复杂的材料原子结构(Graph)与强大的语言交互能力(LLM)完美融合。通过一种巧妙的“桥接”机制,它不仅在材料属性预测精度上超越了 GPT-4,还能像领域专家一样提供合成路径建议和物理原理解释。
1. 背景:文本无法承载的原子之美
在传统的 AI + Materials 领域,存在两个长期平行的方向:
- 物理学霸型(GNN):利用图神经网络直接学习晶体结构,预测 formation energy 等属性极准,但“不解人意”,无法进行复杂的逻辑对话。
- 博学杂家型(LLM):通过文本(CIF, SMILES)学习材料知识,能聊天能检索,但因为缺乏对 3D 空间几何和对称性的直觉,在定量计算上往往“一本正经地胡说八道”。
MatterChat 的出现正是为了打破这道墙。作者认为,材料的物理本质隐藏在原子间的 3D 拓扑关系中,这必须通过专门的物理编码器来捕捉。
2. 核心架构:构建物理与语言的“翻译官”
MatterChat 的精妙之处在于它没有“重造轮子”,而是采用了模块化架构(Modular Framework):
- 感知层(Material Encoder):使用冻结的 CHGNet 或 MACE,它们是材料界的“眼”,负责把复杂的原子坐标和化学键转化为原子嵌入。
- 大脑层(LLM Branch):使用冻结的 Mistral-7B,它负责逻辑推理和语言生成。
- 桥梁层(Bridge Model):这是本文的核心原创点。受 BLIP-2 启发,作者设计了一个包含 32 个可学习 Query 的 Transformer。
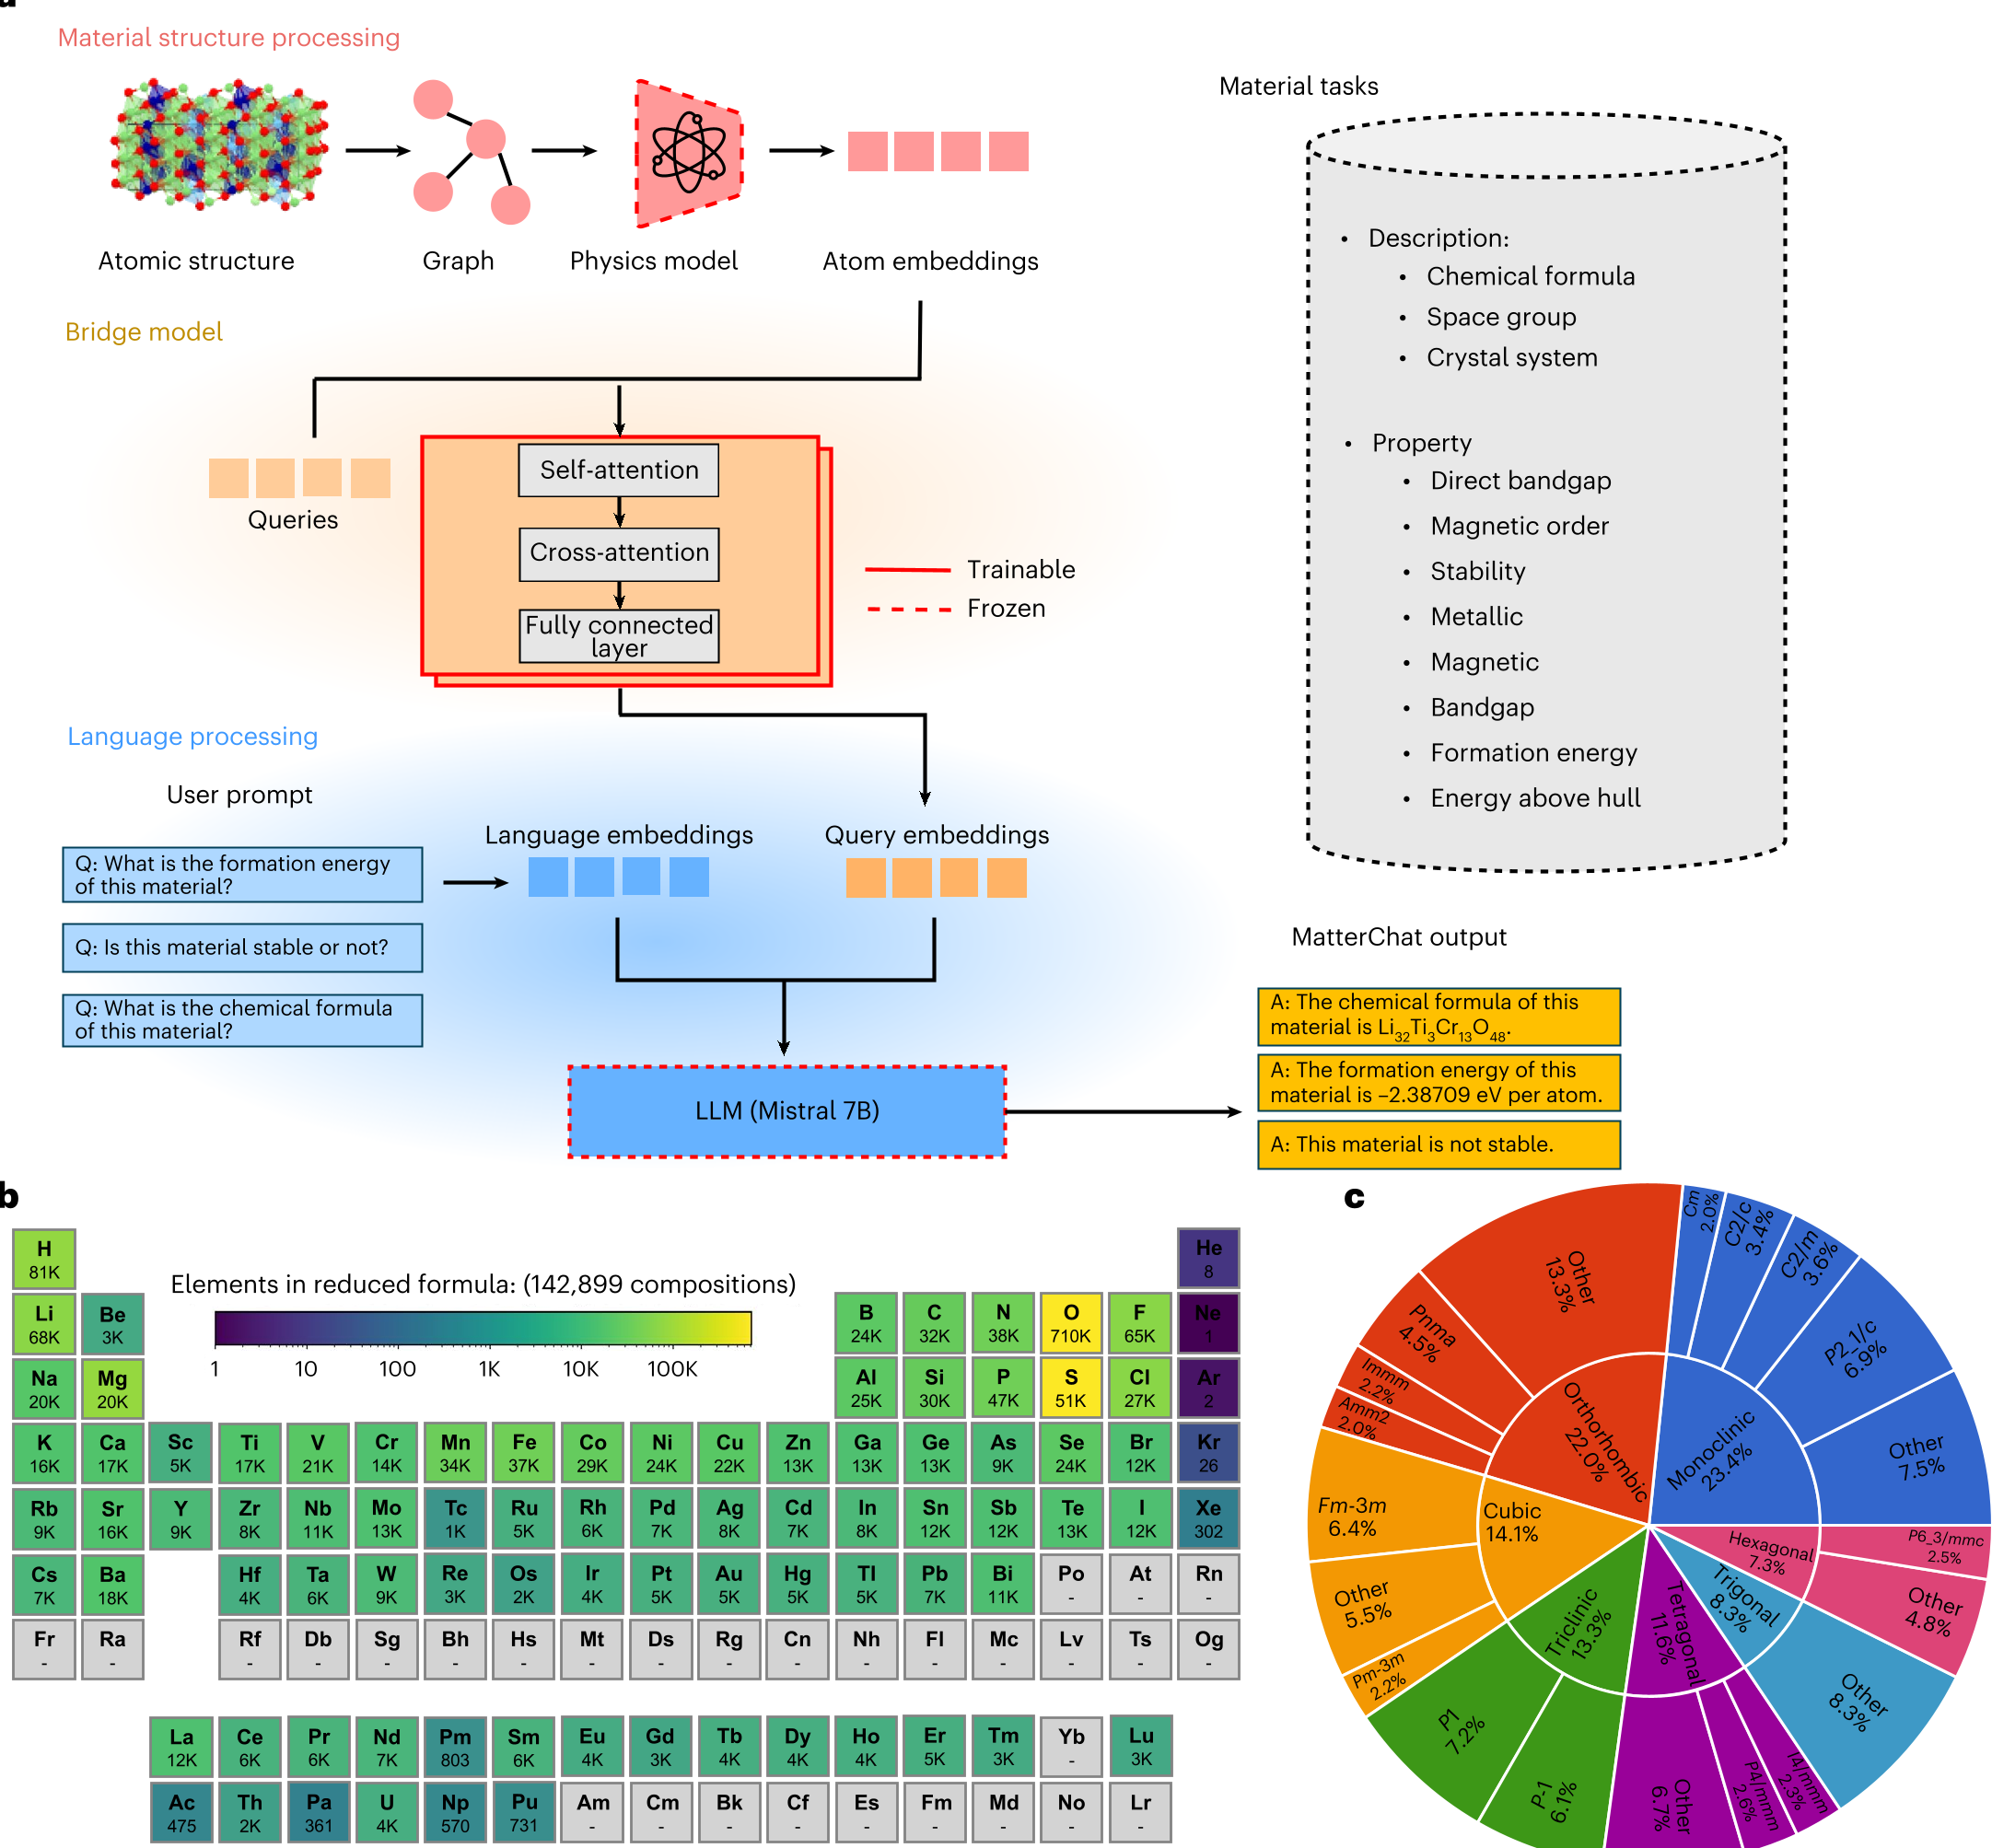
为什么这么做有效? Bridge Model 通过 Cross-attention 机制,从数千个原子节点中抽取出 32 个最具有“语义价值”的特征向量,将高度抽象的物理张量“翻译”成了 LLM 能听懂的指令嵌入(Embeddings)。
3. 实验战绩:不仅仅是准确,更是专业
在 12 项材料科学任务的惨烈竞争中(包含 3 项描述任务和 9 项属性预测任务),MatterChat 展现了统治力:
- 精准度提升:在稳定性、磁性、金属性等分类任务中,准确率显著优于专门的物理模型。
- 零样本迁移:在从未使用过的 GNoME 外部数据集中,MatterChat 依然能保持极低的 RMSE(回归均方根误差),这说明它真实理解了结构与性能的对应关系。
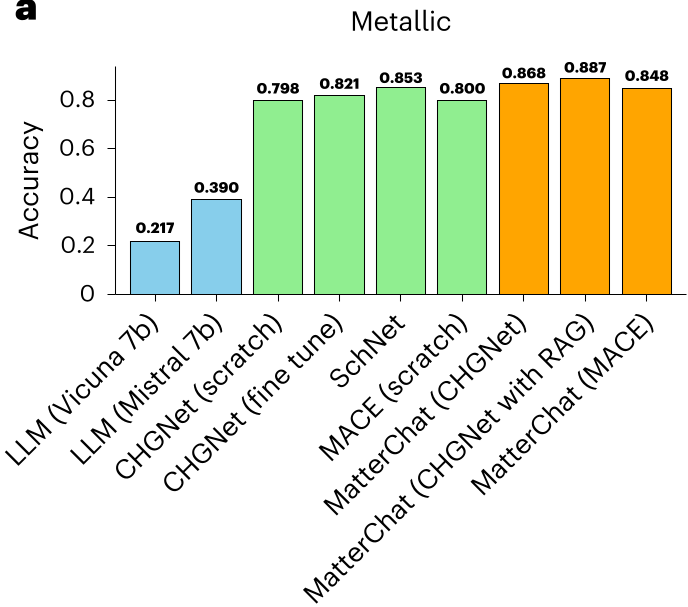
更令人惊艳的是其多模态 RAG(检索增强生成)能力。通过计算查询材料与数据库中已知材料的相似性,模型能进一步修正自己的预测,在保持推理速度(约 1.6 秒/样本)的同时,将回归误差降低了 12%。
4. 深度洞察:模型真的“懂”物理吗?
为了验证模型内部是否真的建立了物理直觉,作者进行了 UMAP 可视化分析 和 注意力热力图 观察:
- 聚类一致性:在嵌入空间中,结构相似的材料(如石墨 vs 金刚石)被清晰地分开,且聚类趋势与“形成能”高度正相关。
- 注意力分配:当模型判断一个材料是否“稳定”时,特定的 Query 向量会被高度激活。这意味着模型已经学会了将特定的原子排列模式映射到热力学稳定性这一物理概念上。
5. 局限与未来
尽管 MatterChat 在推理和预测上表现强劲,但作者也坦诚地指出了挑战:
- 分辨率鸿沟:LLM 在处理连续型数值(如精确密度、体积)时仍有精度瓶颈。
- 幻觉风险:冻结的 LLM 背景知识偶尔会干扰物理推断。
总结 (Takeaway): MatterChat 的成功标志着材料科学 AI 正在从“黑盒属性回归”转向“具身物理推理”。它为科学家提供了一个能够听懂指令、观察晶体、并给出专业合成方案的智能助手。