
机器真的懂物理与人心吗?透视多模态 LLM 的视觉认知短板
nature machine intelligence Article
本文通过认知心理学实验方法,评估了 GPT-4V, Claude-3 Opus 等多模态大语言模型(MLLMs)在直觉物理、因果推理和直觉心理学三大核心认知域的表现。研究发现模型虽能处理基础视觉信息,但在复杂认知模拟任务中仍显著逊于人类。
TL;DR
随着 GPT-4V 和 Claude-3 的崛起,我们似乎已经构建出了能“看”会“说”的通用智能。然而,顶级学术期刊 Nature Machine Intelligence 最近发表的一项研究通过三项经典认知科学实验,狠狠地给这种乐观情绪泼了一盆冷水。结论很简单:目前的 AI 虽然擅长识别色彩和形状,但在需要“常识理论”支撑的物理直觉、因果推断和心理猜度上,依然与人类存在质的差距。
核心速览:视觉认知的“三大支柱”
认知科学家认为,人类智能的核心在于能够理解世界的“底层逻辑”——即由直觉物理(球怎么滚?)、因果推理(是谁撞到了谁?)和直觉心理学(他为什么要这么做?)构成的认知坐标系。
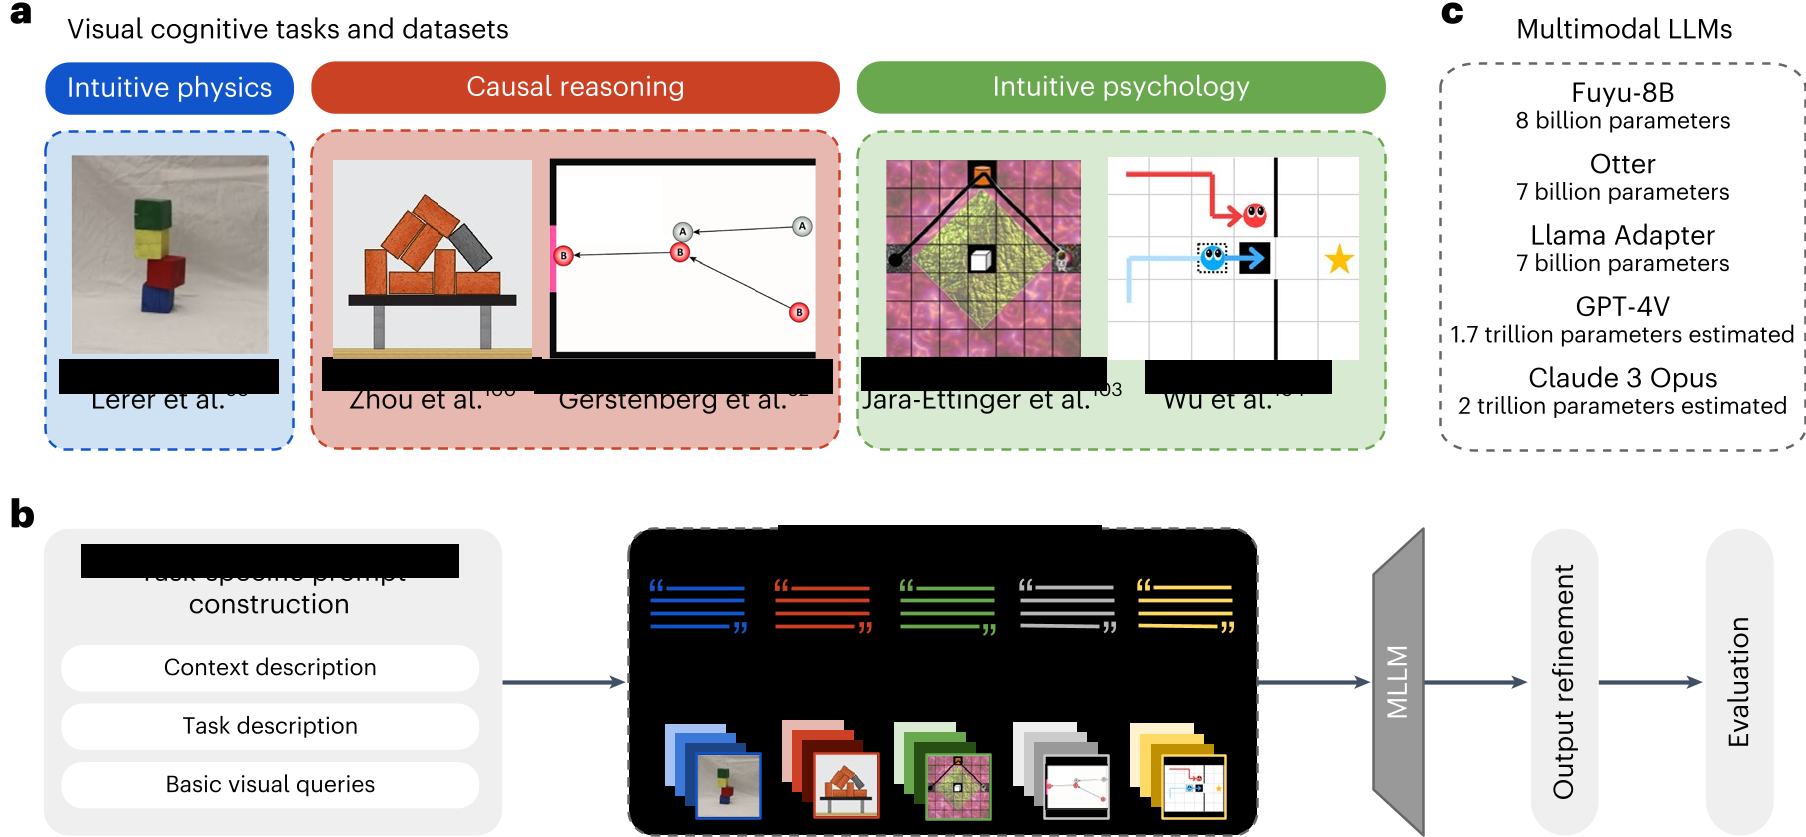
本文测试了包括 GPT-4V, Claude-3, Fuyu-8B, Otter 和 Llama-Adapter V2 在内的五款主流模型。研究者将这些 AI 视为“心理学实验的参与者”,直接对比它们在相同视觉刺激下的反应与人类真实行为数据的匹配度。
1. 直觉物理:倒塌的积木塔
在测试物理直觉时,模型需要观察一张真实世界的木块塔照片(由 2-4 个彩色木块组成),并判断其是否稳定。
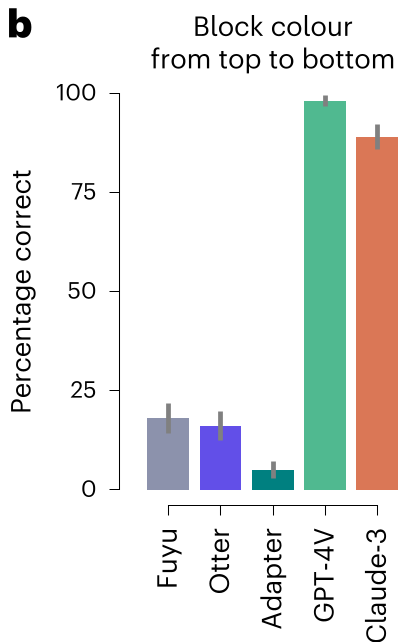
- 表现分析:虽然所有模型都能精准识别背景颜色和木块顺序(基础视觉识别),但在判断“是否会倒”这一物理模拟问题时,仅有 GPT-4V 和 Claude-3 表现出略高于随机水平的准确度。
- 认知鸿沟:人类即使面对高度复杂的结构,也能凭借大脑中的“物理引擎”模型(Physics Engine)给出 65% 以上的准确率,而 AI 在此处的 R² 值(相关性)极低,表明其并未真正理解重力和平衡原理。
2. 因果推理:Jenga 游戏与 Michotte 碰撞
因果推理测试更具挑战性:AI 需要预测“如果我抽走这块积木,会有多少块倒掉?”(反事实推理)。
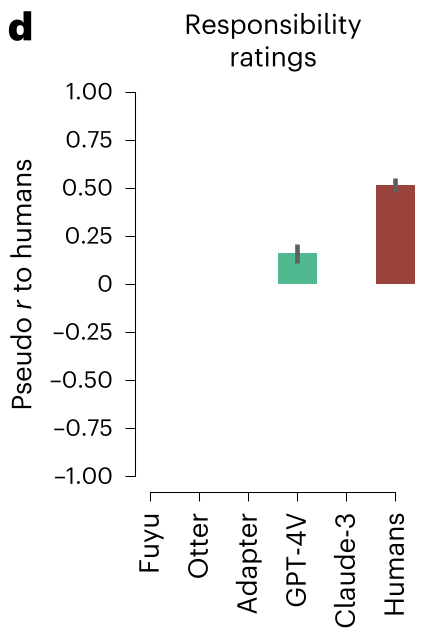
- Jenga 任务:GPT-4V 的表现接近人类,但仍显著不同。有趣的是,许多模型在复杂的因果责任评分中表现得极其僵化——例如 Fuyu 和 Claude-3 无论看到什么图片,都会给责任项无脑打出 100 分。
- Michotte 碰撞:这是一个经典的二维小球撞击实验。模型需要判断小球是否能进洞。令人惊讶的是,即使模型能读懂提示词中的轨迹描述,它们在预测结果和反事实假设(如果 A 球不在,B 球会进吗?)上表现惨淡。
3. 直觉心理学:他是在帮忙还是在捣乱?
这是最高维度的测试:心理理论(Theory of Mind)。研究者通过“宇航员任务”和“助人/阻碍任务”,测试 AI 是否能从智能体的行动路径中推断其奖励偏好和意图。
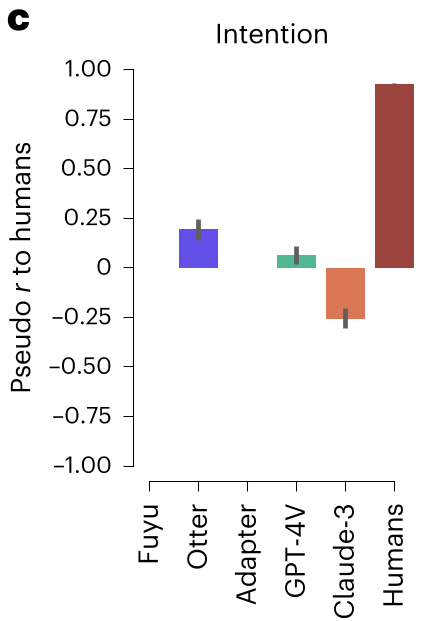
- 意图推断:人类可以轻易看出蓝色智能体是在推箱子“帮助”红色智能体,还是在“阻碍”它。
- AI 的滑铁卢:在该领域,几乎所有模型都未能表现出与人类数据强相关的能力。Claude-3 在判断“是帮还是损”时甚至与人类判断呈现负相关。这说明模型对于“代价”、“奖励”和“反事实意图”缺乏本质理解,只是在做低级的图像特征映射。
深度洞察:为什么 AI 还是“傻”?
作为资深技术主编,我认为本文揭示了当前多模态路线的一个关键悖论:Scaling Law 只能解决“知道什么”,却难以解决“如何思考”。
- 视觉底层缺陷:研究发现,模型在最基础的视觉计数任务(Counting Blocks)上表现就很挣扎。如果连“有多少东西”都没看清,更复杂的物理模拟自然难以为继。
- 缺乏显式模拟机制:人类大脑擅长运行内部概率模拟(Probabilistic Simulation),而 Transformer 本质上是序列预测器。它在处理静态、无逻辑关联的图像时,往往陷入局部统计陷阱。
- Prompt 敏感性:实验显示,即使改变微小的 Token 描述,模型的表现也会剧烈波动。这种不稳定性说明它并无稳健的认知结构。
展望:通往 AGI 的必经之路
这篇论文不仅仅是批评,它指明了方向。未来的多模态大模型如果想要获得真正的“理解力”,可能需要从纯文本/图像的预训练,转向体感认知(Grounded cognition)或集成自监督的物理引擎。
Takeaway:下一代 MLLM 的进化核心,将不再只是堆参数,而是如何将贝叶斯推理和因果图模型编织进神经网络。否则,AI 将永远是在认知迷雾中蹒跚的视觉巨兽。