
SIPT:让预训练模型“看透”样本间的几何结构
nature machine intelligence Article
本文提出了结构诱导预训练 (Structure-Inducing Pre-training, SIPT) 框架,旨在通过在预训练阶段显式引入样本间的关系图 (Graphs) 来优化隐藏层几何结构。该方法在蛋白质序列、生物医学论文摘要和蛋白质相互作用网络等三个领域、十项下游任务中均达到或超过了现有 SOTA 水平。
TL;DR
传统的预训练模型(如 BERT)擅长理解样本内部的逻辑(Word-to-Word),但往往忽略了样本之间(Sample-to-Sample)的全局结构。本文提出的 Structure-inducing Pre-training (SIPT) 框架,通过引入一个显式的“关系图”,强制模型在预训练阶段就学习到样本间的深度几何约束。实验证明,这种方法在蛋白质分析和学术摘要分类等任务上显著优于传统的自监督学习。
痛点深挖:隐空间里的“乌合之众”
在自然语言处理中,我们习惯于通过 Masked Language Modeling 让模型学习语法和语义。然而,当我们把这种范式迁移到生物、化学等领域时,问题就出现了:模型生成的“全样本嵌入(Per-sample Embeddings)”往往在几何上非常糟糕。
作者指出,目前的预训练约束主要存在两类缺失:
- 显式但浅层 (Explicit but Shallow):例如 BERT 的 NSP 任务(预测下一句),只能强制模型区分极少数类别,无法捕捉复杂的流形结构。
- 隐式但深度 (Implicit but Deep):例如对比学习,虽然能学习复杂特征,但由于缺乏明确的关系定义(通常依赖随机数据增强),我们很难控制它生成的隐空间形状。
这种缺陷导致模型无法有效利用领域内的先验知识(例如:两篇论文互有引用,它们在空间中理应更近)。
核心动机:将“图知识”注入“隐空间”
SIPT 的核心直觉非常纯粹:如果我们已经知道样本之间存在某种结构(如引用网络或分子相似性),为什么不直接通过数学手段把这个结构“焊”在模型的隐空间里?
作者定义了一个联合损失函数:
其中 负责诱导结构,它迫使模型在隐空间内重建用户提供的图 。
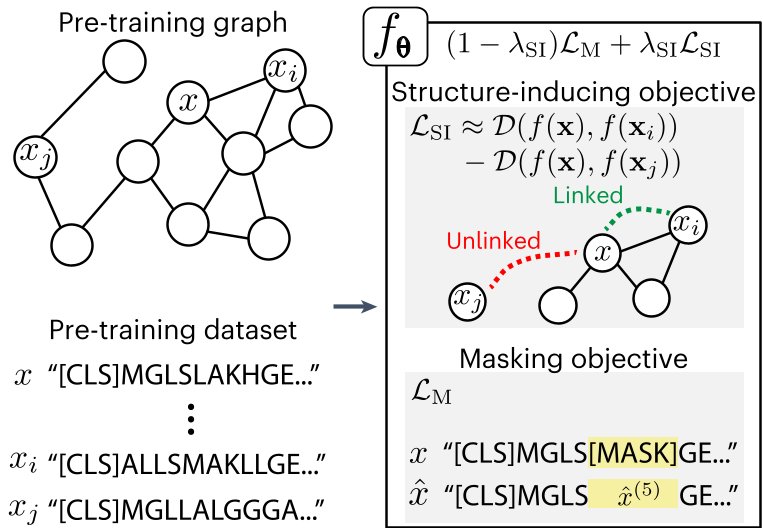 图 1:SIPT 框架流程,通过辅助图输入定义结构诱导目标。
方法论:理论导向的几何重构
SIPT 不仅仅是一个经验性的工程尝试,作者提供了严密的理论分析。他们证明了:当预训练模型的最优解能还原图 时,下游任务的准确度下界由该任务在图上的局部一致性(Local Consistency)决定。
这意味着,如果你选择了一个与下游任务高度相关的图(例如用 PPI 网络辅助预测蛋白质形态),你在理论上就锁定了下游性能的提升。
实验战绩:全线飘红
作者在三个差异巨大的领域进行了实验:
- 蛋白质 (Proteins):利用“生命树”相互作用图。
- 学术文献 (Abstracts):利用论文引用网络。
- 生物网络 (Networks):利用基因本体 (Gene Ontology) 的相似性图。
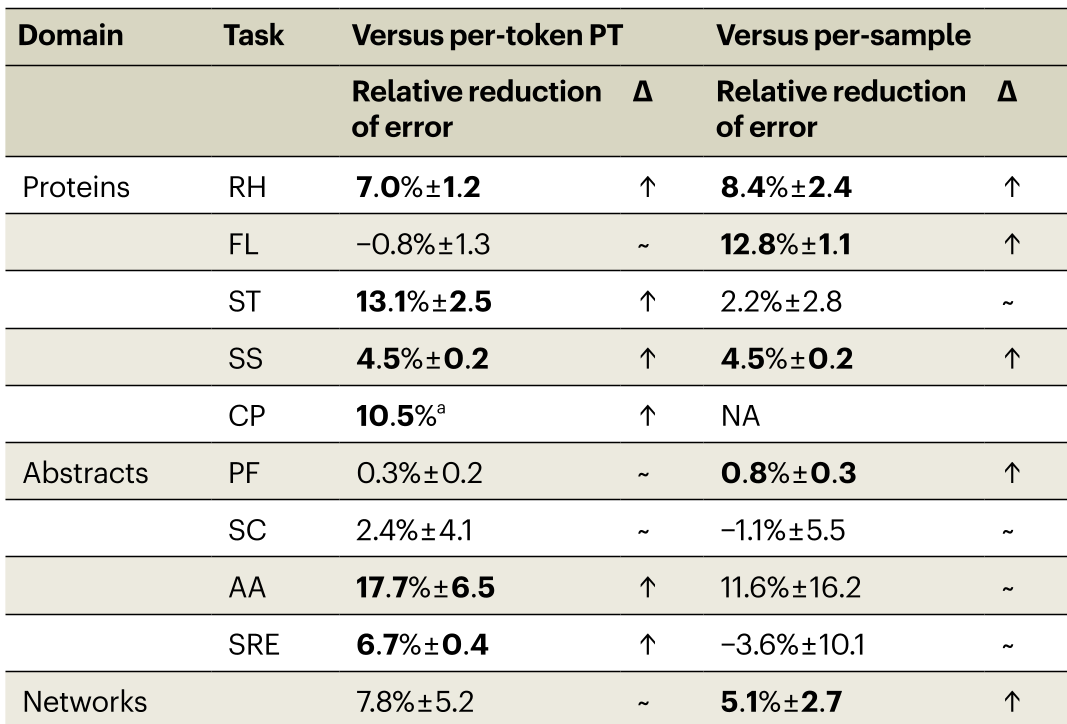 表 1:SIPT 相比于传统的单样本及单任务预训练方法的性能提升。
在蛋白质 Remote Homology 任务中,SIPT 实现了 SOTA;在学术文献领域,尤其在 ACL-ARC 等细分任务上,F1 分数提升惊人。更重要的是,SIPT 的训练效率更高,收敛速度明显快于基线模型。
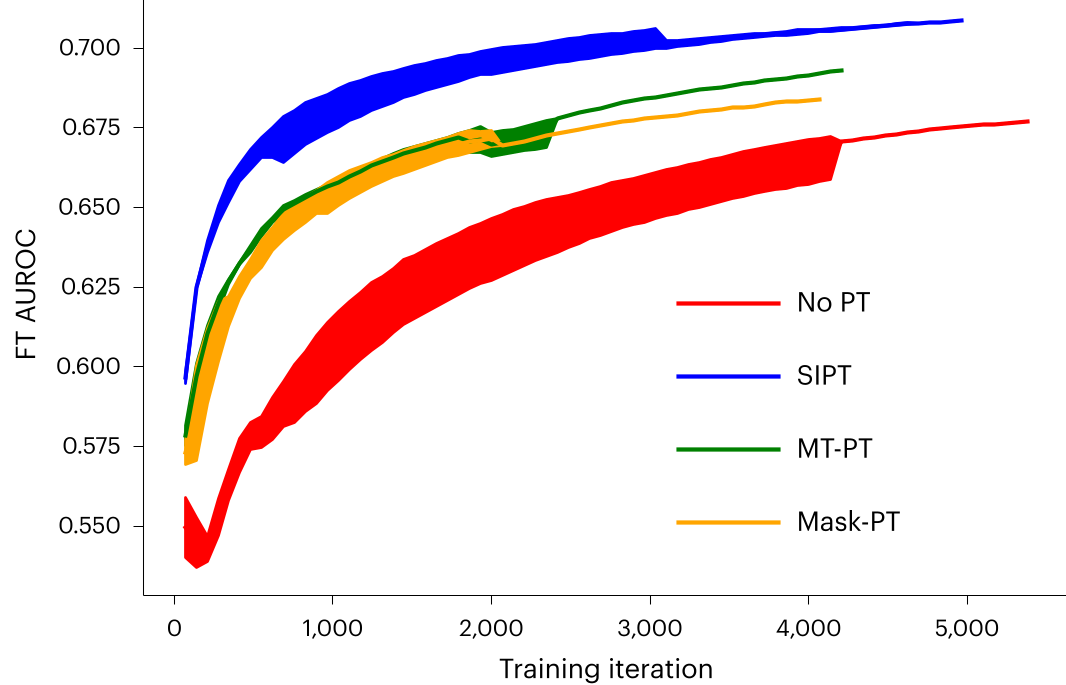 图 2:在 Networks 任务中,SIPT 展示了更快的收敛曲线。
深度洞察与总结
SIPT 的价值在于它打破了“自监督学习只能依赖数据本身”的固有思维,为“知识图谱 + 大模型”的结合提供了一条优雅的几何路径:
- 自适应性: 可以是外部知识库,也可以是自监督生成的相似度图。
- 鲁棒性:即使在预训练后期进行少量的 SIPT 调优(Warm-start),也能显著改善模型体质。
- 局限性:该方法高度依赖图 的质量。如果图结构与下游任务完全正交,诱导出的几何结构反而可能成为噪声。
结论:SIPT 为预训练时代提供了一个精细的操作杆,让我们能有目的地对隐空间进行“塑形”。对于那些天然具有结构化先验的科学计算领域,这无疑是一枚重磅炸弹。