
[arXiv 2026] NaviRAG:从被动匹配到主动导航,开启复杂 RAG 推理的新范式
NaviRAG: Towards Active Knowledge Navigation for Retrieval-Augmented Generation
本文提出了 NaviRAG,一种将检索增强生成(RAG)从“被动片段检索”转向“主动知识导航”的新框架。该框架通过构建多层级语义知识树,并结合 LLM Agent 执行由粗到细的循环导航,在长文本问答任务中显著提升了信息获取的精准度。
TL;DR
清华大学等团队近期提出的 NaviRAG 框架,打破了传统 RAG 系统的“搜索即匹配”模式。它借鉴认知科学中的信息采集理论 (Information Foraging Theory),将长文档重构为层次化语义树。通过 LLM Agent 在树结构中进行“巡航”,系统能够根据问题需求动态调整检索粒度,从而在复杂长链推理任务中实现 SOTA 性能。
背景定位:为何“扁平检索”已达瓶颈?
现有的 RAG 方法大多遵循“语义分箱 + 向量匹配”的范式。这种方式在处理简单事实查询时效果卓越,但在面对如《NarrativeQA》或《LooGLE》这类需要全局理解和局部证据交叉验证的任务时,会产生以下痛点:
- 粒度冲突:固定长度的 Chunking 无法兼顾“全局视野”与“局部精度”。
- 语境缺失:孤立的片段丢失了文档的逻辑层次感,Agent 无法感知证据背后的语义坐标。
NaviRAG 的核心直觉是:高效的信息获取不应是一次性的“盲猜”,而应是基于局部信号逐步逼近目标的连续决策过程。
核心机制:知识组织与导航检索
1. 层次化知识组织 (Knowledge Organization)
NaviRAG 并非简单地按目录划分文档,而是利用 LLM 将原始片段(Leaf Nodes)通过自底向上抽象 (Summarization) 和 自顶向下路由 (Routing) 结合的方式,构建出一棵“知识树”。
- 语义标识:每个节点包含 Title(语义标识)、Value(具体内容)和 Summary(跨层级访问支持)。
- 动态更新:插入新片段时,LLM 会判断应合并入现有分支还是开辟新子树,确保结构的紧凑性。
 图 1:NaviRAG 的整体框架,分为离线知识树构建与在线两阶段检索(定位+导航)。
2. 导航式检索 (Navigational Retrieval)
当用户提出问题时,检索不再是一步到位:
- 定位 (Locate):利用向量检索快速锁定相关的语义子树空间。
- 采集 (Forage):LLM Agent 从子树根节点出发,面临两个关键判定:
Absorb:当前层级的摘要已足够回答,直接采信。Expand:摘要信息不足,深入下一层级寻找更细粒度的证据。
此外,NaviRAG 还探索了 Memory-guided 机制,旨在记录已探索路径,防止 Agent 在复杂的长链推理中迷失或进行重复检索。
实验战绩:高效率下的精准打击
实验涵盖了叙事文本(NarrativeQA)、百科与垂直领域(LooGLE, LongBench-v2)等多维度场景。
1. 性能全线超越
在 NarrativeQA 上,NaviRAG 将 F1 分数从 27.80 提升至 32.60。更重要的是,在长路径依赖的任务(LooGLE-long)中,NaviRAG 展现出了比 GraphRAG 更稳定的优势,且推理成本更低。
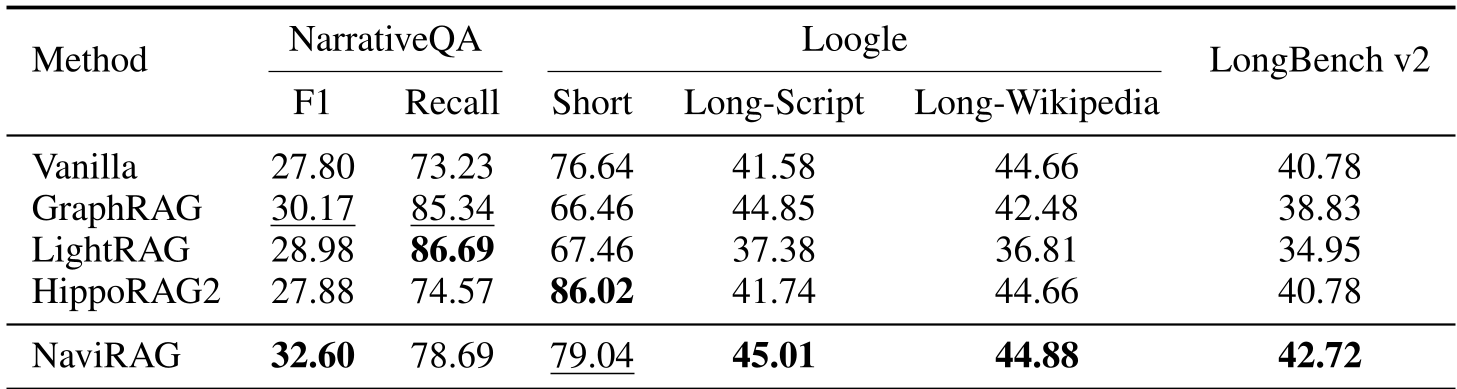 表 1:NaviRAG 与主流 RAG 方法在多项指标上的对比。
2. 惊人的上下文效率 (Context Efficiency)
NaviRAG 最具启发性的发现是:它在 Top-k=3 时的表现就超过了 Vanilla RAG 在 Top-k=15 时的性能。这意味着通过智能导航,模型即使用更少的 Token(减少了无关内容的输入),也能获得更高质量的上下文。
深度洞察:为什么这很重要?
- 语义连续性偏好:消融实验显示,NaviRAG 在剧本 (Script) 等叙事性强的文档(语义连续性强)上提升尤其显著,而在模块化的模块(如 Wikipedia)上提升相对平缓。这提示我们,检索机制必须与文档的本质结构相匹配。
- 推理成本的平衡:相比于构建全局复杂图谱的 GraphRAG,NaviRAG 侧重于局部子树的深度挖掘,在保持高召回率的同时,极大地降低了预处理成本。
总结与展望
NaviRAG 证明了“检索”本身也可以是智能的、有目的的。通过将知识库结构化和检索过程 Agentic 化,我们正在接近一种更接近人类阅读习惯的 AI 交互模式。未来的方向可能在于如何将这种垂直导航与水平的图连接(Graph-based RAG)相结合,构建出真正全知全能的超级 RAG 系统。
局限性提示:目前的内存更新模块在小模型上可能存在语义漂移问题,且对于完全没有自然结构的杂乱文档,层次化构建的质量仍依赖于 LLM 的初始总结能力。