
NPO:让“未来的你”教“现在的你”做题,突破推理模型性能天花板
Near-Future Policy Optimization
本文提出了近未来策略优化 (NPO) 框架及其自适应版本 AutoNPO,旨在解决强化学习中验证性奖励 (RLVR) 的效率与性能瓶颈。通过引入该模型在训练时间线上的“近未来”检查点生成的高质量且分布接近的轨迹,NPO 在 Qwen3-VL-8B 等多模态模型上实现了显著的性能飞跃(平均分从 57.88 提升至 63.15)。
TL;DR
在强化学习(RL)的训练中,模型常常面临两个困境:早期因为太菜拿不到正确奖励(Sparse Reward),后期因为太熟练而陷入思维定式(Plateau)。本文提出的 Near-Future Policy Optimization (NPO) 给出了一个精妙的解法:既然外来的导师教不会,过去的经验不够强,那就让训练快走几步后的“未来自己”生成正确答案,再回过头来教现在的自己。这种方法在多模态大模型 Qwen3-VL 上实现了接近 5% 的平均性能提升。
核心视角:质量与方差的“相爱相杀”
在带验证奖励的强化学习(RLVR)中,我们通常会引入一些非策略(Off-policy)的轨迹来加速收敛。但这里存在一个学术界长期未解决的 Q-V 权衡(Quality-Variance Trade-off):
- 外部导师(External Teachers):比如用 GPT-4 的轨迹教小模型。Q 值(质量)极高,但 V 值(方差)爆炸。因为两者的说话风格、推理逻辑(Distribution)完全不同,小模型强行模仿会导致梯度不稳定。
- 历史回放(Experience Replay):用模型昨天生成的正确轨迹教今天的自己。V 值虽低(因为是自己生的),但 Q 值有上限——它无法教你你还不会的新知识。
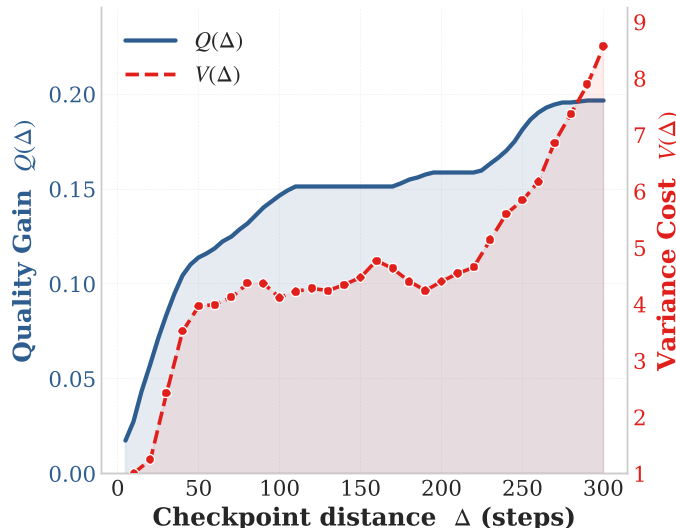
NPO 的直觉非常物理:在同一个训练流中,未来的检查点(Checkpoint)比现在更强(High Q),且由于参数继承和优化路径一致,它的分布与现在最为接近(Low V)。通过调节“领先步数” ,我们可以精准地找到那个让 有效学习信号 最大化的甜点区。
机制解析:NPO 与 AutoNPO
1. NPO 的核心操作
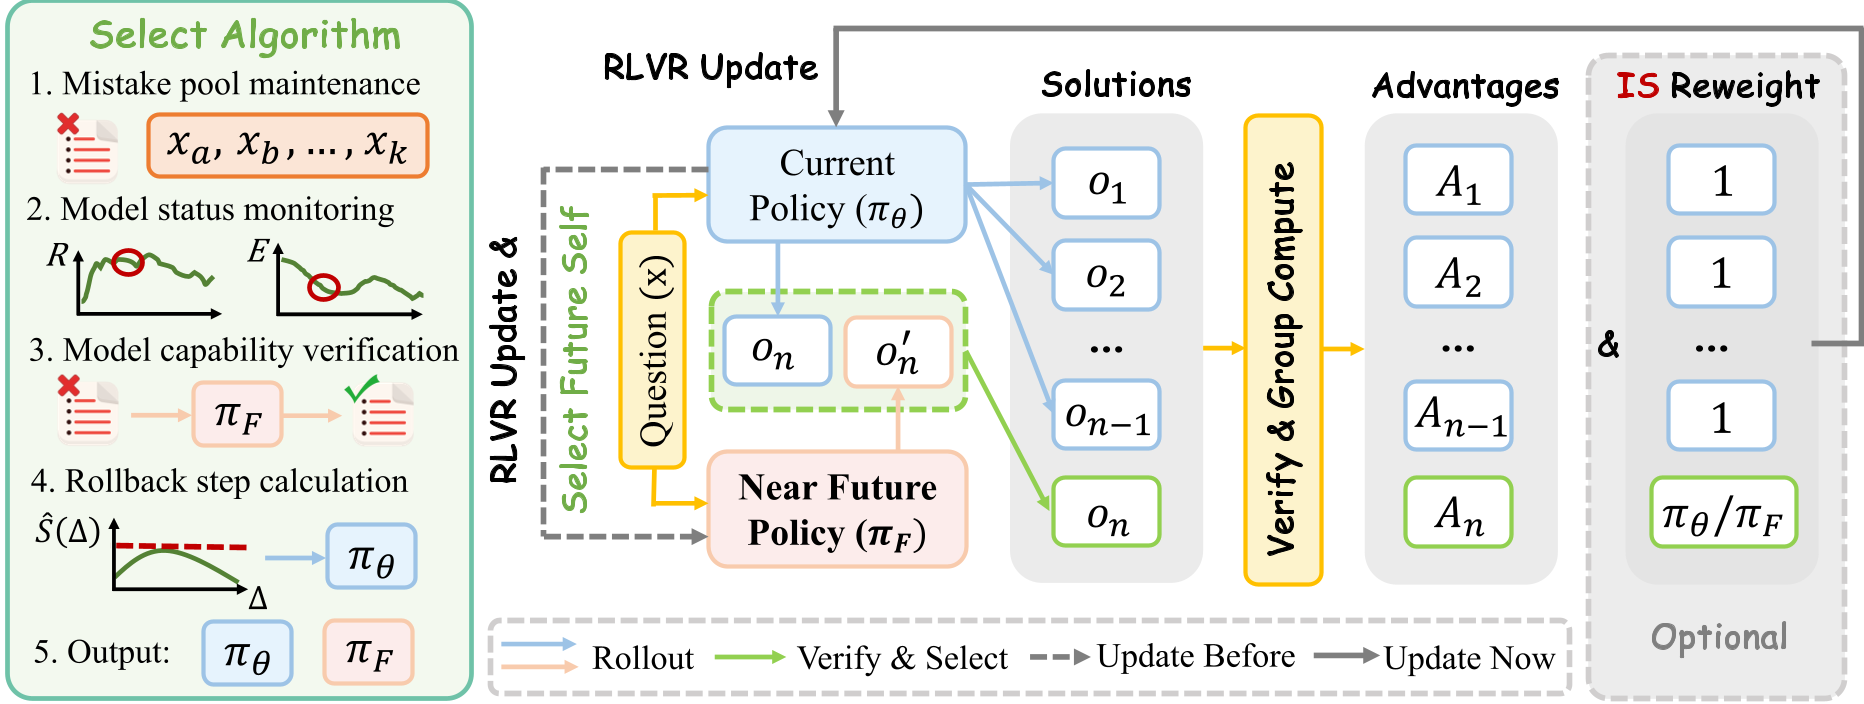
NPO 并不改变复杂的奖励函数。它的逻辑极其简单:在进行每一轮 Rollout(采样)时,如果发现当前模型在某个问题上表现很吃力(正确率低于阈值),就从预先生成的“近未来”轨迹库中拿出一个正确答案,替换掉采样组中的一个名额。
- 优势:它不强迫模型完全变成未来那个样,而是给出一个高质量的“参考答案”,引导模型探索正确的推理路径。
2. AutoNPO:自适应的“回溯优化”
手动设置“领先多少步”是不科学的。作者为此设计了 AutoNPO 自动化控制器:
- 触发器(Trigger):监控奖励 EMA 和策略熵(Entropy)。如果发现奖励止步不前,而熵值持续下降(意味着模型思维僵化、陷入局部最优),则触发预警。
- 回退决策(Rollback):通过计算不同 下的学习信号 ,自动选择最佳的回退点。
实验战果:全方位的跨越
在 Qwen3-VL-8B 上的实验涵盖了 MathVista、ZeroBench 等 8 个高难度推理基准:
- 突破平台期:在训练后期,纯 GRPO 算法通常会遇到瓶颈。AutoNPO 能够精准“破局”,让模型在 MathVerse 等深度推理任务上持续增益。
- 加速收敛:在早期,通过短时间的“先行探路”(Scout run),NPO 能为模型提供宝贵的冷启动信号。
- IS Correction 的惊喜:作者发现,由于“近未来”轨迹本身就极度贴近当前策略,甚至连复杂的 重要性采样(Importance Sampling) 修正都可以省略,这对训练复杂度和显存开销非常友好。

深度总结与展望
NPO 实际上是将“时间”作为了一种廉价且高质量的特权信息。它告诉我们:在大模型自我进化的道路上,最好的老师可能不是最强的那个,而是稍微走在你前面的那个。
局限性分析: 尽管 NPO 极其有效,但它需要额外的训练时间来生成“未来检查点”或进行“探路”。如何进一步降低这种计算开销,或者将其与在线蒸馏(On-policy Distillation)结合,是未来值得探索的方向。
这项研究是“Self-Taught RLVR”范式的重要组成部分。通过这种“ temporal self ”的引导,我们正在通往更自主、更高效的通用逻辑推理能力的道路上稳步前进。
本文由资深学术技术主编重构,旨在提供最精准的 AI 研究洞察。