
POW3R:并非每一条准则都能教好模型,策略感知的 RLVR 奖励重构
Not Every Rubric Teaches Equally: Policy-Aware Rubric Rewards for RLVR
本文提出了 POW3R(Policy-Aware Rubric Reward),一种针对强化学习验证奖励(RLVR)的策略感知准则奖励框架。该方法通过动态调整准则项(Criterion)的权重,在保持人类原始权重和类别平衡的同时,优先优化对当前策略具有区分度的信号,在多模态和文本任务上显著超越了传统的 GRPO 方法。
TL;DR
在强化学习(RL)后训练阶段,我们通常使用“准则(Rubric)”来评估模型在复杂任务(如多模态推理、医疗建议)中的表现。本文的核心发现是:人类认为重要的准则,在训练初期往往无法提供有效的梯度信号。 作者提出的 POW3R 框架通过动态调整奖励权重,将重心放在模型“跳一跳够得着”的准则上,在保持评估目标不变的前提下,使收敛速度提升了 4 倍。
背景定位
在 RLVR(基于可验证奖励的强化学习)领域,GRPO 等算法已成为 SOTA 标配。然而,当任务从简单的数学题转变为需要同时满足事实准确、格式优雅、视觉对齐的复杂任务时,单一的标量分数会掩盖模型在不同维度的失效。Rubric(评价量表)应运而生,但如何科学地将多个 Rubric 项聚合为一个标量奖励,一直是制约性能的瓶颈。
痛点深挖:静态权重的“死区”
传统的做法是给每个 Rubric 项设定一个静态权重(如:事实性 5 分,语气 1 分)。作者通过诊断发现了一个惊人的事实:
- Dead Criteria (已失效):模型目前的水平完全无法通过该项,方差为 0。
- Saturated Criteria (已饱和):模型已经完美掌握该项,方差同样为 0。
在这种情况下,静态权重即使给这两类准则分配再高的分数,在 GRPO 的相对比较机制下也会因为差值为 0 而被抵消,导致训练压力(Training Pressure)被白白浪费。
 图 1:研究显示,约一半的高权重准则在训练初期属于“无信号”状态(饱和或失效)。
Methodology:POW3R 的策略感知艺术
POW3R(Policy-Aware Rubric Reward)的设计直觉非常直接:保持最终考卷不变,但动态调整练习课的侧重点。
核心机制:
- 方差测量 (Variance Sensing):在每个训练 Epoch 中,记录模型输出在各个 Rubric 项上的得分方差 。高方差意味着模型在这一项上正处于“犹豫期”,这是最佳的学习时刻。
- 动态重归一化 (Renormalization):
- 计算每个 Rubric 的动态因子 ,该因子与方差成正比。
- 类别平衡:在同一个类别(如“视觉感知”)内部调整权重,确保该类别的总权重占比保持恒定。这保证了模型不会为了刷分而产生严重的“偏科”。
- 平滑更新 (EMA):使用指数移动平均更新权重,防止奖励信号剧烈抖动导致训练崩溃。
 图 2:POW3R 奖励聚合流程,展示了如何从 Rollout 统计中提取动态权重。
实验与结果:速度与质量的双重飞跃
作者在多模态数据集(MM)和医学文本数据集(HealthBench)上进行了广泛测试,覆盖了 Qwen3-VL 和 Gemma 3 等多个模型系列。
1. 训练效率对比
这是 POW3R 最亮眼的成绩。在达到 46.0 的基准分时,POW3R 仅需 83 步,而传统的静态加权方法需要 249 步,效率提升了 3-4 倍。
2. Pareto 支配地位
在“准则总分”与“严格完成率(即所有必须准则全部通过)”的二维坐标系中,POW3R 始终位于右上角,显著优于 Binary 奖励和静态 Scalar 奖励。
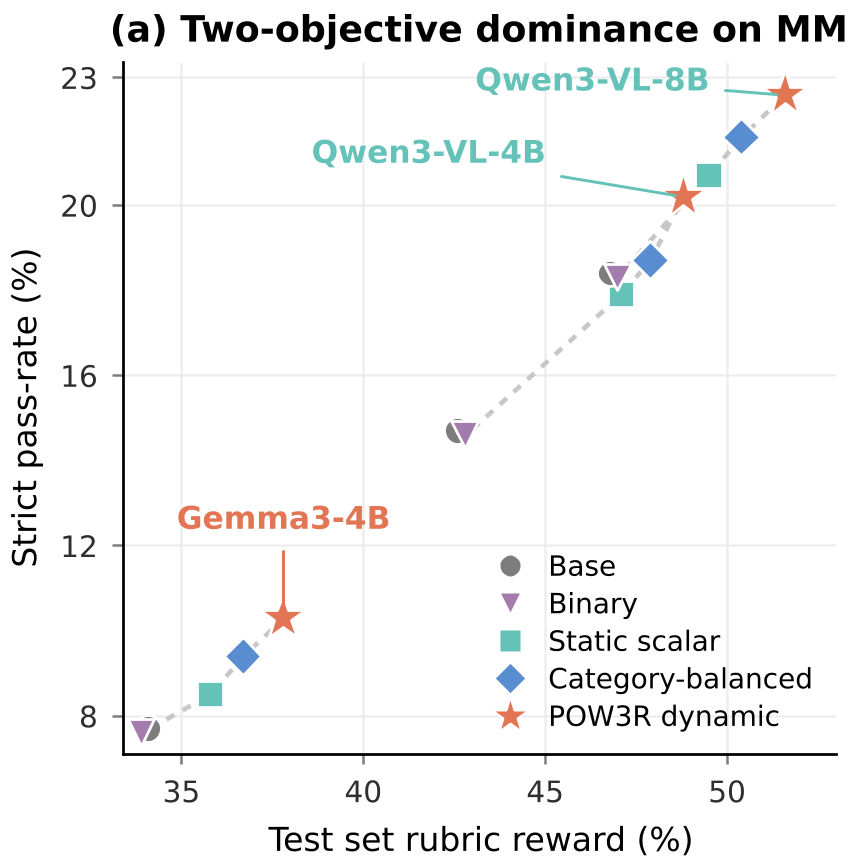 图 3:训练轨迹显示 POW3R(紫色)在各个阶段都保持领先,且收敛更快。
深度洞察:为什么有效?
POW3R 实际上在进行一种隐式的课程学习(Curriculum Learning)。当模型还在纠结基本的“视觉感知”(如认错图中的狗)时,POW3R 会自动加大这一项的权重;而当模型已经掌握了基础感知,开始进入复杂的“逻辑推理”博弈时,权重会平滑地向后者迁移。
这种方法最宝贵的地方在于,它不需要人为设计课程阶段,而是让模型根据自己的 Rollout 表现自行决定当下的“学习重点”。
局限性
- 法官偏差:POW3R 高度依赖 LLM Judge(如 GPT-5.4-mini)的判别质量。如果 Judge 本身在某些 Rubric 上有偏见,动态权重可能会放大这种偏差。
- 计算成本:每项准则都需要独立的判别调用,虽然论文通过 Nano 级别的模型降低了成本,但在超大规模任务上依然是一笔开支。
总结
POW3R 证明了:在复杂目标的 RL 训练中,“平均分配注意力”是低效的。通过感知策略的实时状态并动态重分配训练压力,我们可以在不改变人类价值对齐(Alignment)目标的前提下,极大地加速人工智能的进化。
这项工作为未来开发能够自我诊断、自我设定学习目标的自进化 LLM 提供了重要的理论支撑。