
UMM-CSGM:统一评分生成框架,突破多模态医学图像补全的不确定性瓶颈
A Novel Unified Conditional Score-based Generative Framework for Multi-modal Medical Image Completion
本文提出了 UMM-CSGM,这是一种基于评分生成模型(SGM)的统一多模态条件医学图像补全框架。该模型通过在完整模态空间内定义条件扩散与反向生成过程,配合新颖的多入多出条件评分网络(mm-CSN),实现了在单一网络下灵活合成任意缺失的医学模态(如 Flair, T1, T2 等),并在 BraTS19 数据集上达到了 SOTA 性能。
TL;DR
在医学影像诊断中,由于扫描时间或设备限制,往往会出现某些模态(如 T1, Flair)缺失的情况。本文提出的 UMM-CSGM 框架首次将评分生成模型 (SGM) 引入统一的跨模态补全任务。通过将扩散过程定义在完整的模态空间中,该方法不仅能用一个模型解决任何模态缺失组合的合成问题,更凭借其概率生成的特性,完美捕捉了跨模态转换中的不确定性,成倍提升了图像的保真度与病灶描述的准确性。
背景定位:从确定性映射到概率生成
在多模态神经影像(如 MRI)中,不同序列提供互补的病理信息。传统的 SOTA 方法多采用 cGAN (Conditional GANs)。然而,GAN 存在的固有缺陷是训练不稳定,且容易产出“统计平均值”式的模糊图像——由于跨模态映射本质上是一对多的(具有不确定性),强行使用确定性映射会导致模型忽略这些细微但关键的变异(Uncertainty)。
UMM-CSGM 此时应运而生,它站在 SGM (Score-based Generative Models) 的肩膀上,将图像合成看作是从噪声到目标分布的随机演化过程,从而在处理肿瘤区域等复杂异质性结构时表现得游刃有余。
核心动机:为什么需要“统一”且“条件化”?
- 现状痛点:以往的 SGM 变体多是单对单(如 T1 生成 T2),若要应对不同的缺失组合(缺失 T1、或者同时缺失 T1 和 T2),需要训练多个模型。
- 物理直觉:所有的 MRI 模态其实都是对同一解剖结构的物理成像。作者认为,应该在完整的模态空间中进行扩散,将已知模态作为“锚点”引导缺失模态从噪声中还原。
架构解析:mm-CSN 网络
UMM-CSGM 的核心是一个名为 mm-CSN (Multi-in Multi-out Conditional Score Network) 的 U-Net 结构。
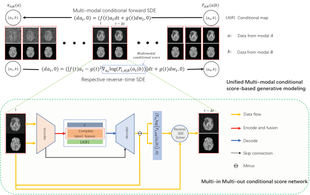
- 条件扩散 (Conditional Diffusion):在向前扩散阶段,只给目标模态 增加高斯噪声,而条件模态 保持清晰。
- 反向生成 (Reverse Generation):网络在每一个时间步 接收当前的带噪状态,并结合一个“模态配置代码”,预测当前分布的梯度(即评分 Score)。
- 数学直觉:通过解条件反向随机微分方程 (Reverse SDE),模型在条件的约束下,一步步将噪声“推”回真实的缺失图像分布。
实验战绩:力压主流 GAN 模型
研究团队在 BraTS19 (脑肿瘤分割挑战赛) 数据集上进行了严苛测试。对比对象涵盖了 CocaGAN, Hi-Net, MM-GAN 等一众性能悍将。
定量分析
如下表所示,UMM-CSGM 在所有指标上均实现了霸榜:
- PSNR 提升:在 Flair 和 T1 任务中,相比基线模型提升了 1-2 dB。
- 鲁棒性:标准差更小,说明模型在面对极端病变(Hard Cases)时更加稳定。
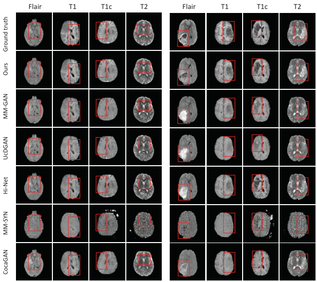
视觉表现(定性评估)
观察上图可见,在恶性肿瘤(Malignant Tumors)区域,GAN 模型往往生出模糊的斑块,而 UMM-CSGM 能够清晰地还原出肿瘤内部的异质性特征。在红框标注的细节中,灰质与白质的界限在 UMM-CSGM 的合成结果中远比其他模型清晰。
深度洞察:为什么它有效?
UMM-CSGM 的成功在于它将归纳偏置 (Inductive Bias) 设定为学习分布而非学习映射。在医学影像中,一个 T2 图像可能对应多种潜在的 T1 状态(由于切片厚度、伪影或病理变化),SGM 的随机迭代过程允许模型从这些潜在状态中采样,从而避免了模糊感和伪影。
局限性与展望
- 推理速度:尽管效果惊艳,但基于 SDE 的采样过程通常需要数百次网络前向推理,相比 GAN 的一次性生成,速度仍是瓶颈。
- 未来潜力:该框架的“多入多出”思想非常适合扩展到其他逆问题,如加速 MRI 重建、PET/CT 融合等。
总结:UMM-CSGM 不仅仅是一个更强的“翻译器”,它为多模态计算提供了一个优雅的统计学视角,证明了在医疗 AI 领域,尊重数据的不确定性与建模其完整分布同样重要。