
动作观察的科学:不仅是模仿,更是一场认知的精准干预
Observation interventions for motor skill learning and performance: an applied model for the use of observation
本文提出了针对运动技能学习与表现的观察干预应用模型。通过回顾大量体育与日常生活动作研究,建立了基于“5W1H”架构的系统化干预框架,旨在优化观察法在技能获取、策略开发及心理调节中的应用效果。
TL;DR
在运动训练中,“看别人怎么做”几乎是本能。但 Diane M. Ste-Marie 及其团队在本文中指出,传统的“跟我学”示范往往处于低效状态。本文提出了一个革命性的应用观察模型,强调必须基于观察者特征和任务属性,精准推演“谁来示范、看什么、怎么看、何时看”这四大核心变量,从而实现技能学习与心理表现的双重突破。
背景定位
这篇文章不只是文献综述,它是观察学习(Observational Learning)领域从实验心理学向量化教练科学转型的里程碑。它将复杂的认知心理学理论(如 Bandura 的社会认知理论)转化为可操作的干预模型,是体育教练、运动康复师及人机交互设计者的实战指南。
痛点深挖:为什么你的“动作示范”没效果?
传统的示范法往往面临两个陷阱:
- 单纯的“精通模型”(Mastery Model)困境:初学者看顶级专家(如乔丹的投篮)往往会产生挫败感。
- 忽视生态有效性(Ecological Validity):实验室里的转盘追踪任务无法等同于冰场上的空中旋转。
作者发现,现有的干预缺乏对“Function”(为什么观察)的深思。观察不仅是为了学动作(Skill Function),还是为了学策略(Strategy Function)和调节心理状态(Performance Function,如缓解焦虑、提升信心)。
核心方法论:观察干预的 5W1H 模型
1. 架构解析
应用模型将干预决策分为两个层级。第一层级是前置评估:观察者是谁(儿童、精英运动员还是康复病人?)以及任务是什么(是简单的挥手还是复杂的体操组合?)。
在此基础上,模型展开了四个干预维度:
- Who (谁来做示范):除了教练,是否可以考虑应对模型(Coping Model)?即演示一个从失败、挣扎到最终成功的完整过程,这对提升自我效能感尤为有效。
- What (观察什么):是看全身录像,还是看点光源(Point-Light Displays)?研究发现,复杂的全身任务更依赖相对运动信息。
- When (何时看):是在训练前集中看,还是训练中穿插看?
- How (呈现形式):主观视角(相机在身后)还是客观视角(相机在面前)?
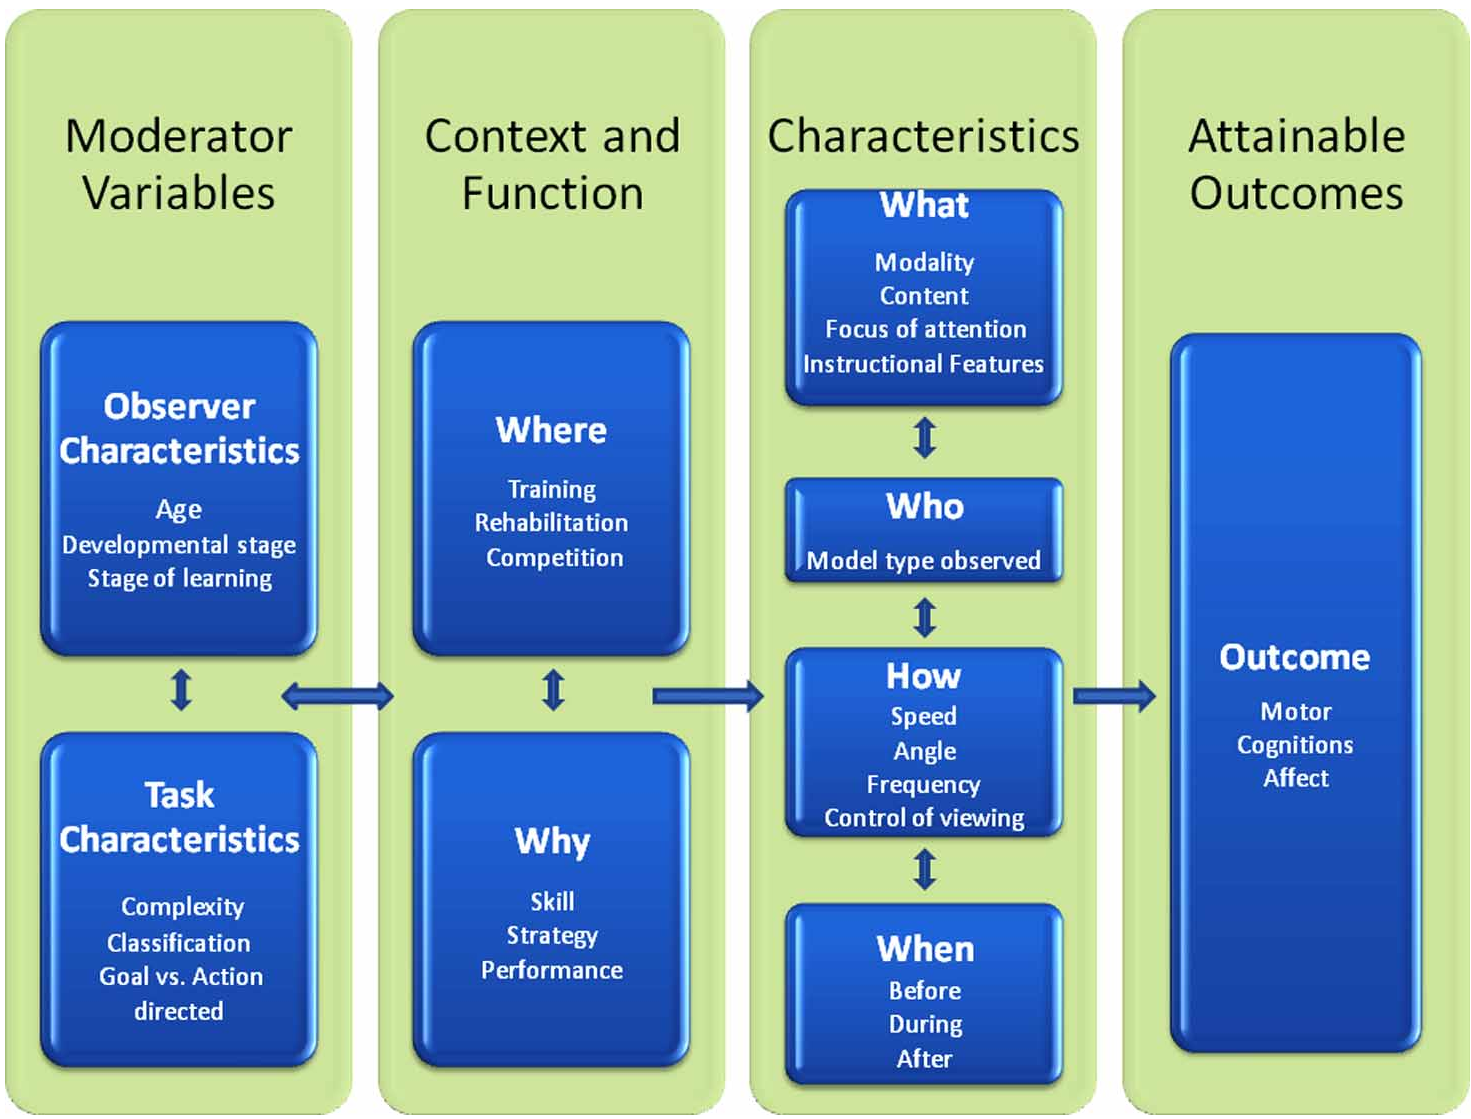 上图展示了从观察前评估到干预实施的完整逻辑链条。
核心洞察:不同人群的“说明书”
儿童 vs. 成人
- 5-7 岁儿童:单纯看视频是不够的,他们需要**口头线索(Verbal Cues)**来辅助。他们往往更关注动作结果(球进没进),而非动作细节(手肘角度)。
- 精英运动员:他们能从“自我观察”(Self-Modeling)中获取巨大的心理能量。通过观看自己“高光时刻”的剪辑视频,能显著提升比赛中的自我效能感。
自控频率的威力
实验结果显示,让受试者自己决定什么时候看回放(Self-Controlled Frequency),其学习效果往往优于由教练强行规定的 100% 频率回放。这暗示了观察过程中的“认知参与度”比单纯的曝光次数更重要。
实验与结果分析
论文汇总了数十项干预研究,关键战绩如下:
- 运动协调性:观察干预对改善动作质量(Movement Dynamics)的效果远大于单纯的文字指令。
- 反恐怖训练:在游泳、滑冰等带有一定恐惧感的运动中,应对模型(最初表现出害怕后期克服的模型)在心理调节上的效果优于精通模型。
- 康复领域:对于 ACL 重建后的患者,观看同类病人的康复视频可显著降低痛觉感知并提升康复训练的积极性。
局限性与未来展望
尽管该模型逻辑严密,但目前在神经康复和高压竞技环境下的实证研究仍显不足。
- 未来方向:利用高眼动追踪(Visual Search)和脑机接口(EEG/fMRI)深入研究观察时的视觉搜索策略。例如,初学者和专家在观看示范时,眼睛到底在盯着哪里?
总结 (Takeaway)
不要再把观察仅仅看作一种被动的视觉接收。观察是一种主动的行为模拟。 下次你在执教或自我提升时,请先评估你的受众和任务,然后问自己:我给出的这个视频,是在展示“完美”,还是在展示“如何从错误走向完善”?
关键词:Observational Learning, Self-Modeling, Motor Skill, 5W1H Model, Coping vs. Mastery.