
To Be or Not To Be:OCR 噪声与标注偏差如何左右临床提取性能?
To Be or Not To Be: The Impact of OCR Noise and Annotation Errors on Semi-Structured Extraction from Clinical Reports
本文针对临床报告半结构化提取任务,系统研究了 OCR 噪声和标注错误对模型性能的影响。作者通过模拟不同密度的噪声与标注质量,提出了基于 BERT-BiLSTM-CRF 的稳健提取模型,并在真实医院场景中完成部署。
TL;DR
在将 AI 模型部署到真实医院环境时,实验室中 99% 的准确率往往会因为一张模糊的扫描件或一个粗心的标注员而瞬间崩塌。本文深入探讨了临床报告半结构化提取中的两个“房间里的大象”:OCR 噪声与标注错误。通过系统的实验模拟,作者量化了各项因素对 F1 值的贡献,并为工业界提供了极具参考价值的部署指南。
背景定位
本文不属于通过魔改架构刷新 SOTA 的“技巧型”论文,而是一篇扎实的工程落地指南。它针对 BERT 尺度模型在本地化部署(On-premise)中的痛点,回答了开发者最关心的问题:钱该花在买更好的 OCR 引擎上,还是雇佣更专业的医学专家来写标签?
痛点深挖
- OCR 的异质噪声:由于扫描设备老化或折痕,OCR 会产生字符替换、段落错位及莫名其妙的空格。
- 标注成本与一致性:医学标注极其昂贵。初级标注员容易产生“漏标”(Omission),而即使是高级专家也难以保证实体边界(Boundary)的绝对统一。
- 降噪系统的伪命题:很多时候,单纯的预处理降噪反而会引入新的幻觉(Hallucination),导致医疗核心指标受损。
方法论详解:如何模拟“真实”的混乱?
作者并没有简单地随机添加噪声,而是通过分析真实 oncology 报告,建立了一套精细的合成体系:
- 基于 PPL 的噪声检测:使用 MC-BERT(针对中文医疗优化的 BERT)计算文本序列的困惑度。当某个区域的 PPL 远高于基准值时,即识别为 OCR 噪声区间。
- 多维度噪声模拟:将噪声分为视觉相似字符替换、幻觉空格、分段错位等 7 类(见下表),并按 Gamma 分布调整噪声密度。
- 标注员分级:通过 K-Means 聚类将标注员分为“Senior”和“Junior”,前者错误率约 6%,后者高达 35%。
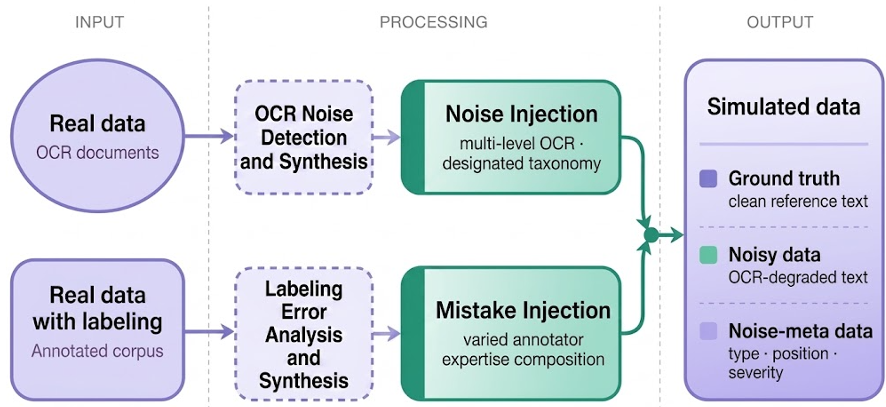
图 1:OCR 噪声建模与数据合成管线
核心实验结论
1. 噪声对齐原则 (Noise-Aware Training)
实验发现,模型表现最好的情况通常发生在训练集噪声水平与部署测试集噪声水平一致时。如果无法预知部署环境的质量,使用“中等噪声”级别的数据进行训练,比使用纯净数据训练出的模型更稳健。
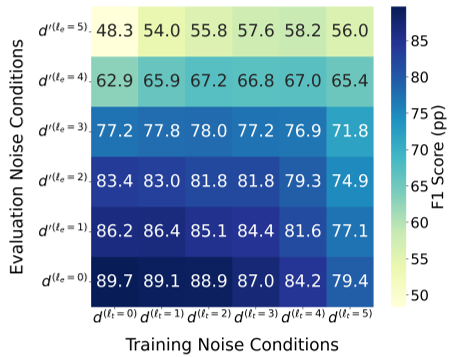 图 2:不同训练/测试噪声等级下的 F1 热图,可以看到明显的对角线优势
2. 标注投入的“性价比”
通过模拟不同资深程度标注员的比例,作者发现:
- 漏标(Omission)不仅损害性能,且远比边界偏移更难修复。
- 收益递减点:当资深标注员占比达到 60% 后,F1 值的提升开始变缓。这意味着在有限预算下,没必要追求 100% 的专家审核,4:6 的初/高级分配最为划算。
3. 降噪模块的尴尬
令人惊讶的是,作者部署的 ByT5 降噪模块并未带来持续增益。原因在于降噪过程可能误改关键的医疗术语或数字标识,这在严肃的临床场景中是不可接受的。
深度洞察与总结
落地建议 (Actionable Guidance)
- 监控先行:比起调参,先建立 OCR 质量监控体系。测试集噪声才是决定性能的“天花板”(Var. 56%)。
- 容错训练:不要追求纯净数据。在训练中加入模拟噪声是低成本提升模型鲁棒性的捷径。
- 抓大放小:约束标注团队,宁可边界多划一个字符,也绝不能漏标。
- 谨慎使用 Generative Denoising:目前的生成式模型(如 T5/ByT5)在不加极强领域约束的情况下,用于医疗文本修复仍需谨慎。
局限性
论文目前主要基于 BERT 尺度的模型,对于 LLM 在此类任务中的 Zero-shot 容错能力讨论较少;此外,降噪模块的失败也暗示了该领域仍需更强的领域适配算法。
Takeaway: 在医疗 AI 落地中,数据的“真实性”(包含噪声)往往比数据的“完美性”更能训练出经得起推敲的模型。