
OMEGA:大模型数学推理的“破墙”之战,LLM 真的具备数学创造力吗?
OMEGA: Can LLMs Reason Outside the Box in Math? Evaluating Exploratory, Compositional, and Transformative Generalization
本文推出了 OMEGA 评测基准,旨在系统评估大语言模型(LLMs)在数学推理中的三类 OOD 泛化能力:探索性、组合性和变革性。通过程序化生成的 AIME 级题目,研究揭示了即使是 DeepSeek-R1 等顶级模型,在面对复杂或需要策略切换的非分布问题时仍存在显著性能瓶颈。
TL;DR
尽管像 DeepSeek-R1 这样拥有超长思维链(CoT)的模型在竞赛数学上屡创新高,但它们是否只是更加熟练的“刷题家”?伯克利等机构联合发布的 OMEGA 论文给出了冷静的回答:当问题超出训练分布,特别需要技能组合或策略变革时,顶级模型的表现会遭遇“断崖式下跌”。
1. 背景定位:从“刷题”到“创造”
在数学领域,真正的能力不在于处理过多少类似的题,而在于面对未见过的问题时,能否灵活调节策略。OMEGA 基准测试的意义在于,它不再只是堆砌题目,而是将数学推理泛化能力量化为三条轴:探索性(Exploratory)、组合性(Compositional)和变革性(Transformative)。这在学术坐标系中,是从“机械熟练度”向“人类级创造力”进阶的可控实验。
2. 痛点:被掩盖的“思维局限”
目前的数学大模型训练(SFT/RL)面临一个隐蔽的痛点:策略路径依赖。模型学会了通过大量采样来撞大运,或者是死磕某种固定流程(如暴力搜索、坐标转换)。
- Prior Work 的短板:现有的 GSM8K 太简单,MATH 复杂度不可控,导致我们无法看清模型到底是哪一环断了。
- 核心 Insight:数学推理的本质是 Boden 所定义的“创造性搜寻”。如果模型只能在已有的范畴内探索(Exploratory),而不能将散落的技能组合(Compositional),甚至不能在旧路不通时切换思维(Transformative),那它就永远无法达到数学家的水平。
3. OMEGA 架构详解:实验室里的数学考场
OMEGA 通过程序化生成确定的“训练-测试”对,实现了对泛化能力的精准拆解:
| 泛化维度 | 定义 | 示例 |
|---|---|---|
| 探索性 | 算法不变,规模增加 | 从八边形数数迁移到十二边形 |
| 组合性 | 1+1 > 2 的能力 | 同时运用 GCD 与多项式求根解决综合题 |
| 变革性 | 弃旧图新,思维跳跃 | 摒弃暴力穷举,发现对称性简便算法 |
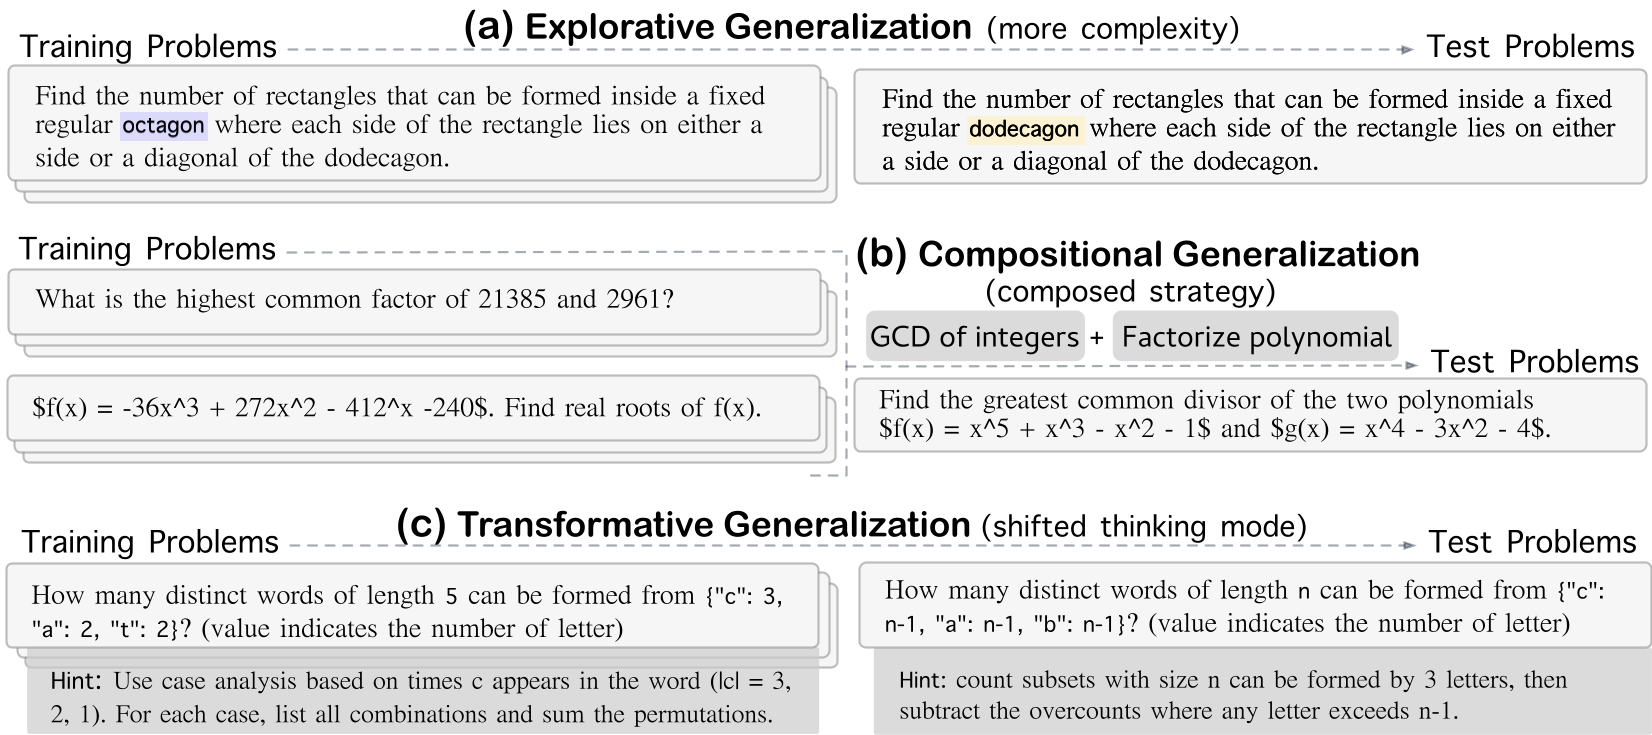 图 1:OMEGA 训练-测试对示例,展示了复杂度递增、技能集成和模式切换的三种场景。
4. 核心实验:当 CoT 变成“过度思考”的泥潭
研究人员测试了 DeepSeek-R1, Claude-3.7, GPT-o4-mini 等模型,发现了不少令人惊讶的现象:
- 性能崩塌:随着复杂度(Complexity Level)从 1 提升到 6,所有模型的准确率几乎同步归零。
- 思维螺旋(Error Spirals):在复杂题目中,模型常陷入“自我怀疑”。分析显示,模型经常在 CoT 的早期已经拿到了正确答案,但随后的“验证”步骤却引入了新的错误,最终把正确答案改错了。
- 由于“懒惰”导致的错误:在进行矩阵秩(Matrix Rank)计算时,高复杂度题目下模型显著减少了实际计算步数,而增加了“猜测(Conjecture)”,这说明模型在认知负荷过重时会倾向于偷懒。
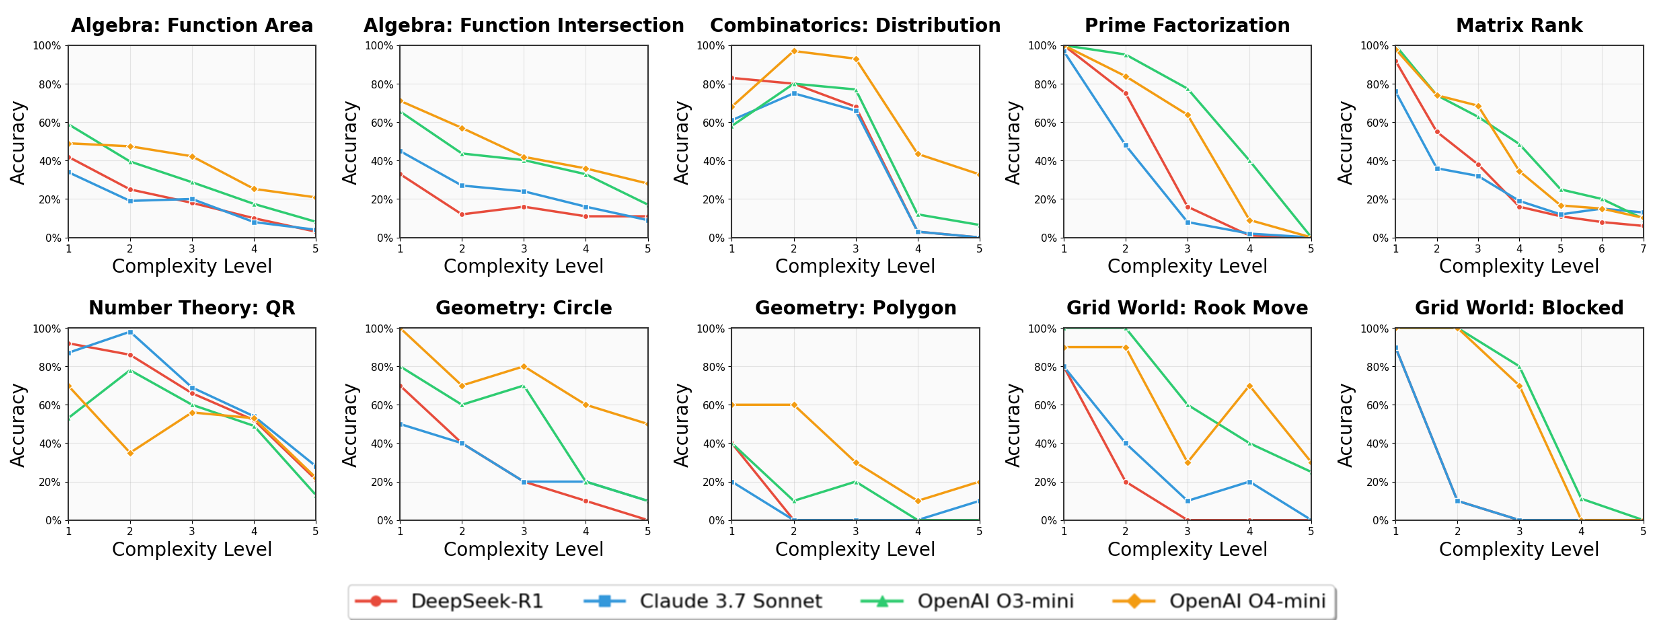 图 2:四大顶级 LLM 在 OMEGA 上的表现,可见复杂度是目前推理模型的头号杀手。
5. RL 的局限:能“熟能生巧”,不能“无中生有”
论文深入探讨了强化学习(RL)对泛化的贡献。
- Exploratory(有效):RL 在已知领域内提升显著,能让模型处理更复杂的同类题。
- Compositional(乏力):模型学会了 A,学会了 B,但在需要 A⊕B 的 OOD 任务上依然抓瞎。
- Transformative(失败):这是最令人沮丧的。RL 几乎无法让模型学会“换个思路”。甚至在某些任务中,RL 训练反而加强了模型对旧有搬砖套路的执念,导致性能倒退。
6. 深度洞察与总结
OMEGA 告诉我们: 目前的推理模型通过 RL 获得的性能提升,更多是一种“内插”式的增强,而非“外推”式的逻辑进化。模型在本质上仍然是强大的模式匹配器。
局限性分析: 尽管模型拥有超长上下文,但它们的“搜索空间”仍然被训练分布紧紧锚定。CoT 虽然给了模型思考的时间,但没能给它“反思策略有效性”的元认知能力。
未来展望: 我们要的不是能生成 10 万个 token 的模型,而是那个能在第 10 个 token 就意识到“此路不通,得换对称法”的聪明大脑。OMEGA 为通往这种真正的数学智能铺设了第一块基石。