
OMIBench:挑战 LVLM 的“多图奥赛”天花板
OMIBench: Benchmarking Olympiad-Level Multi-Image Reasoning in Large Vision-Language Model
本文推出了 OMIBench,这是一个专门评估多模态大模型(LVLMs)在奥林匹克竞赛级别、跨多图推理能力的基准测试集。该基准涵盖生物、化学、数学、物理四大领域,包含 1000 多个复杂问题,要求模型必须整合分布在多张图像中的证据才能解题。
TL;DR
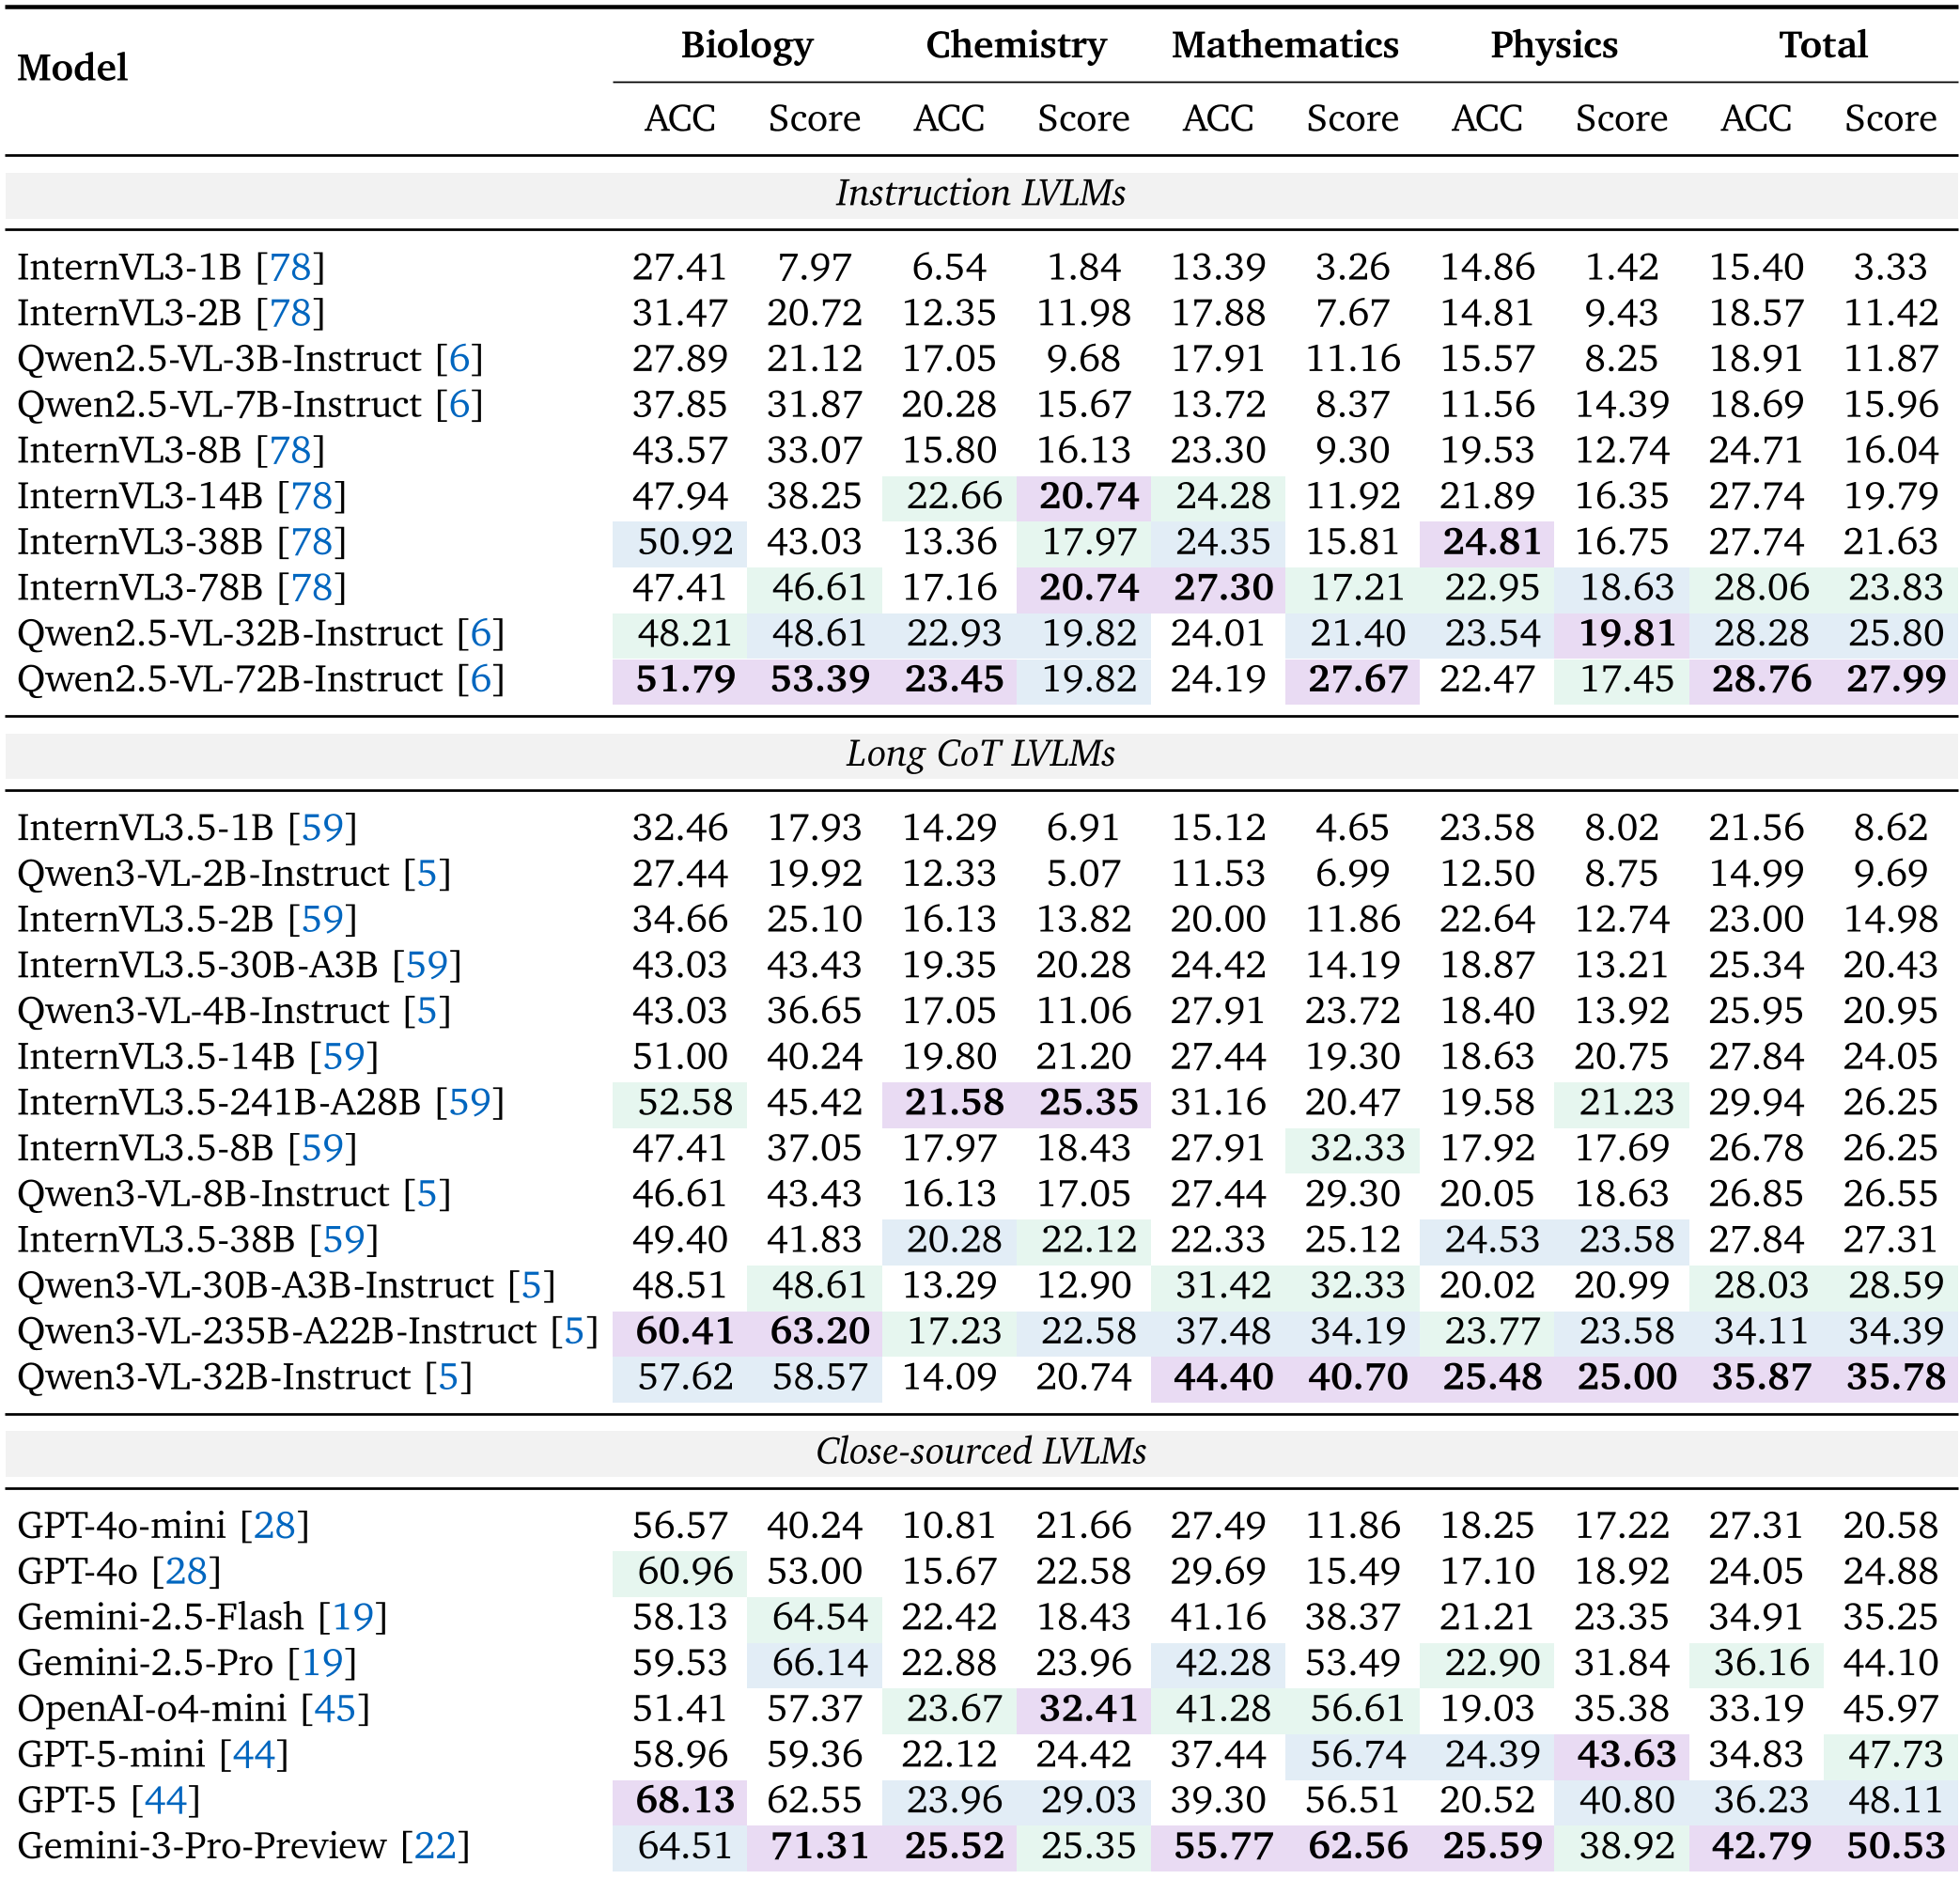
在人工智能逐渐攻克单图奥赛题目的今天,来自哈工大等机构的研究团队提出了 OMIBench。这不仅仅是一个新的数据集,它精准击中了当前大模型的软肋:跨图多步推理。实验结果令人警醒——即使是强如 Gemini-3-Pro 的尖端模型,面对需要整合多张实验图、几何图的竞赛题时,胜率也仅刚过半。
核心动机:模型从“看图说话”到“联想解题”的跨越
目前的 LVLM(多模态大语言模型)在处理单张图像的奥赛题目(如 OlympiadBench)时已经表现出了惊人的实力。但在现实的科学实验或复杂的数学证明中,证据往往分散在数张互相关联的图表、示意图和文本说明中。
作者发现,现有的多图基准测试(如 MMIU)大多偏向于感知(这张图里有什么),而不是逻辑耦合(图 A 指向的变量如何在图 B 中演化)。OMIBench 的出现,就是为了填补这个科学推理的“连线题”空白。
深度解析:多图推理的三个致命瓶颈
通过对失败案例的精细化审计,研究团队总结了 LVLM 在多图环境下的三大死穴:
- 视觉感知失真 (Visual Perception Failures):即使能看清,也可能在数字化过程中(如 OCR 噪声)丢失关键的几何约束。
- 跨图关联断裂 (Cross-Image Association Failures):占错误总数的 29%。模型无法在头脑中建立不同视图之间的空间映射。
- 逻辑谬误 (Logical Reasoning Fallacies):这是最严重的病灶,占比 41%。即便感知正确,模型在进行跨模态多步推导演算时,仍会发生严重的逻辑跳跃或计算偏离。
实验洞察:规模(Scale)不是唯一的解药
OMIBench 进行了一系列极具启发性的“压力测试”:
- 参数扩展 vs. 激活参数:研究发现,对于 MoE 模型(如 InternVL 系),单纯增加总参数量在 OMIBench 上会迅速进入平台期(如下图所示)。真正的提升源于增加推理时激活的参数量,这意味着多图奥赛题需要更强的实时算力支点。
- 关于“思考”的价值:启用 Long CoT(思考模式) 后的 Qwen3-VL 相比普通指令版本有约 10% 的提升,这远高于在单图基准上的收益。这说明多图推理更依赖于模型内核的“内部推演”。
专家视角:人类 baseline 的碾压
即便经过训练的非专家(大学生)在 OMIBench 上也能达到 60% 左右的准确率,而领域专家(博士生)则稳居 80% 以上。相比之下,目前的顶级模型仍存在 30 分以上的巨大鸿沟。
总结与未来展望
OMIBench 的研究结论是清醒且深刻的:现有的 Fine-tuning (SFT) 数据集在提升奥赛级多图推理上显得杯水车薪。
未来的突破口集中在:
- 更高质量的多图推理数据:目前行业极度缺乏类似这种“严丝合缝”逻辑耦合的训练语料。
- 架构进化:如何让模型在注意力机制层面就具备跨图对齐(Cross-image alignment)的本能,而非仅仅靠文本来桥接图像。
如果你还在追求 LLM 的单图 SOTA,OMIBench 提醒我们:真正的 AGI,必须学会在信息的碎片中拼凑出真理。