
CogDriver:赋予自动驾驶“认知惯性”,终结决策抖动
OmniReason: A Temporal-Guided Vision-Language-Action Framework for Autonomous Driving
本文提出了 CogDriver,这是一个旨在解决自动驾驶中“认知惯性”缺失问题的视觉-语言-动作(VLA)框架。通过引入包含叙事性标注的大规模数据集 CogDriver-Data 和具备稀疏时间记忆模块的 CogDriver-Agent,该方法在 Bench2Drive 闭环驾驶评分上提升了 22%,实现了更具时间连续性和物理连贯性的轨迹规划。
TL;DR
在自动驾驶追求全自动化的道路上,模型往往像一个“失忆症患者”:每一毫秒都在重新评估世界,导致频繁的决策犹豫和抖动。李未央、马莉等科研团队提出的 CogDriver 框架,通过引入认知惯性 (Cognitive Inertia) 的概念,利用大规模叙事性数据集和稀疏时间记忆模块,让 AI 像人类一样拥有连贯的驾驶意图。其在 Bench2Drive 榜单上将驾驶得分刷新了 22%,并大幅减少了无效的轨迹摆动。
背景定位:从“反应式”到“认知式”的跨越
目前的端到端自动驾驶模型大多属于刺激-相应 (Stimulus-Response) 机制。即便使用了多模态大模型(VLM),它们也常被困在“永恒的现在”中。比如在超车时,模型可能因为一瞬间的邻道车辆靠近就立刻放弃计划,下一秒又重新尝试,这种缺乏连贯性的行为在高速场景下极其危险。CogDriver 的核心贡献在于,它将驾驶从单纯的感知任务提升到了具有时间连续性的认知任务。
挑战:为何现有模型会“反复横跳”?
- 数据集断层:现有的驾驶数据集(如 nuScenes, DriveLM)大多提供的是单帧的推理(Rationale),缺乏一个“连续的为什么”。
- 时空表示不稳定:模型对周围个体的追踪容易因遮挡或自身运动而丢失,导致内部世界模型频繁重置。
核心技术:CogDriver 的两大支柱
1. CogDriver-Data:会讲故事的数据集
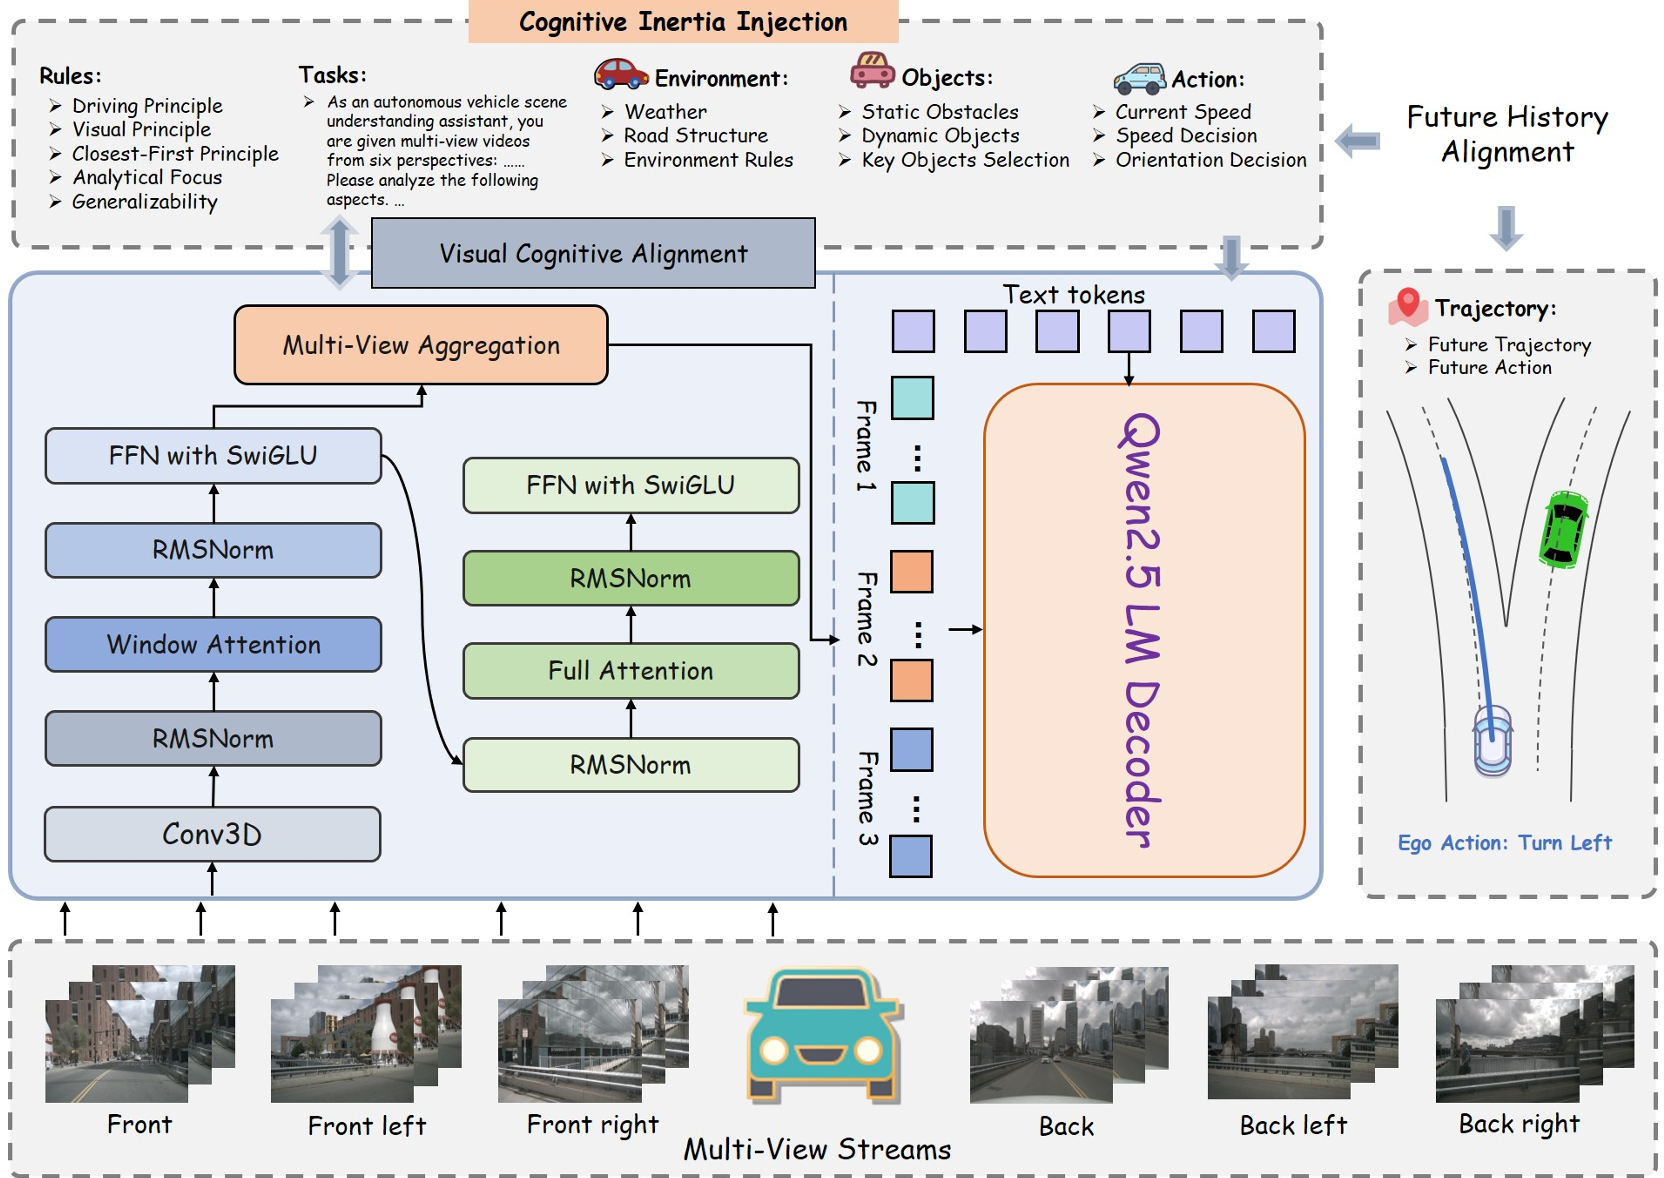
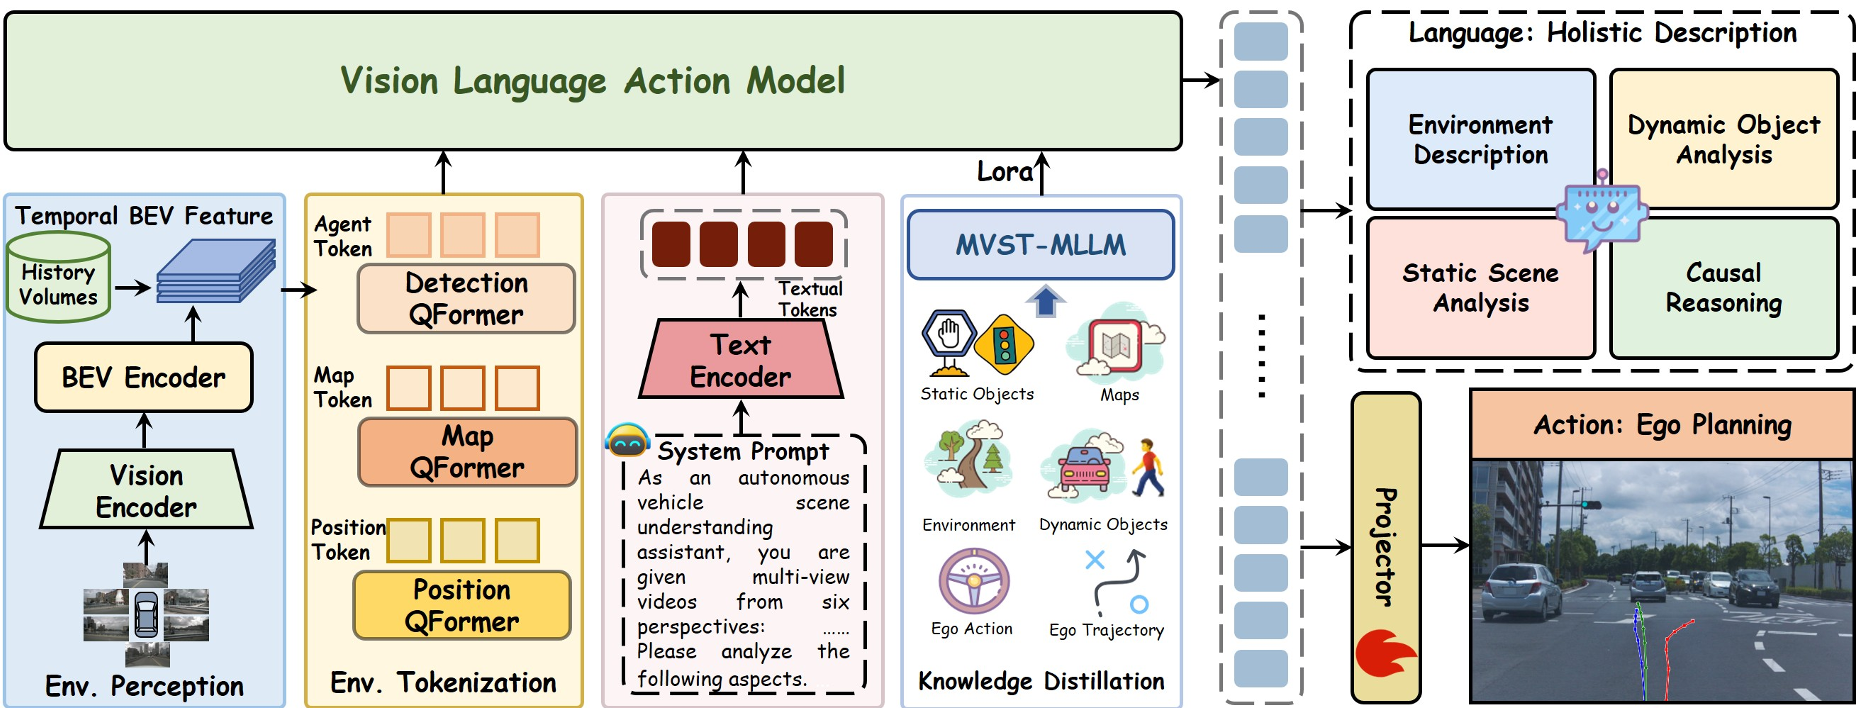
作者开发了一个 Multi-View Spatiotemporal MLLM (MVST-MLLM) 标注流水线。它不仅仅记录“此时有车”,而是生成一段描述意图演化的叙事 (Narrative)。这种标注方式强迫模型学习因果逻辑,例如:“我正在左转(长期目标),虽然前车减速(短期扰动),但我应保持转弯意图并观察路口(决策持久性)”。
2. CogDriver-Agent 与时间相干模块 (TCM)
为了在推理时维持这种惯性,CogDriver-Agent 引入了时间相干模块 (TCM)。该模块不同于传统的简单堆叠历史特征,它包含三个精妙步骤:
- 几何传播 (Geometric Propagation):利用自身运动补偿(Ego-motion),将历史目标位置投影到当前坐标系。
- 运动感知的状态细化:根据车速和时间差动态调整特征权重。
- 证据融合:通过 Self-Attention 将历史“信念”与当前“感知”进行校准。
实验战绩:全方位 SOTA
CogDriver 在 Bench2Drive 闭环测试中展现了统治力:
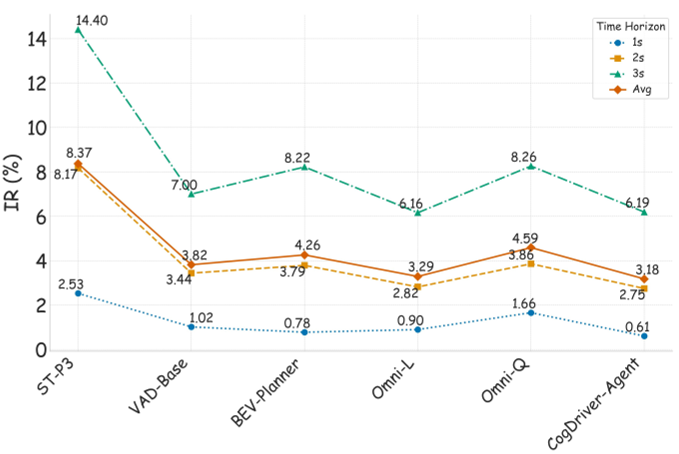
- Success Rate: 提升了惊人的 63% 相对比例,证明长程规划稳健性。
- L2 Error: 在 nuScenes 上达到了 0.34m,这是目前公开文献中的最优水平。
- 推理效率: 在 A800 上实现了约 3400 tokens/s 的输入处理速度,远超 Qwen 等通用大模型。
深度洞察:为什么这种方法更接近人类?
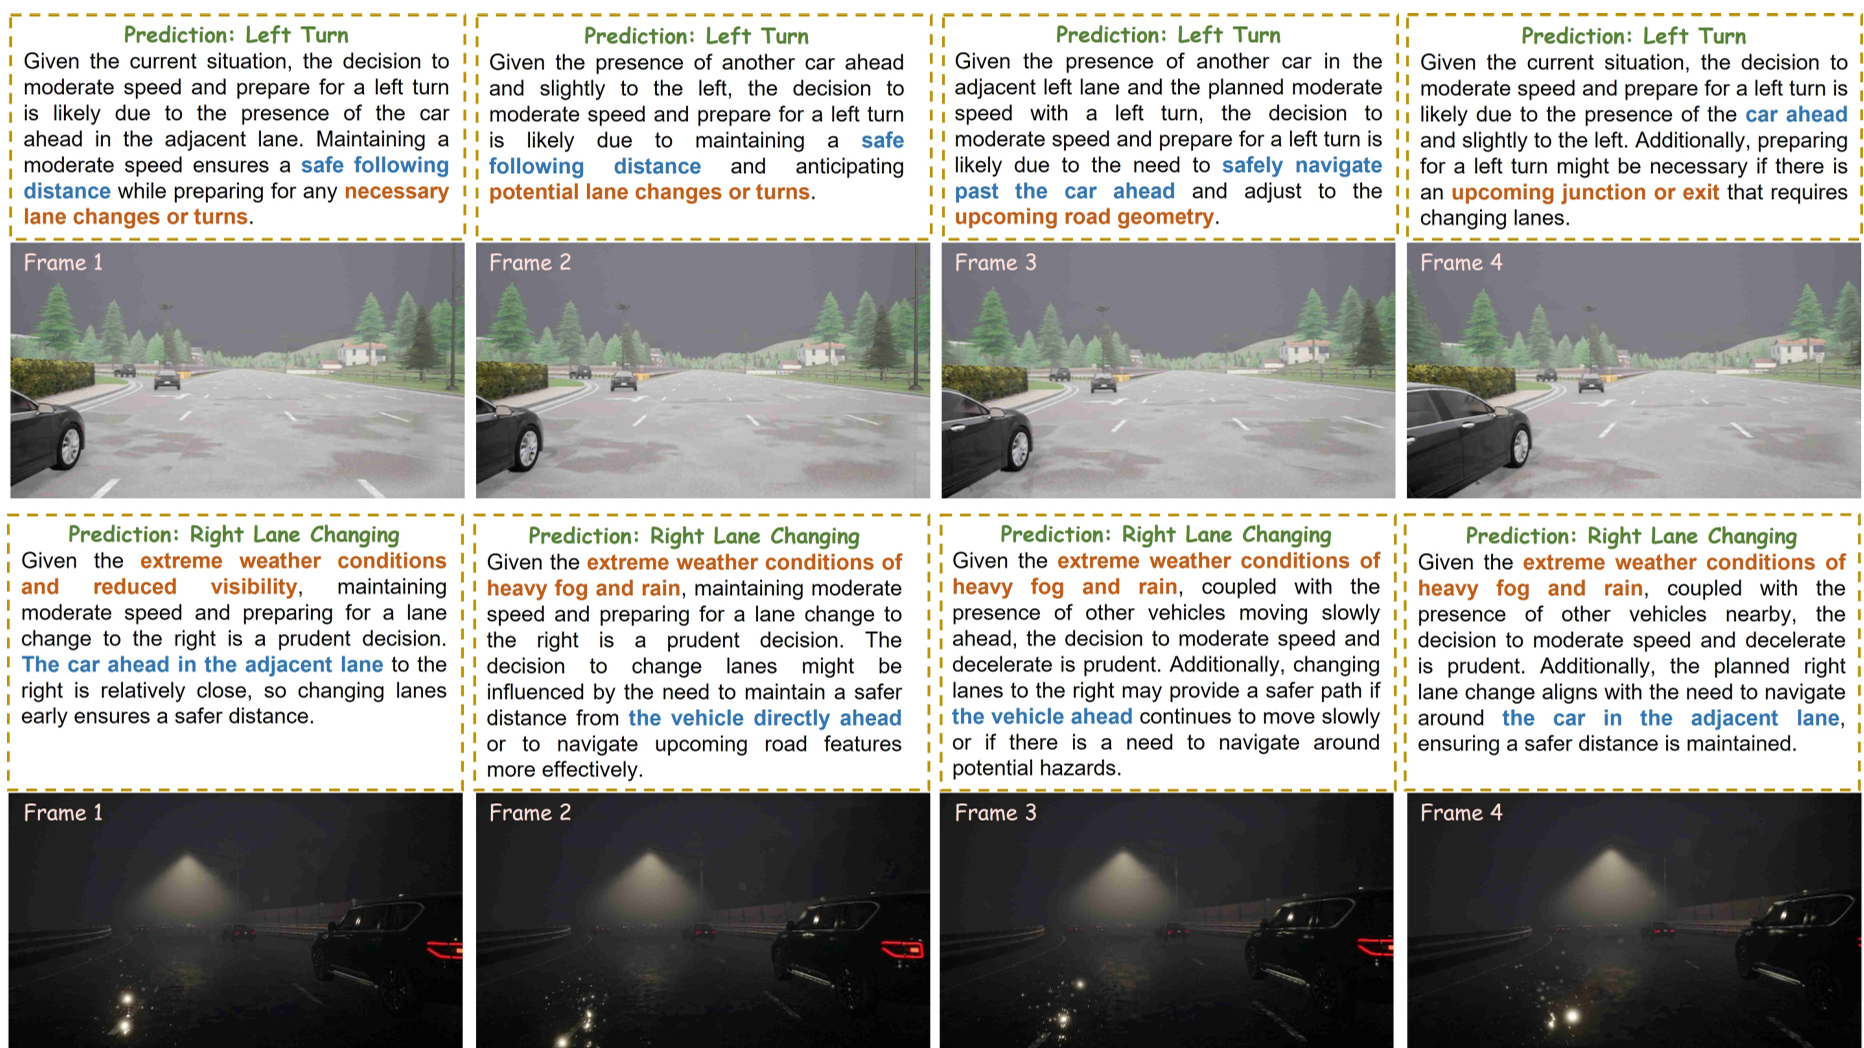
通过可视化分析(Figure 4),我们可以看到 CogDriver-Agent 的推理过程是演进性的。在左转场景中,它的推理从最初的“关注前车”逐渐成熟为“预测路口情况”,而高层指令“Left Turn”始终保持稳定。这种从反应到战略的转变,正是认知惯性的直观体现。
总结与局限
CogDriver 证明了 VLA 模型在自动驾驶中不仅要“看得清”,更要“想得深且稳”。
- 优点:显著降低了长程规划中的决策风险,推理速度极快。
- 局限:目前的认知惯性主要依赖于 TCM 模块和叙事标注,对于极端罕见(Corner Cases)场景下的意图切换(如突然出现的紧急避障与原有超车目标的冲突)仍需更复杂的防御机制。
这项工作标志着自动驾驶正从“像素预测”时代,真正迈向“认知理解”时代。