
CRISP:拒绝“废话”,让推理模型在自我蒸馏中进阶
On-Policy Self-Distillation for Reasoning Compression
本文提出了 CRISP,一种基于迭代自策略蒸馏(Iterative Self-Policy Distillation)的推理模型压缩方法。该方法通过将附带“简洁指令”的模型作为教师,蒸馏给不带指令的学生模型,在 Qwen3 系列模型上实现了 57%-59% 的 Token 削减,并在 MATH-500 任务中将准确率大幅提升了 9-16 个百分点。
TL;DR
在推理大模型(Reasoning Models)时代,模型学会了“先思后行”,但代价是极度的冗余。本文提出的 CRISP (Compressed Reasoning via Iterative Self-Policy Distillation) 证明了一个惊人的事实:通过让模型“向更简洁的自己学习”,不仅可以减少近 60% 的推理耗时,还能显著提升解题准确率。
痛点深挖:聪明模型的“强迫症”
当前的 SOTA 推理模型(如 OpenAI o1, DeepSeek-R1, Qwen3)在处理复杂数学题时表现惊人,但它们似乎患上了“强迫症”:即便问它 等于几,它也可能在 <think> 标签里推理几百个 Token。
目前的压缩方案主要有三条路径,但各具缺陷:
- 强化学习 (RL) + 长度惩罚:必须有 Ground-truth 答案才能训练,且容易导致模型在处理难题时因“不敢多想”而性能崩塌。
- 监督微调 (SFT):在他人精简后的数据上训练,容易产生分布偏移(Distribution Shift),让模型变傻。
- Prompt 工程:效果随提示词消失,且压缩粒度不可控。
CRISP 的直觉逻辑:模型其实知道如何简洁,只是没被允许。通过给模型一个“Be concise”的指令,它就能瞬间切换到简洁模式。CRISP 的核心就是把这种模式“内化”到模型权重中。
Methodology:化繁为简的自蒸馏机制
CRISP 的流程可以用一句话概括:在不改变模型固有逻辑的前提下,利用指令诱导出的简洁分布作为教师,指导原始模型的输出。
1. 核心架构与公式
CRISP 最小化学生模型(不带指令)与教师模型(带简洁指令 )之间的每 Token 逆向 KL 散度:
2. 为什么是 Reverse KL?
作者强调,方向至关重要。Reverse KL 是“模式寻找型”的,它惩罚学生模型在教师模型认为低概率的地方浪费 Token。这能有效保持推理的 Entropy(熵),防止模型像 RL 方法那样陷入崩塌。
3. 教师权重的迭代更新 (Iterative Refresh)
如果教师模型一直静止,学生很快就会学到天花板。CRISP 每隔 步将学生权重同步给教师。这样教师也会变得越来越精练,形成一种“长江后浪推前浪”的进化效应。
实验战绩:Less is More 的奇迹
1. 准确率与长度的双重突破
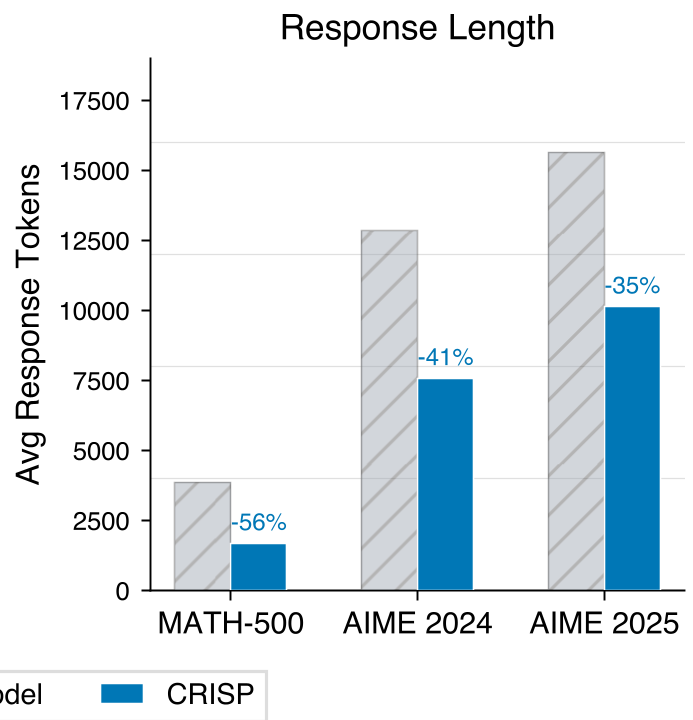
在 Qwen3 系列模型上的表现令人印象深刻。最令人反直觉的结果是:Token 变少了,准确率反而变高了。
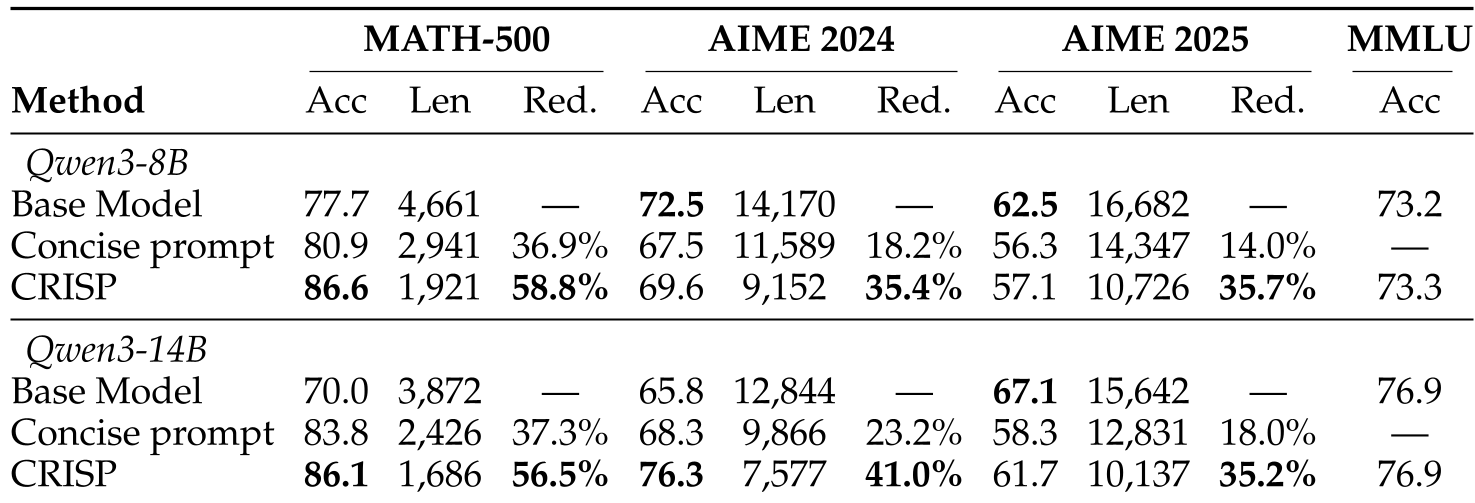
- 成绩单:在 MATH-500 上,Qwen3-14B 的准确率从 70% 飙升至 86.1%,同时推理长度缩减了 56.5%。
- 误差累积理论:作者给出了逻辑解释——推理链路越长,每一步引入微小误差并导致最终崩盘的概率就越大。清理掉那些“顾左右而言他”的噪声,反而保护了逻辑链条的完整性。
2. 难度自适应 (Difficulty-Adaptive)
CRISP 表现出极强的智能:对于简单题目(如 MATH),它大幅压缩;对于 AIME 这种竞赛级难题,它保留了充足的 deliberation(权衡)空间。
深度洞察:为什么这种方法更优?
- 无需标注 (Ground-truth Free):这是 CRISP 最大的工业价值。因为它不需要知道题目的正确答案,只需要模型自己对自己“解释得更短”,这意味着它可以利用海量的无标签数据进行无监督压缩。
- 通用性 (Generalization):实验显示,该方法不仅在数学上有用,在 DeepPlanning 智能体规划任务中同样有效,证明了“简洁逻辑”是通用智能的一部分。
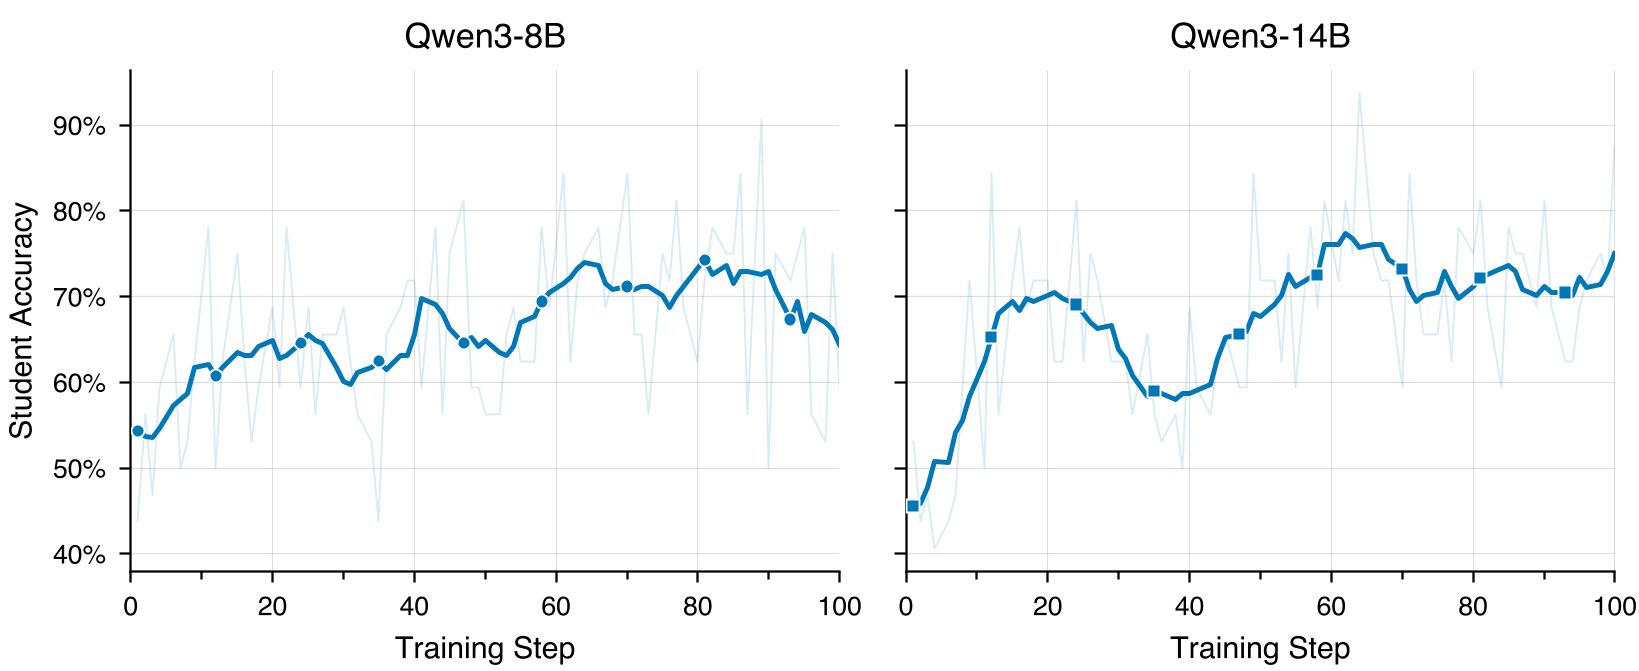
- 稳定性:消融实验证明,M = 40~60 步的更新频率最稳定。如果每步更新教师(M=1),模型会迅速陷入崩溃。
总结与启示
CRISP 告诉我们:verbosity(冗长)并不等于算力溢水后的谨慎,它往往是思维噪声的堆积。
对于未来的 AI 产品开发者而言,这提供了一个低成本的推理加速方案:不需要复杂的奖励模型,不需要海量的金牌解析数据,只需要通过一次精巧的自蒸馏,就能让笨重的推理模型变得既快又准。
局限性:CRISP 依赖于模型本身有一定的指令遵循能力(能够理解并执行“Be concise”)。对于极小参数的模型,由于无法理解简洁指令,该方法的效果可能会打折扣。