
OneVL:一步式潜空间推理,让自动驾驶告别推理延迟
OneVL: One-Step Latent Reasoning and Planning with Vision-Language Explanation
本文由小米机器人实验室提出 OneVL,一种用于自动驾驶的一步式多模态潜空间推理与规划框架。通过引入视觉与语言双重辅助解码器,OneVL 在保持极低推理延迟的同时,实现了超越显式 Chain-of-Thought (CoT) 的规划精度,在 NAVSIM 等四个主流基准测试上刷新了 SOTA 记录。
TL;DR
小米具身智能团队推出的 OneVL 成功解决了自动驾驶大模型中“推理性能”与“响应速度”不可兼得的难题。它通过将复杂的推理过程压缩进几个 Latent Tokens,并利用 语言 CoT 和 视觉世界模型 双重监督,实现了在“全速”运行的同时,规划精度首次超越了传统的“慢速”显式推理模型。
痛点与动机:为什么之前的推理模型都不行?
在自动驾驶领域,Chain-of-Thought (CoT) 虽好,但它像个话痨:必须一个字一个字吐出推理逻辑,才能给出最终轨迹,这在需要实时响应的驾驶场景中是致命的。
前人曾尝试使用潜空间(Latent Space)来“快进”这个过程,但效果惨不忍睹。作者发现,现有的潜空间方法(如 COCONUT, SIM-CoT)大多只盯着文字看,忽略了自动驾驶本质上是一个时空动力学问题。如果潜空间里没有对未来路况、障碍物运动的物理直觉,光靠语言预测是不可能开好车的。
核心机制:Language + World Model 双重验证
OneVL 的精髓在于它不只是“想”,还在不停地“看”和“预测”。
1. 架构创新:双头辅助解码器
模型在 LLM 输出层后面挂了两个训练时的“外挂”:
- 语言辅助解码器 (Dl):确保 Latent Tokens 里存着人能看懂的驾驶逻辑。
- 视觉辅助解码器 (Dv):这是一个浓缩的世界模型,它要求 Latent Tokens 必须能预测出未来 0.5s 和 1.0s 的交通实景。
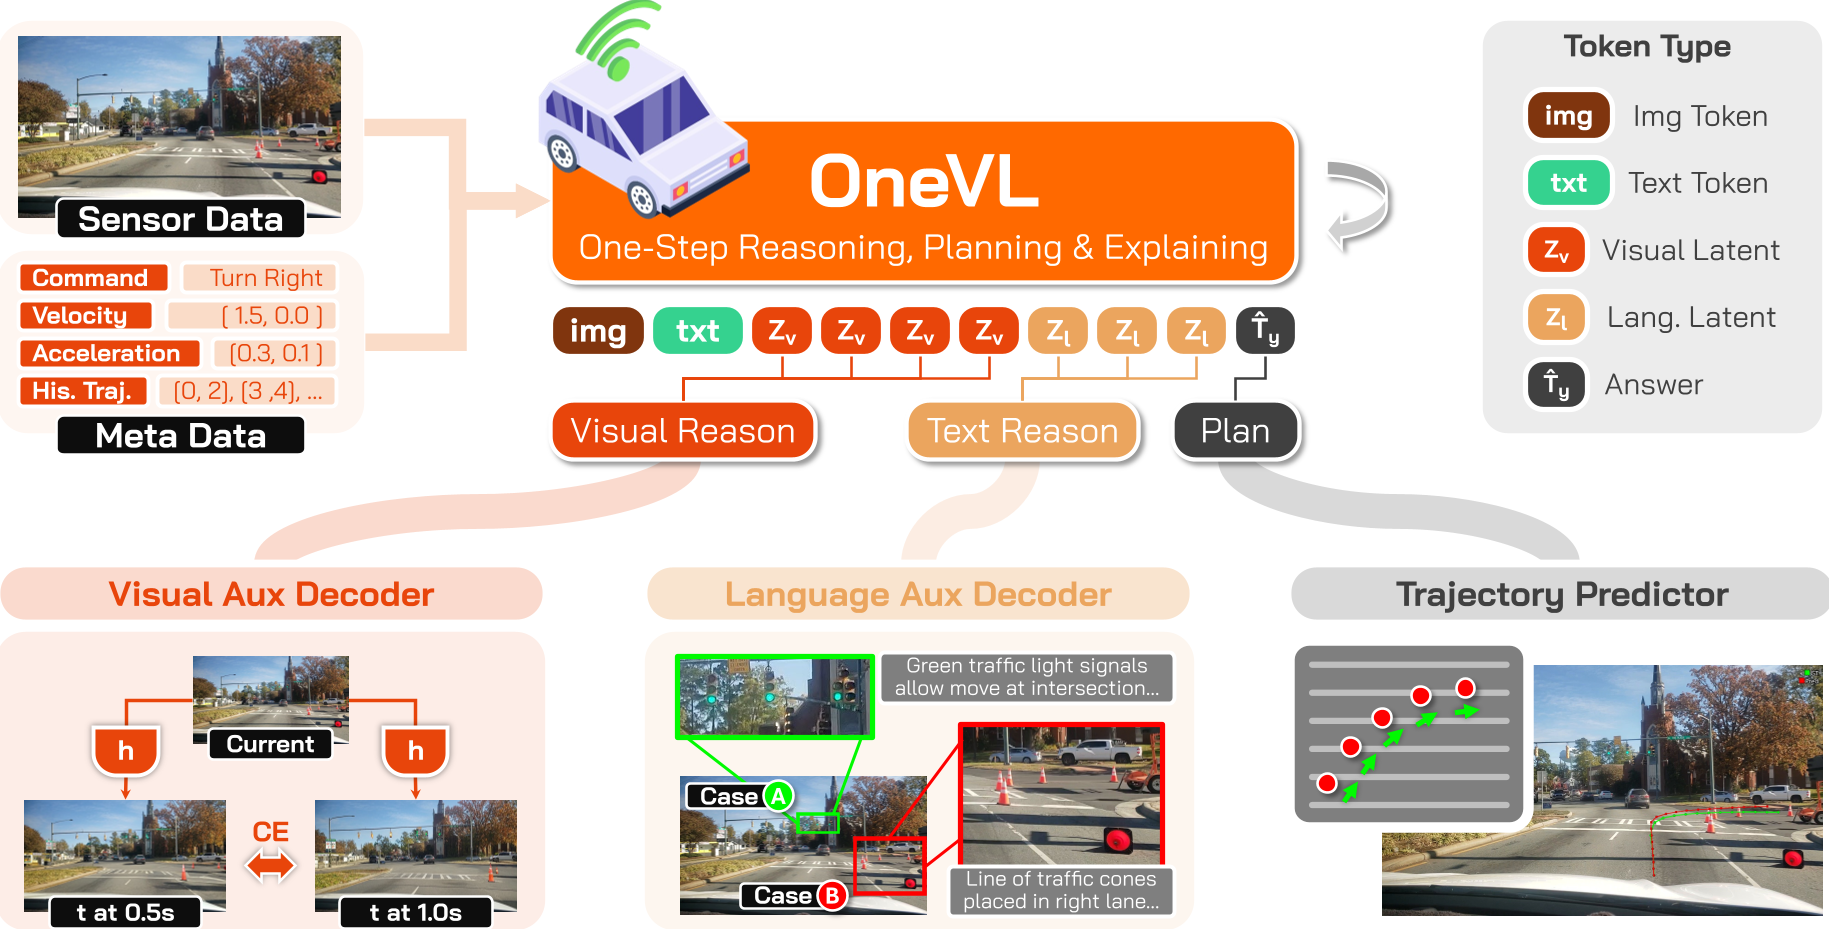
2. Prefill Inference:掩耳盗铃般的加速
这是实现低延迟的关键。在推理阶段,OneVL 丢弃了所有的辅助解码器。由于 Latent Tokens 是在输入前缀(Prefill)阶段以固定长度插入的,Transformer 的并行特性使得处理这些 Token 的时间成本几乎为零。
实验结果:既要、又要、还要
OneVL 在 NAVSIM、ROADWork 等四个高难度测试集中展现了压倒性优势。
- 性能制霸:在 NAVSIM 上,OneVL 跑出了 88.84 分,不仅超过了所有潜空间方法,还超过了需要几秒钟慢慢生成的显式 CoT 模型。
- 极速响应:推理延迟与最简单的 Answer-only 模式完全一致(约 4.46s),比显式 CoT 快了近 50%。

深度洞察:为什么视觉监督是“大杀器”?
消融实验给出了一个非常有趣的结论:视觉世界模型的监督作用(+0.87)远强于语言监督(+0.31)。
这意味着对于自动驾驶而言,与其教模型如何用漂亮的话解释路况,不如教它预测下一步障碍物在哪。视觉预测迫使潜空间捕获了底层的因果几何关系,这种“物理直觉”才是提升泛化能力的核心。
总结与局限
OneVL 为 VLA 架构提供了一个教科书级的思路:推理不一定要说出来,但一定要受物理世界的规律约束。
局限性:虽然精度极高,但目前的轨迹生成仍依赖于自回归采样,对于更极端的高频控制需求,论文提到可以结合 MLP Head 将延迟进一步压低至 0.24s,这为真正的实车部署留下了广阔的想象空间。