
OMatG-IRL:突破流匹配模型限制,开启晶体生成的高效率强化学习时代
Open Materials Generation with Inference-Time Reinforcement Learning
本文提出了 OMatG-IRL,一种针对连续时间流匹配(Flow-based)生成模型的强化学习框架。该方法首次将策略梯度(Policy-gradient)RL 应用于晶体结构预测(CSP)任务,并实现了在不依赖显式 Score 推导的情况下对速度场(Velocity field)进行直接优化。
TL;DR
传统的生成模型强化学习往往是扩散模型(Diffusion Models)的专利,因为它们需要 Score 函数来计算策略梯度。本文介绍的 OMatG-IRL 成功突破了这一限制,将强化学习引入了基于流匹配(Flow-matching)的材料生成领域。通过在推理阶段引入随机扰动,该方法不仅让模型生成的晶体结构能量更低(更稳定),更将推理速度提升了 10~20 倍。
背景定位:生成式材料设计的“最后一公里”
在反向材料设计(Inverse Materials Design)中,我们不仅希望模型能生成“长得像”晶体的结构(即学习分布密度),更希望它能生成“好用”的结构(即针对特定性质如能量、带隙进行优化)。强化学习(RL)是解决这一对齐问题的利器。然而,目前材料领域 SOTA 的模型多基于 Stochastic Interpolants (SI) 或流匹配,这些模型推理快但缺乏 RL 所需的数学反馈信号。
痛点深挖:速度场(Velocity Field)与强化学习的断层
扩散模型通常学习的是概率密度的梯度(Score),这与策略梯度法天然契合。但流匹配模型学习的是粒子运动的速度 。
- 核心困难:如果你只有确定的速度,就没有“探索”(Exploration),也就无法计算策略更新前后的比率。
- 现状:先前的研究(如 Flow-GRPO)试图在数学上建立速度与 Score 的联系,但这种转换仅适用于高斯分布等简单情况,无法处理晶体这种具有周期性坐标(Periodic Coordinates)的复杂流。
核心机制:OMatG-IRL 的“神来之笔”
作者提出了一种极具工程直觉的方法:推理时随机代理过程。
1. 速度场上的随机探索
作者发现,在预训练的确定性 ODE 轨迹中加入极小的噪声,并不会破坏模型原本生成的质量。
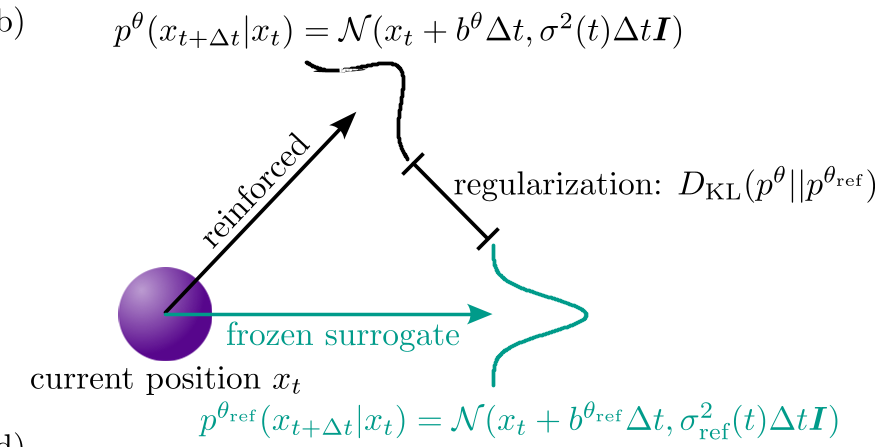 如上图所示,通过在 Euler 积分步骤中加入 ,作者人为构建了一个“代理策略”。这个策略允许模型进行随机采样,从而利用 GRPO (Group-Relative Policy Optimization) 比较同一成分下不同结构的能量高低,进而更新 Backbone 权重。
2. 可学习的速度退火 (Velocity Annealing)
晶体生成通常需要数十次甚至上百次迭代来优化原子位置。作者引入了一个随时间变化的标量函数 来对速度进行重缩放。这相当于给生成过程装了一个“自动变速箱”。
实验与结果:降维打击般的采样效率
能量对齐性能
在晶体预测(CSP)任务中,OMatG-IRL 成功降低了生成结构的能量(约 0.5 eV/atom),这意味着生成的晶体在热力学上更稳定。
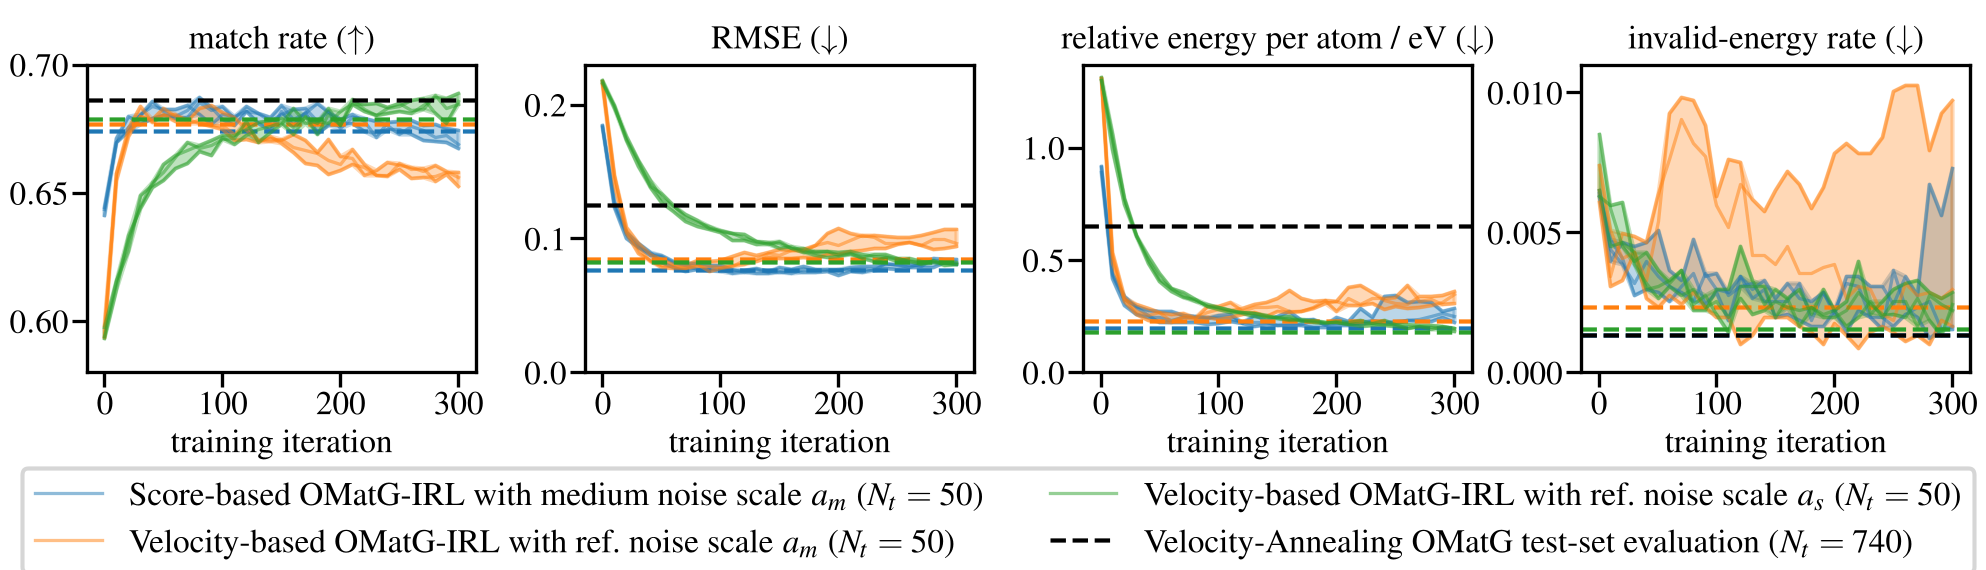
极速推理
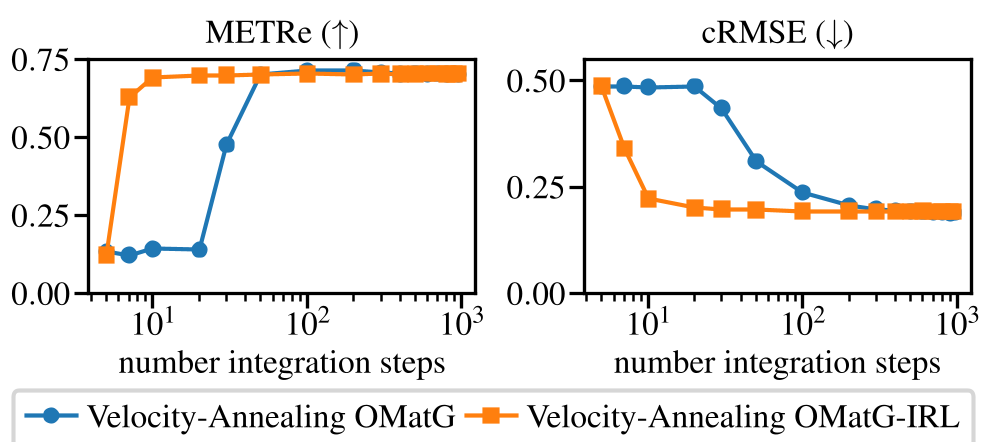
最令人惊叹的是对采样步数的压缩。传统的 OMatG 需要 740 步以上的积分才能达到高精度。而经过 RL 优化退火方案后,仅需 10-50 步即可达到甚至超过原先 SOTA 的表现(见下图趋势)。
深度洞察:为什么这很重要?
- 脱离 Score 的束缚:该工作证明了对于流匹配模型,我们不需要复杂的数学推导去逼近 Score,简单的“扰动-对比-学习”闭环就能获得极佳效果。
- 多样性自平衡:在 DNG(从头开始生成)中,RL 常面临模式崩溃问题。但在 CSP 任务中,成分约束(Composition Conditioning)天然地提供了归纳偏置,保护了生成结果的多样性。
- 计算成本的“摊销”:通过 RL 将部分能量优化逻辑内化到生成路径中,可以显著减少后期昂贵的 DFT 弛豫步数。
总结与挑战
OMatG-IRL 为材料科学领域的生成式 AI 提供了一套通用的“提速对齐”方案。尽管它目前主要针对连续坐标,但其展示的基于代理 SDE 的 RL 范式,完全可以扩展到其他领域(如氣象預測、蛋白質設計)。
局限性:由于使用的是代理过程,如果加入的噪声过大,可能会导致偏离原始数据分布,因此对噪声 Schedule 的超参数选择仍需谨慎。