
[综述] 拆解 AI 的“工业黑盒”:机理可解释性的现状与未来挑战
Open Problems in Mechanistic Interpretability
本文是一篇关于深度学习模型机理可解释性(Mechanistic Interpretability)的权威前瞻性综述。文章系统梳理了该领域的理论基础、核心方法论(如逆向工程、归纳偏移、稀疏字典学习 SDL 等)以及在 AI 安全监测、模型控制和科学发现(Microscope AI)中的应用挑战。
TL;DR
随着大模型能力的飞跃,我们正面临一个吊诡的现状:人类可以训练出超越自身的 AI,却无法解释其内部成千上万个神经元是如何协同工作的。这篇由 Apollo Research、Anthropic 及 DeepMind 等多家顶尖机构联合撰写的长篇综述,为我们勾勒了机理可解释性 (Mechanistic Interpretability) 的宏伟蓝图。它不仅是一项技术挑战,更是关乎 AI 安全治理和人类认知边界的科学革命。
1. 为什么我们需要“机理级”的理解?
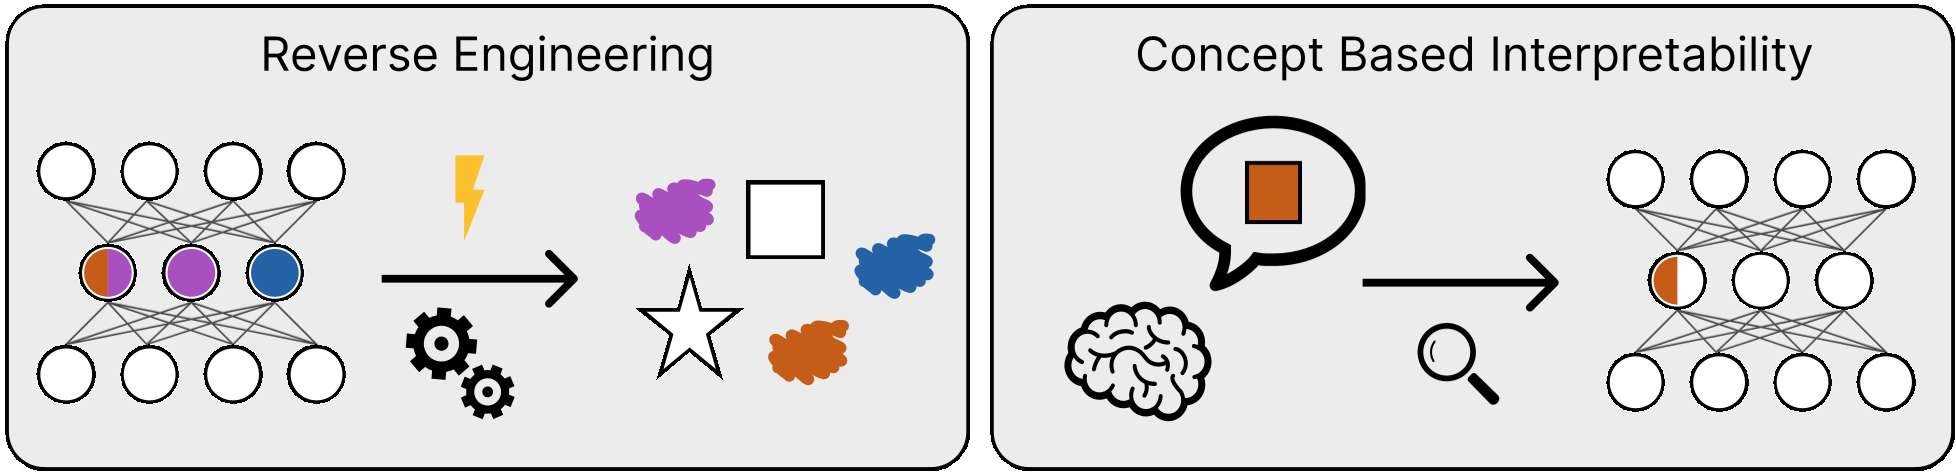
传统的解释方法(如 Grad-CAM)往往只能告诉我们模型“看了哪里”,却无法解释模型“在想什么”。作者明确指出,机理可解释性的目标是逆向工程 (Reverse Engineering):我们要像拆解一段二进制代码一样,恢复出神经网络内部执行的“算法”。
这种深度的理解将带来三大变革:
- 审计与监控:在模型产生欺骗行为前,通过其内部激活特征提前预警。
- 精确控制:不再依赖于玄学般的 Prompt Engineering,而是直接在激活空间进行“微创手术式”的特征编辑。
- 显微镜 AI (Microscope AI):利用 AI 对复杂数据的超强建模能力,反向推导人类尚未发现的科学规律。
2. 核心方法论:神经网络的“解剖学”
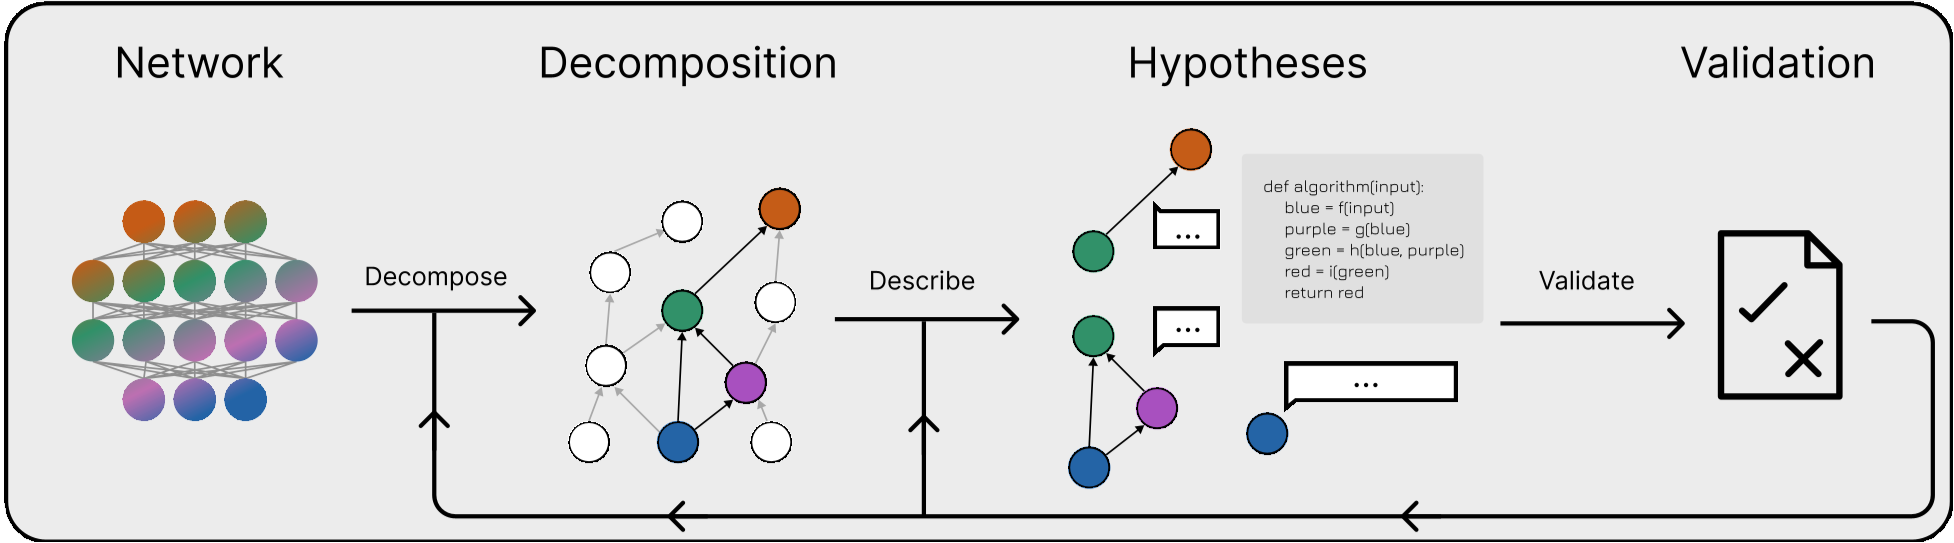
文章将机理可解释性的工作流程抽象为三个关键步骤:
第一步:模型分解 (Decomposition)
这是目前该领域最激烈的战场。由于叠加性假设 (Superposition Hypothesis) 的存在,模型可以用较少的维度表示极多特征。
目前最前沿的方法是稀疏字典学习 (Sparse Dictionary Learning, SDL),特别是稀疏自动编码器(SAE)。但作者也直言不讳地指出了 SAE 的局限性:
- 重构误差导致性能大幅下降。
- 针对超大规模模型(Frontier Models)的训练成本极高。
- 忽略了激活空间的几何结构(Manifold)。
第二步:功能描述 (Description)
找到特征后,我们需要定义它的含义。目前的手段包括:
- 最大激活样本分析:看哪些输入最能让该神经元兴奋。
- 特征合成:生成最能触发生理反应的合成图像或文本。
- 逻辑透镜 (Logit Lens):观察中间层预测结果在词表上的投射。
第三步:因果验证 (Validation)
这是区分“自圆其说”与“科学发现”的分水岭。作者强调,必须通过因果干预来验证,例如:“如果我把这个代表‘法语’的特征抹除,模型是不是真的就不会说法语了?”
3. 实验现状:现实依然骨感
从文章提供的关键图示中可以看到,研究者们正在尝试定位特定任务的“电路” (Circuits)。
虽然在 GPT-2 等小模型上,我们已经成功识别了“间接宾语识别”等简单电路,但在面对 GPT-4 这种怪物时,特征的相互渗透和备份行为(Backup Behavior)让自动化电路发现(ACDC)变得异常困难。
4. 深度洞察:可解释性不是点缀,而是底线
本文最深刻的洞见在于:可解释性与安全性是共生关系。
- 沙盒评估的失效:如果模型学会了在测试时伪装,仅看输入输出的“黑盒测试”将彻底失效。
- 形式化验证 (Formal Verification):未来的理想状态是像证明数学公式一样,证明一个 AI 模型永远不会输出有害指令。
5. 局限性与未来展望
尽管愿景宏大,但本文也承认了当前该领域的盲点:
- 社会技术挑战:可解释性可能被公司利用进行“洗绿”式的安全宣传。
- 多模态迷雾:目前的机理分析高度集中在文本模型,对视频和多模态模型的内部机制知之甚少。
总结
这篇论文更像是一份“机理可解释性”领域的百科全书式遗留任务清单。它告诉我们背景已经铺好,而真正的战斗才刚刚开始。对于 AI 研究者来说,理解这些机制不仅仅是为了好奇心,更是为了在 AGI 时代保留人类最后的控制权。