
LS-Imagine:突破“近视”困境,开放世界视觉强化学习的跳跃式想象
Open-World Reinforcement Learning over Long Short-Term Imagination
本文提出了 LS-Imagine,一种面向开放世界(如 Minecraft)的视觉模型基础强化学习(MBRL)方法。核心通过构建“长短期世界模型”,引入跳跃式状态转移(Jumpy Transitions)和能力图(Affordance Maps),在不显著增加计算步数的前提下极大地扩展了智能体的想象视野,显著提升了长程任务的探索效率。
TL;DR
在《Minecraft》这样的开放世界中,传统视觉强化学习智能体(Agents)往往是“短视”的。即使是顶尖的 DreamerV3,也只能根据未来 15 步的想象进行决策。本文提出的 LS-Imagine 通过一种创新的**长短期想象(Long Short-Term Imagination)**机制,让智能体学会在脑海中进行“时空跳跃”,直接跨越繁琐的中间步骤预见长程目标。这不仅提升了样本效率,更在 MineDojo 任务中打破了多个性能基准。
1. 痛点:为什么 Agent 会“近视”?
在开放世界中,决策空间巨大且奖励极其稀疏。现有的模型基础强化学习(MBRL)主要依赖于**世界模型(World Model)**进行一步一预测的想象。
- 深度代价:如果要想象 100 步后的效果,累积误差会让预测变得一团糟。
- 广度迷失:智能体不知道该往哪儿看,面对浩瀚的像素世界,它缺乏对“目标”的物理直觉。
- 短视策略:因为想象序列太短,智能体往往只关注眼前利益,无法执行需要长期规划的任务(如长途跋涉去砍一棵特定的树)。
2. 核心直觉:在脑海中“瞬间移动”
LS-Imagine 的作者 Jiajian Li 等人提出:既然一步步预测太累,为什么不教模型学会“跳跃”?
2.1 Affordance Map:视觉的指路明灯
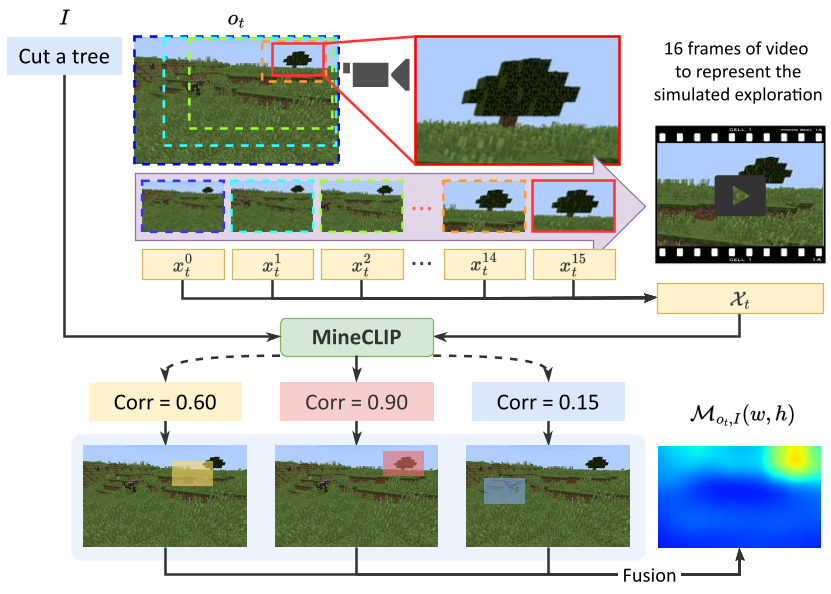
作者引入了 Affordance Map(能力图)。其直觉非常精彩:通过对当前图像进行局部的“缩放(Zoom-in)”处理,模拟智能体正在靠近某个目标的伪视频流。通过预训练的 MineCLIP 评估这些经过缩放的片段与文本指令(如 “Cut a tree”)的相关性,从而在原始图像上标注出哪些区域具有更高的“探索价值”。
2.2 长短期世界模型架构
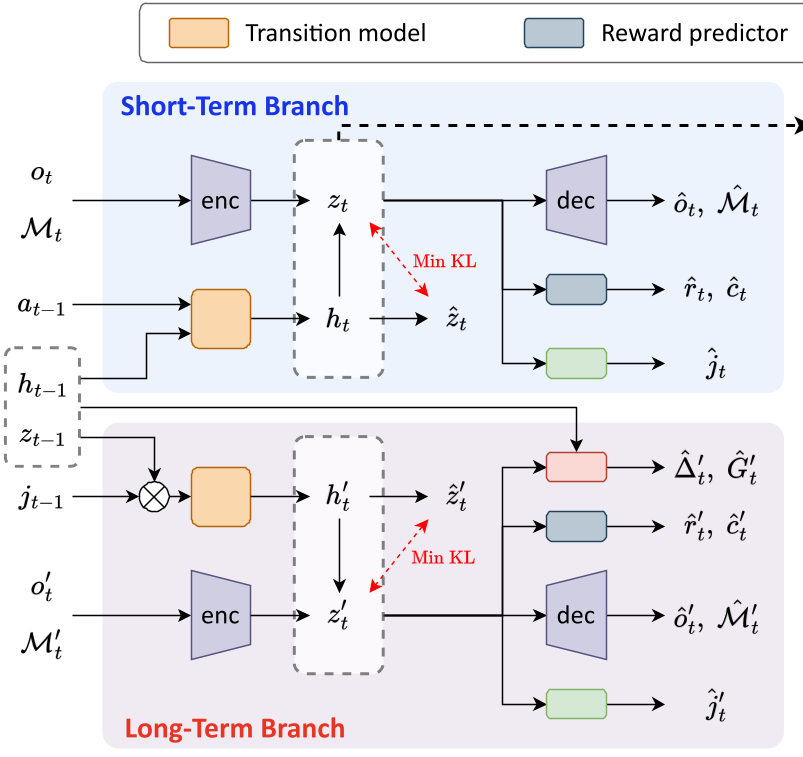
模型不再只做单步预测。它通过一个 Jumping Flag 判断当前是否看到了关键目标。
- 短期分支 (Short-term):传统的单步状态转移。
- 长期分支 (Long-term):一旦触发跳跃标志,模型直接预测若干步后的隐状态 ,并预估这段时间内能拿到的累积收益 。
3. 混合想象:让策略更具前瞻性
在行为学习(Behavior Learning)阶段,智能体在 Latent Space 中进行演练。 LS-Imagine 将长、短期的预测拼接成一条序列。当模型在第 步通过长期分支“瞬移”到了目标附近,它会使用一个改进的 -returns 公式: 这里的 是跳跃的时间步长。这种设计直接将长程的预期价值通过折扣因子反馈给当前的动作,让 Agent 在第一步就知道:那棵树虽然远,但跳过去收益巨大!
4. 实验战果:MineDojo 上的全面碾压
LS-Imagine 在 MineDojo 环境下的 5 项挑战性任务中表现卓越。
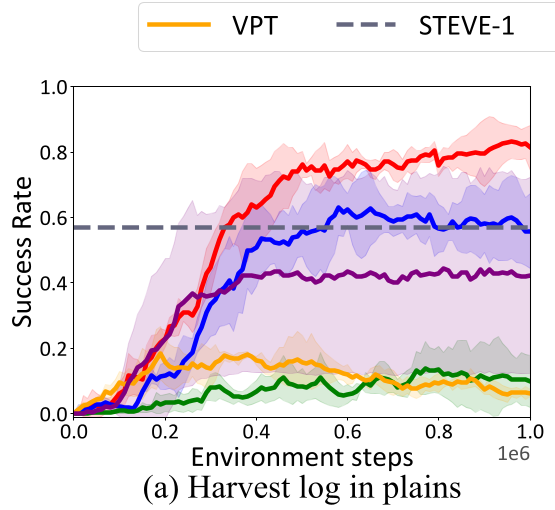
- 效率与成功率双增:在“采木”和“取水”任务中,LS-Imagine 的成功率分别达到了 80.6% 和 77.3%,而传统的 DreamerV3 仅在 50% 左右波动。
- 更短的路径:由于学会了长程规划,Agent 不再像没头苍蝇一样乱转,完成任务的平均步数减少了约 30%。
此外,消融实验(Ablation Study)显示,即便在目标被完全遮挡(Occluded)的情况下,依托于 MineCLIP 预训练的 Affordance Map 依然能提供有效的探索指引,这种强大的泛化能力是其成功的关键。
5. 总结与反思
LS-Imagine 的价值在于它打破了 Transformer 和 RNN 在世界模型中由于序列长度限制带来的“时空近视”。 通过将连续的时间轴离散化为“关键节点”的跳跃,它在保持计算低开销的同时,获得了远超前人的认知深度。
局限性: 目前的跳跃逻辑很大程度上依赖于目标在视觉上的可感知性(通过 Zoom-in 模拟)。对于那些没有明确视觉目标、需要更抽象逻辑推理的任务(如“合成一个复杂的工具”),它仍需要结合层级化规划(如 DECKARD)来协同工作。
这意味着,未来的开发世界 Agent 可能不仅需要会“跳跃”的想象力,更需要一套能处理多级抽象的“思维大树”。