
LS-Imagine:打破“近视”限制,让强化学习智能体拥有长远眼光
Open-World Reinforcement Learning over Long Short-Term Imagination
本文提出了 LS-Imagine,一种用于高维开放世界任务的视觉增强模型基强化学习(MBRL)框架。该方法通过引入“长短期想象”机制,利用目标条件跳跃式状态转移(Jumpy State Transitions)和能力图(Affordance Maps),显著提升了智能体在《我的世界》(Minecraft)复杂任务中的采样效率和长线决策能力。
TL;DR
在开放世界(如 Minecraft)中,传统的模型基强化学习(MBRL)智能体常常因为只能看到“眼前的 15 步”而陷入局部探索的泥潭。上海交通大学等机构的研究者提出了 LS-Imagine,通过长短期世界模型和跳跃式状态转移(Jumpy State Transitions),使智能体能够在虚幻的“想象”中直接跨越时空阻碍,提前感知远方目标带来的长远收益,显著提升了在复杂开放场景下的任务成功率。
背景定位:开放世界的“近视”困境
目前的视觉控制智能体(如 DreamerV3)主要依赖世界模型生成的短片段进行策略更新。但在《我的世界》这种地图广阔、奖励稀疏的环境中,目标可能在数百步之外。仅靠短程想象,智能体就像在浓雾中摸索,很难建立起当前动作与长远目标之间的逻辑链路。
核心直觉:如果“想象”可以跳跃?
作者提出了一个极具物理直觉的方案:当智能体在视野中捕捉到远处的树木(目标)时,为什么不直接“瞬移”过去想象成功后的状态?
为了实现这一目标,LS-Imagine 解决了三个关键问题:
- 如何定义“感兴趣”的区域? 使用 Affordance Map(能力图)标记图像中与任务(如“砍树”)强相关的区域。
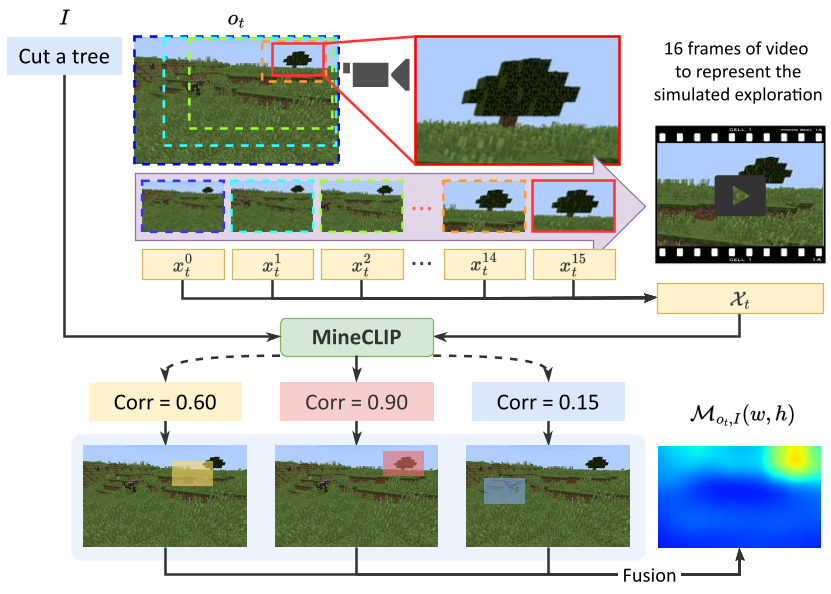
- 如何在没有数据时训练跳跃模型? 通过对单张图像进行 Zoom-in(缩放) 模拟靠近目标的视觉过程,生成“伪视频”来微调模型。
- 如何融合长短期预测? 在潜空间中引入 Jumping Flag,动态决定当前该进行单步推演还是长程跳跃。
方法论详解:长短期世界模型架构
LS-Imagine 的核心是对传统 RSSM(循环状态空间模型)的改造。它包含两个分支:
- 短期分支 (Short-term):负责单步的状态转移推演。
- 长期分支 (Long-term):通过 Interval Predictor(间隔预测器) 预测从当前位置跳跃到目标处所需的步数 以及期间累积的奖励 。
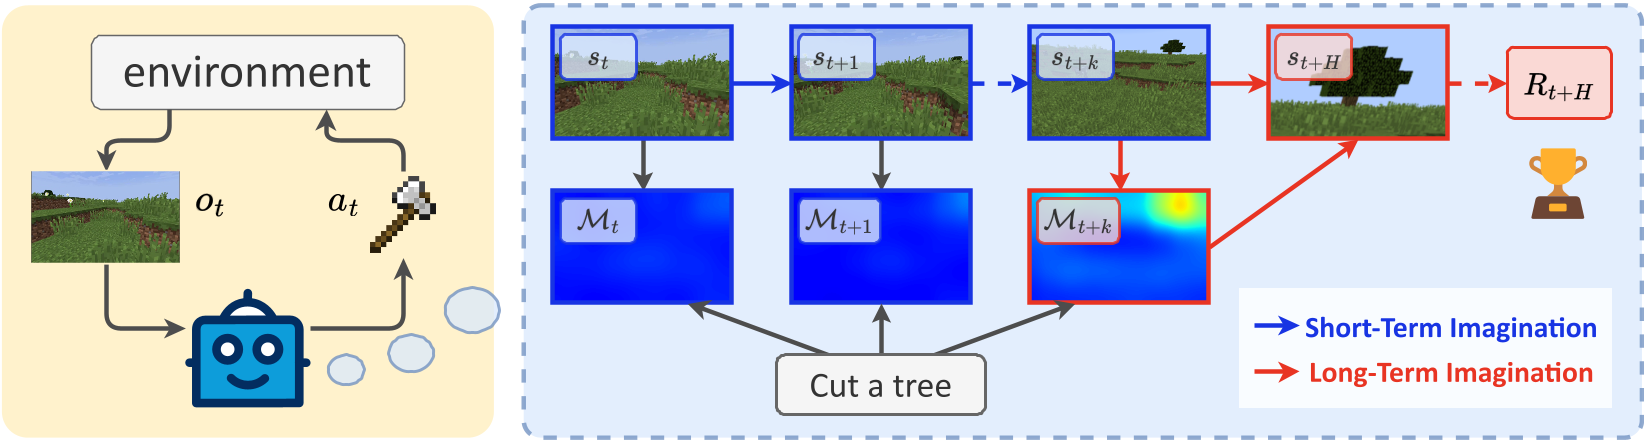 图 1:LS-Imagine 框架。智能体在观测到目标后,通过跳跃转移直接进入远期潜状态,优化 Actor-Critic。
虚拟探索:基于缩放的能力图生成
为了生成高质量的能力图,作者利用了 MineCLIP 的跨模态匹配能力。通过在一个 64x64 的图像上滑动窗口并不断放大,模拟智能体走近目标的感官变化,并以此计算内在奖励(Intrinsic Reward)。
实验结果:全方位的跨越
在 MineDojo 的五项典型挑战(砍树、取水、挖沙、剪羊毛、采矿)中,LS-Imagine 展示了统治级的表现。
- 效率提升:完成任务所需的平均环境步数大幅下降。
- 成功率:在大多数任务中比 DreamerV3 提效 50% 以上。
- 视觉证据:通过解码潜状态,我们可以清晰地看到模型在“想象”中准确地预判了靠近目标后的视觉细节。
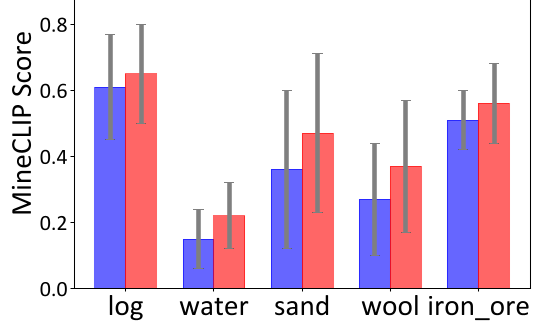 图 2:LS-Imagine 与各基线模型在成功率上的对比(右下角为 MineCLIP 奖励值对比)。
深度洞察:为什么串联想象(Series)比并联好?
论文探讨了一个有趣的细节:是应该在一个序列中混合长短期想象(串联),还是分别生成短序列和跳转序列(并联)?实验发现串联模式远优于并联。这是因为串联允许跳转后的状态梯度回传给跳转前的动作,实现了真正的“前瞻性”指导,而并联模式下不同序列间缺乏价值流转。
总结与局限性
LS-Imagine 为处理开放世界中的长程视觉任务提供了一个优雅的方案。它通过“Zoom-in”这种简单的几何直觉解决了数据稀疏下的跳跃模型训练问题。
局限性:
- 目前主要依赖视觉缩放,对于非导航类(如需要复杂工具链合成)的任务,其跳跃逻辑可能需要更强的分层规划能力。
- 计算开销较大,实时训练需要较高性能的 GPU 支持。
对于未来的视觉 AI 智能体,这种“既能脚踏实地,又能仰望星空”的想象机制,或许是通往通用人工智能(AGI)的关键一步。