
OpenClaw-RL:让 Agent 在交互中进化,通过“对话”完成模型训练
OpenClaw-RL: Train Any Agent Simply by Talking
本文提出了 OpenClaw-RL,一个支持在线学习的智能体(Agent)强化学习框架。该框架通过 server-client 架构从用户交互、终端反馈及 GUI 状态变化中提取“评估性”与“指令性”信号,实现了 Personal Agents(个人助理)和 General Agents(通用智能体)在统一架构下的持续进化。
TL;DR
传统的 LLM 训练往往停留在离线阶段,而 OpenClaw-RL 开启了“边用边学”的新范式。它通过捕捉用户反馈(如“不对,请先检查文件”)或环境状态变化,将其转化为强化学习的监督信号。通过创新的重叠引导 Hint 选择机制,它解决了在线学习中极易出现的训练崩溃问题。
核心背景:Agent 信号的“浪费”
当前的 Agent 系统中,每一次用户重查(Re-query)、每一次工具报错、每一次 GUI 的状态迁移,其实都隐含了对模型当前行为的评价。然而,现有的工作(如传统的 RLHF)通常需要收集成批的数据后离线训练。OpenClaw-RL 填补了这一空白:它把 Agent 部署后的每一条交互流变成了实时的训练源。
架构解析:四路异步的“Slime”基础设施
OpenClaw-RL 基于高性能的 slime 框架,其最大的特点在于完全解耦。
- Inference API: 负责推理,不阻塞用户需求。
- Environment Server: 托管各种环境(终端、浏览器等)。
- PRM / Judge: 异步评分并从下一状态中提取“Hint”。
- Megatron-LM: 后台悄悄进行梯度更新。
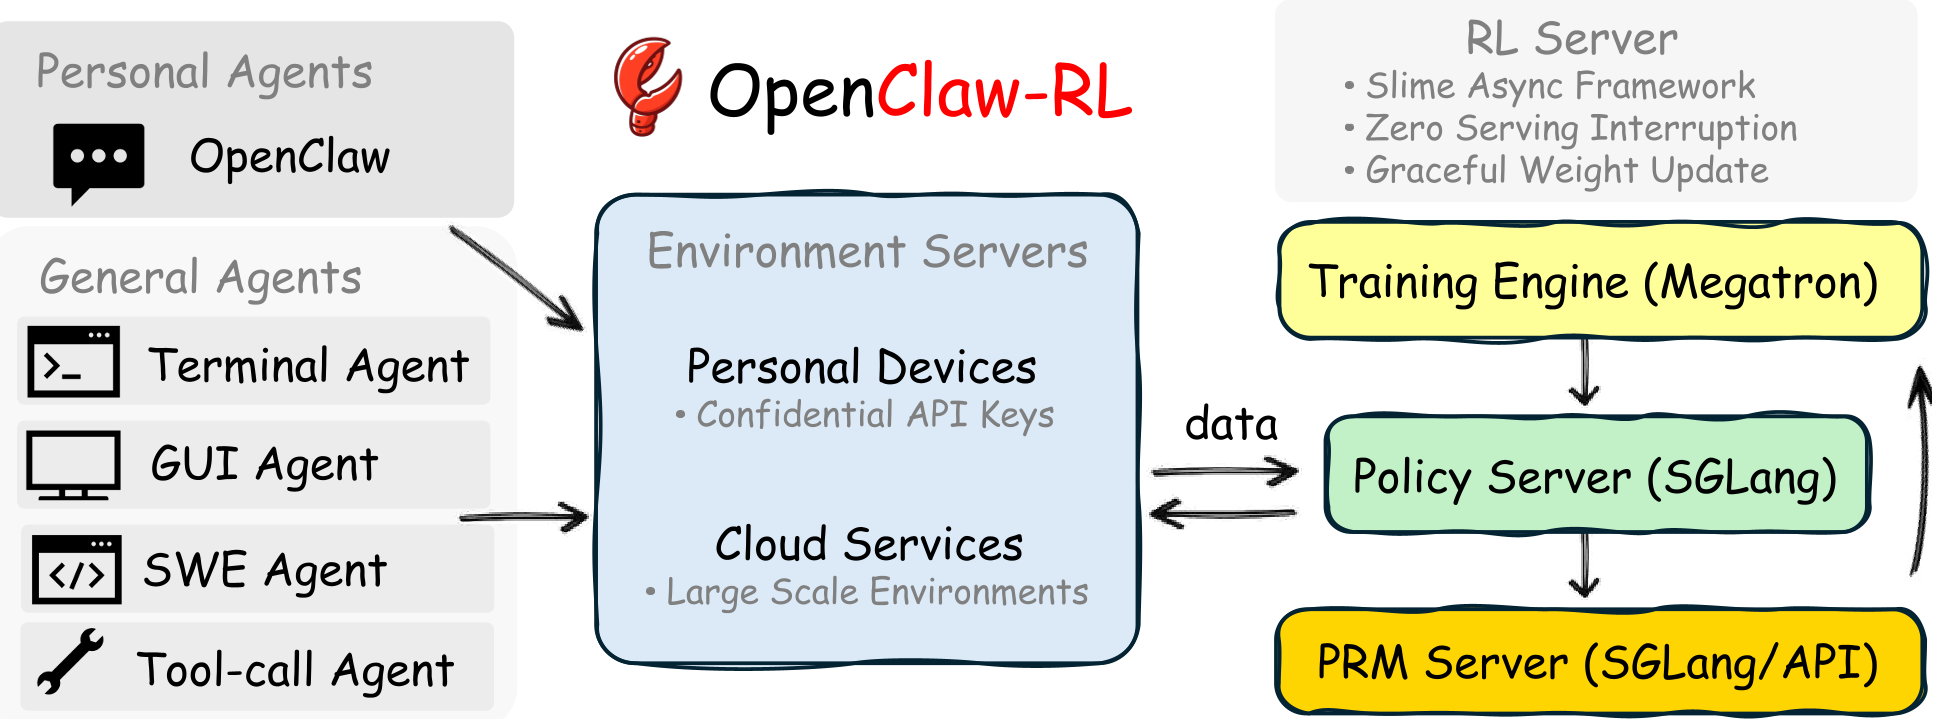 图 1: OpenClaw-RL 基础设施概览。左侧为个人助理,右侧为云端并行环境。
算法灵魂:如何让在线学习不再“炸车”?
在线学习最怕 Teacher(带 Hint 的模型)与 Student(基础模型)认知差太大。如果 Teacher 给出的建议在 Student 看来是“天外来客”,梯度就会剧烈波动。
1. 混合 RL 目标 (Hybrid RL Objective)
作者提出将**评估信号(Evaluative)和指令信号(Directive)**结合。
- Evaluative: 每个动作都有分(对/错),类似传统的奖励模型。
- Directive: 只有当下一状态包含修正信息时(如用户纠错),才生成 Token 级的 Hint。
- 公式直觉: 。
2. 重叠引导的 Hint 选择 (Overlap-Guided Hint Selection)
这是本文最具学术深度的地方。系统会生成多个候选 Hint,计算 Teacher 的 Top-k 分布与 Student 分布的交集(Overlap)。选择那个“最能让 Student 听懂”的 Hint。这确保了在蒸馏过程中,重要性采样比率(Importance Ratio)接近 1。
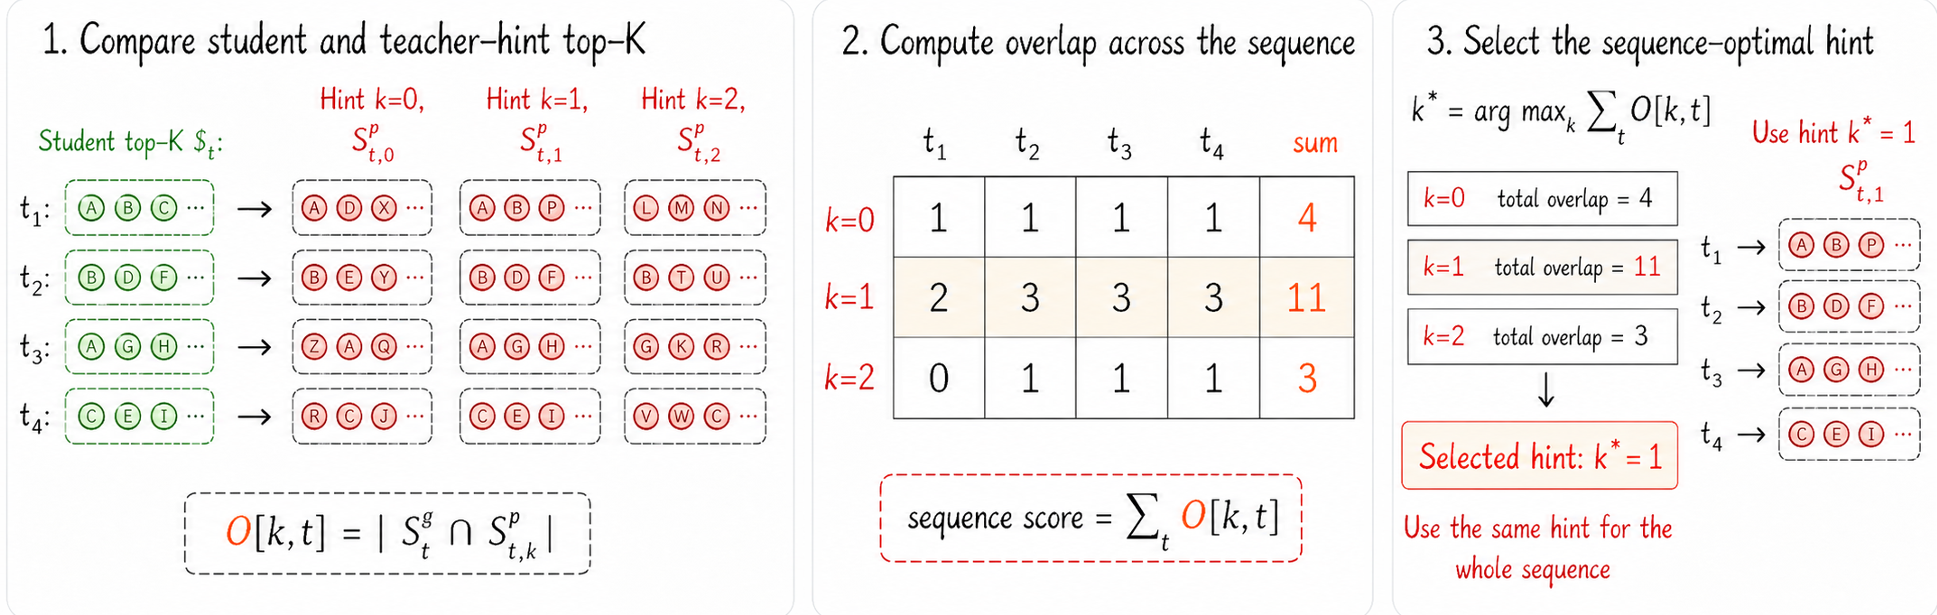 图 2: 通过最大化 Top-k Token 交集来选择最稳定的 Hint。
实验战绩:全场景 Agent 的大统一
OpenClaw-RL 是首个在单一系统中统一了**终端(Terminal)、图形界面(GUI)、软件工程(SWE)和工具调用(Tool-call)**四类 Agent 的开源框架。
关键结果对比
在针对 Student、TA 和 Teacher 三种不同人设的个性化实验中,OpenClaw-RL 的对齐效率显著高于单纯的记忆系统(Mem0)和技能进化方法(Cognee)。
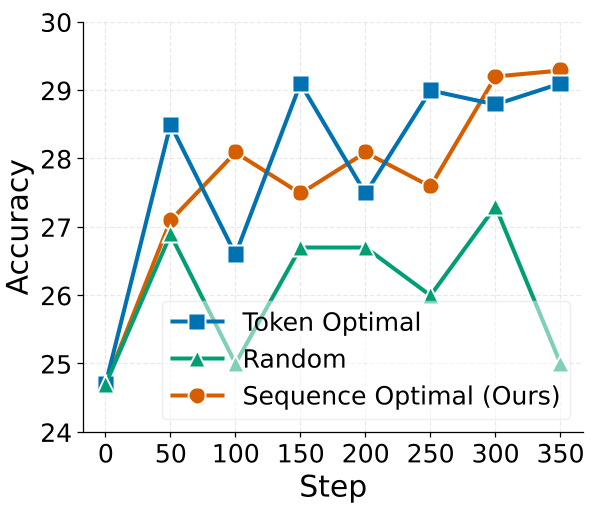 图 3: 在 ReTool 和 RLVR 任务中,Hybrid RL 的收敛精度均高于 Outcome-only 基线。
深度洞察与总结
OpenClaw-RL 的价值不仅在于刷榜,而在于它提供了一种闭环化 (Close-loop) 的 Agent 进化方案。
- 优点: 极大地降低了数据获取成本。每一位使用 Agent 的用户都在无意识中充当了标注员。
- 局限性: 文末也客观提到,如果用户恶意修正或给出对抗性指令,模型可能会“学坏”。如何过滤这些毒素是未来的关键。
- 启示: 对产业界而言,这意味着未来我们可以为每个员工/用户训练一个专属的、能够随着交流深入越来越懂你的个性化 Agent。
学术定位:本工作属于 LLM 在线强化学习与 Agent 系统的交叉前沿,在 DeepSeek-R1 式的 GRPO 奖励机制基础上,引入了更细粒度的 Hint 蒸馏,是构建实时进化 Agent 的重要基石。