
OPENFORGE RL:打破藩篱,在真实推理框架中锻造最强 Agent
OpenForgeRL: Train Harness-native Agents in Any Environment
本文推出了 OPENFORGE RL,一个用于端到端训练基于推理框架(Harness)之 AI Agent 的开源框架。通过轻量级代理和 Kubernetes 编排,它支持在任何真实部署环境(如 GUI 浏览器、桌面计算机、复杂工具链)中进行大规模 RL 训练,使 3B/8B 规模模型在多个基准测试上达到或超越更大规模的 SOTA 模型。
TL;DR
传统的 AI Agent 训练往往在简化的“实验室环境”中进行,导致模型在面对复杂的真实推理框架(Harness)时表现不佳。OPENFORGE RL 彻底打破了这一局限,它通过解耦训练逻辑与环境推理,允许开发者直接在 Claude Code、OpenClaw 等真实的生产级 Harness 中进行端到端的强化学习(RL)。结果令人振奋:仅需几千个样本,8B 规模的模型就能在 GUI 操作任务上硬刚甚至超越闭源巨头。
痛点深挖:消失的“状态”与训练失真
在 Agent 领域,Harness(推理框架)已经成为了垂直能力的核心。Harness 负责管理多轮对话、嵌套工具调用、子 Agent 协同以及冗长的上下文。然而,目前的开源 RL 框架(如 veRL, DeepSpeed-VisualChat)大多假设 Rollout 是单轮或简单的交互。
当研究者试图训练 Agent 时,通常不得不:
- 阉割 Harness:编写简化的模拟逻辑,导致“训练-部署不匹配(Mismatch)”。
- 算力受限:复杂的环境(如需要渲染界面的桌面 OS)无法在训练节点上大规模并行运行。
这导致开源社区的 Agent 始终被锁在“实验室”里,难以触及闭源前沿模型的工程深度。
Methodology:OPENFORGE RL 的解耦之道
OPENFORGE RL 的核心直觉是:不要试图把环境塞进迭代器,而是把迭代器挂在环境里。
1. 模型即代理 (Lightweight Proxy)
如图 2 所示,OPENFORGE RL 引入了一个 Proxy。对于 Harness 来说,它以为自己在调用普通的推理 API(如 OpenAI API),但实际上 Proxy 拦截了这些调用,将其路由到后台的 RL 推理引擎,并无感地记录下所有 (s, a, r) 轨迹。这种设计让任何复杂的 Harness 都能“原生”参与训练。
2. 云端大规模编排
通过 Kubernetes 编排器(Orchard Env),每一个 Rollout 任务都被封装在独立的容器中,运行在云端节点上。这样即使是极度消耗 CPU/内存的 GUI 环境,也能通过横向扩展实现上千路并行采样。
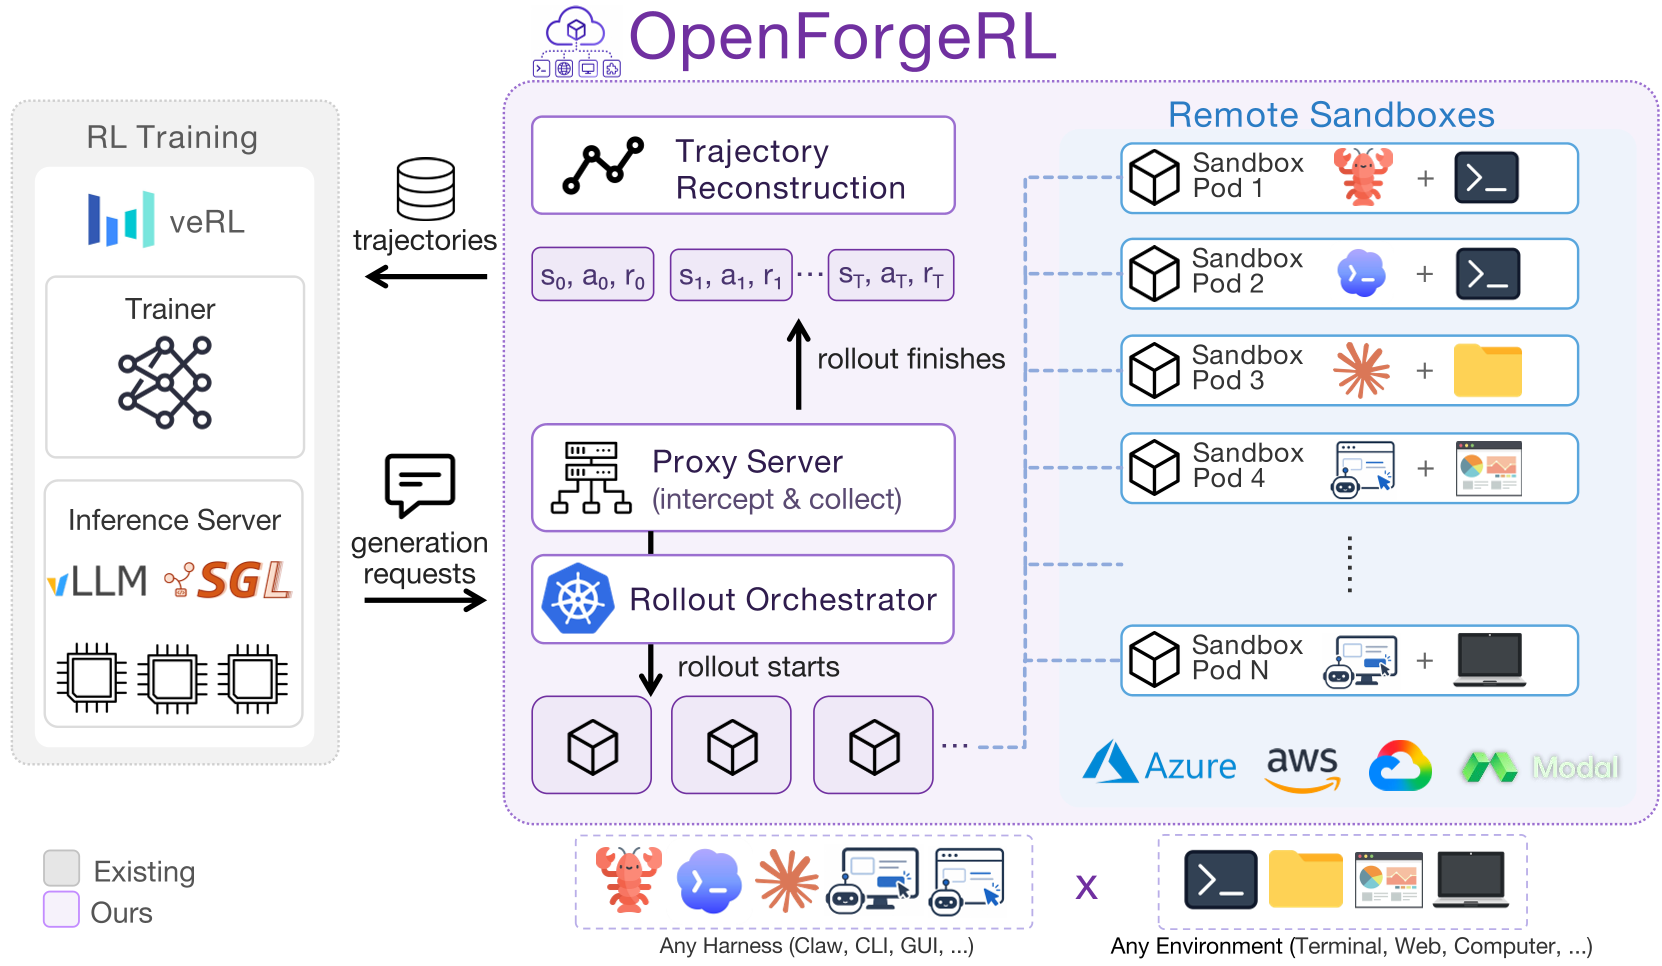 图 2:OPENFORGE RL 架构概览,展示了如何通过 Proxy 连接 Harness 与 RL 后端
实验与结果:小模型也能有大作为
论文在两个核心领域验证了其价值:指令工具调用 (Claw) 和视觉 GUI 控制。
- Claw 任务:针对日常工具操作(邮件、工单更新等),OpenForge-Claw (30B-MoE / 3B Active) 展现了恐怖的鲁棒性。
- GUI 任务:在 OSWorld-Verified 和 WebVoyager 基准上,8B 模型通过 RL 训练后,表现超过了经过 20 万任务训练的 MolmoWeb。
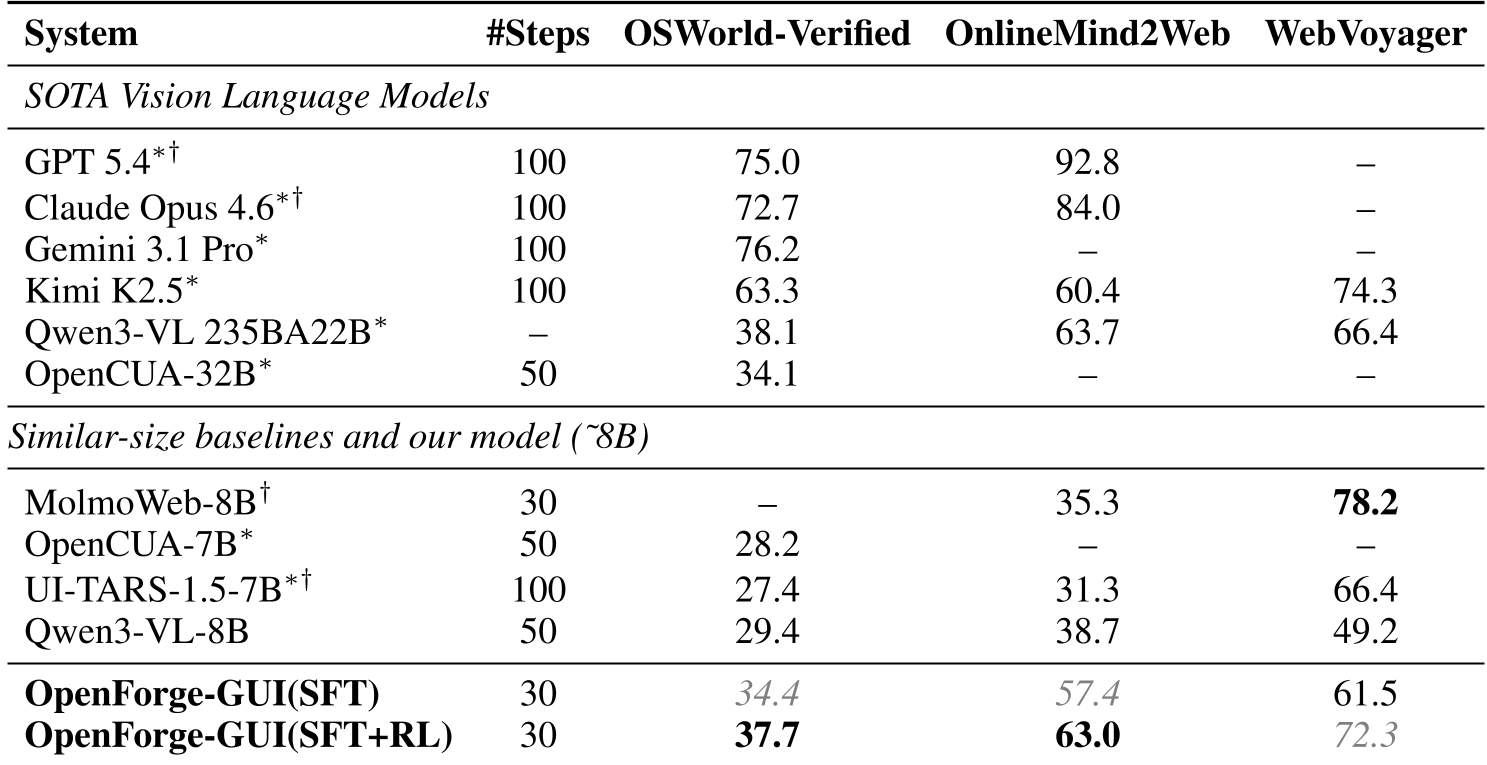 表 3:GUI 代理性能对比,OpenForge-GUI 在多项基准中达到 SOTA
深度洞察:RL 到底教会了 Agent 什么?
通过对 SFT 和 RL 检查点的消融对比(Ablation Study),作者发现 RL 的真正价值不在于“记住”轨迹,而在于:
- 工具覆盖率提高:Agent 学会了在复杂计划中调用所有必需的子服务。
- 自我验证 (Self-verification):Agent 在执行写操作后,会有意识地调用读操作来确认状态改变。
- 走出通用 Shell 的“舒适区”:RL 减少了 Agent 对万能壳(Shell)的依赖,引导其使用更精确的 API 工具。
总结与局限性
OPENFORGE RL 的贡献不仅是一套工具链,它更是对 Agent 训练范式的一次纠偏。它告诉我们:训练 Agent 的最好方式不是模拟其行为,而是模拟其生存的环境。
当然,目前的框架仍有改进空间,例如在面对网络波动、容器超时等非模型异常时的错误处理(Credit Assignment)还比较初级。此外,尽管 RL 提升了可靠性,但在“错误恢复(Error Recovery)”这一极其复杂的能力上,纯粹的 RL 依然显得力不从心,这可能需要更具针对性的数据增强。
Takeaway:未来的 Agent 研发将不再是模型之争,而是 Harness 与环境闭环训练效率之争。OPENFORGE RL 为普通研究者打开了通往这条道路的大门。