
[ICLR 2025] OPENRESEARCHER:构建全开源深度研究智能体的“轨迹工厂”
OpenResearcher: A Fully Open Pipeline for Long-Horizon Deep Research Trajectory Synthesis
本文提出 OPENRESEARCHER,这是一个全开源的深度研究轨迹合成框架。该框架通过解耦离线语料库构建与多轮轨迹合成,利用 GPT-OSS-120B 作为教师模型,在包含 1500 万文档的离线环境中合成了超过 9.7 万条长步数(Long-horizon)研究轨迹,显著提升了开源模型在复杂搜素和推理任务中的表现。
TL;DR
针对当前大模型在处理复杂、长路径(Long-horizon)科研任务时依赖昂贵且不可控的在线 API 问题,来自滑铁卢大学、德州 A&M 等机构的研究者推出了 OPENRESEARCHER。它通过构建一个包含 1500 万文档的离线“小型互联网”,并引入 Search(搜索)、Open(打开)、Find(查找)三项浏览器原语,成功训练出了能自主进行上百步搜索推理的开源智能体,性能甚至在多个指标上超越了 GPT-4.1。
背景定位:从“搜索引擎”到“深度研究者”
DeepSeek-R1 的爆火验证了推理模型(LRMs)在逻辑链条上的潜力,但**深度研究(Deep Research)**不仅仅是逻辑推理,它更是一种复杂的交互行为。
- Prior Work 的局限:现有的智能体(如 Search-R1)通常只有 2-5 轮的搜索,更像是单次检索。
- 成本与复现困境:依赖 Google 或 Bing API 采集数据,每条失败的轨迹都在烧钱,且网页内容实时变化,实验完全不可复现。
核心直觉:模拟人类浏览的“三部曲”
OPENRESEARCHER 的作者认为,深度研究必须模拟人类真实的上网习惯,而不是简单的关键词匹配。为此他们提出了三个 Minimal Primitives:
- Search:全局搜索,获取候选源。
- Open:点击详情,阅读全文。
- Find:页面内定位,寻找特定实体或短语。
这种设计强迫模型学习如何从大规模语料库中逐渐收窄焦点,从“大海捞针”变为“精准手术”。
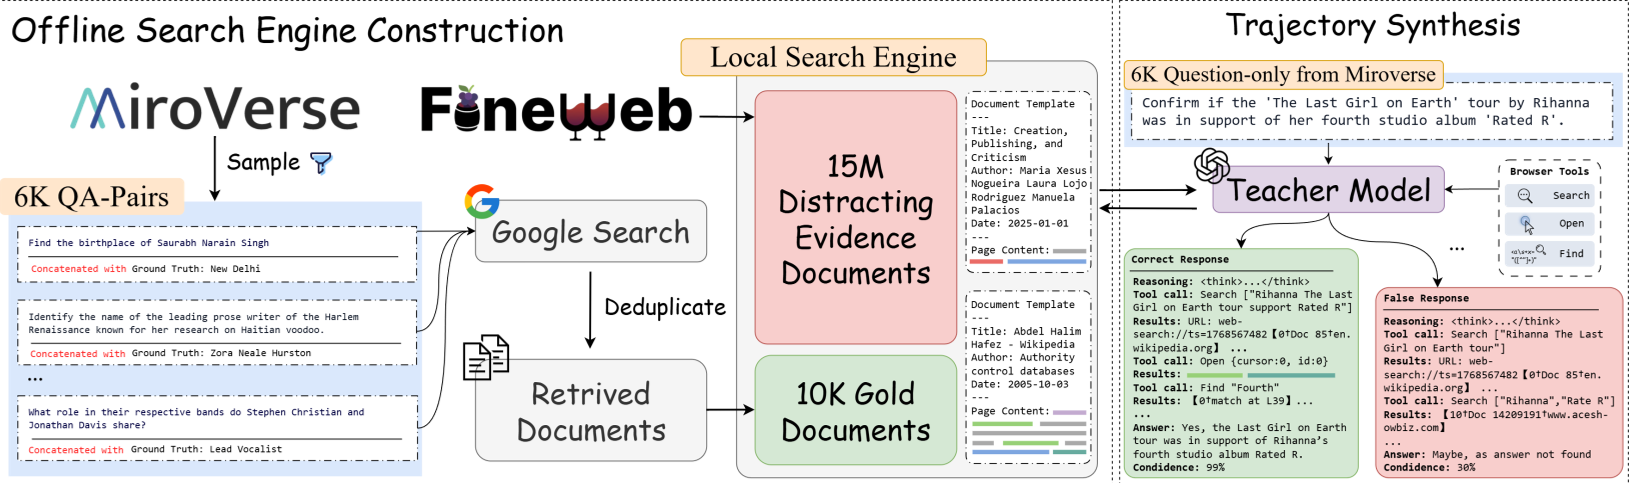 图 1:OPENRESEARCHER 的轨迹合成全流程。从问题采集、语料库构建到教师模型交互合成。
离线环境:低成本与确定性的博弈
为了解决成本方案,作者机智地将“一次性在线采集”与“大规模离线生成”解耦。
- Bootstrapping:针对精选的 6000 个复杂问题,先用在线 API 抓取一波包含正确答案的“金标准文档”。
- Distractors:将这些文档混入 1500 万篇 FineWeb 网页中,形成一个充满噪音、真实的搜索池。
- 结果:在这个闭环环境里,教师模型(GPT-OSS-120B)可以不受速率限制、不花一分钱地尝试各种路径,合成了 9.7 万条高质量轨迹。
实验战绩:开源模型对商业巨头的逆袭
通过对 30B 规模的混血架构(Mamba-Transformer)模型进行 SFT 训练,OPENRESEARCHER 展示了令人惊讶的战斗力。
| 模型 | BrowseComp-Plus (闭环测试) | GAIA (在线测试) |
|---|---|---|
| OPENRESEARCHER-30B | 54.8% | 64.1% |
| GPT-4.1 | 36.4% | - |
| Claude-4-Opus | 36.8% | - |
| DeepSeek-R1 | 16.4% | 30.3% |
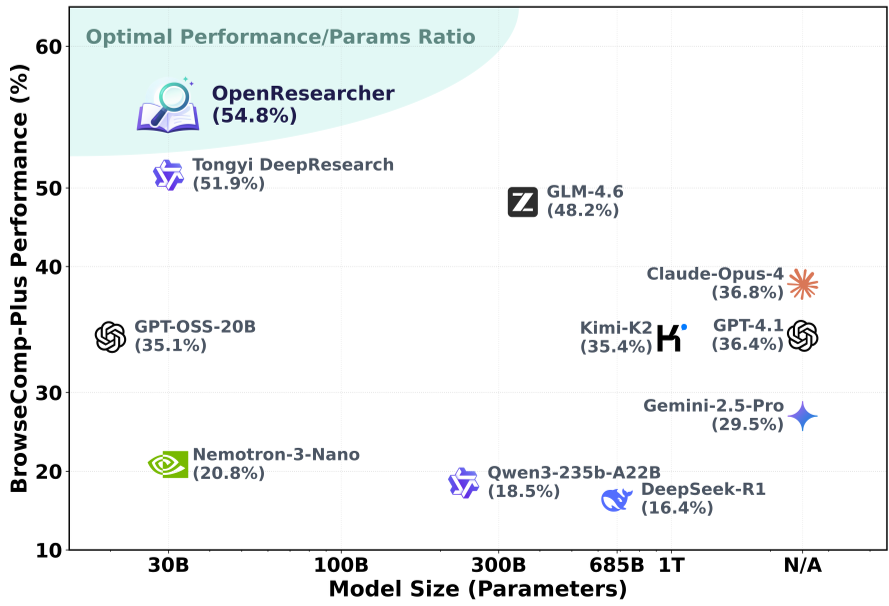 图 2:在 BrowseComp-Plus 上的性能飞跃,显示了专用轨迹训练的威力。
深度洞察:为什么有的搜索会失败?
通过对 9.7 万条轨迹的消融研究,作者揭示了几个反直觉的结论:
- 步数越多不一定越好:失败的轨迹平均步数(71.7 步)反而是成功轨迹(38.4 步)的近两倍。这说明失败往往源于“搜索漂移”和无效循环,而非探索不足。
- 找到不等于答对:即便模型在搜索结果中看到了金标准文档(Search-hit),其最终答对的概率也仅为 61.8%;只有当模型显式执行了
Open动作进入页面后,胜率才飙升至 86.7%。这再次证明了深入阅读的必要性。
局限性与未来
尽管该框架非常出色,但目前仍存在对静态语料库的依赖。如果任务涉及极具时效性的新闻,离线语料库就捉襟见肘了。未来,如何动态更新这个“离线互联网”而不过度增加成本,将是下一个课题。
总结
OPENRESEARCHER 为学术界提供了一套完整的“深研智能体”生产线。它告诉我们:不需要无限的 API 经(金)费,通过巧妙的离线环境设计和精细的动作原语建模,开源模型同样可以拥有专业研究员级别的深度探索能力。
本文由 AIGC 辅助生成,关键见解基于原文数据分析。